Wykład 4: Wysoka dostępność (High Availability), STP i agregacja łączy

1/26

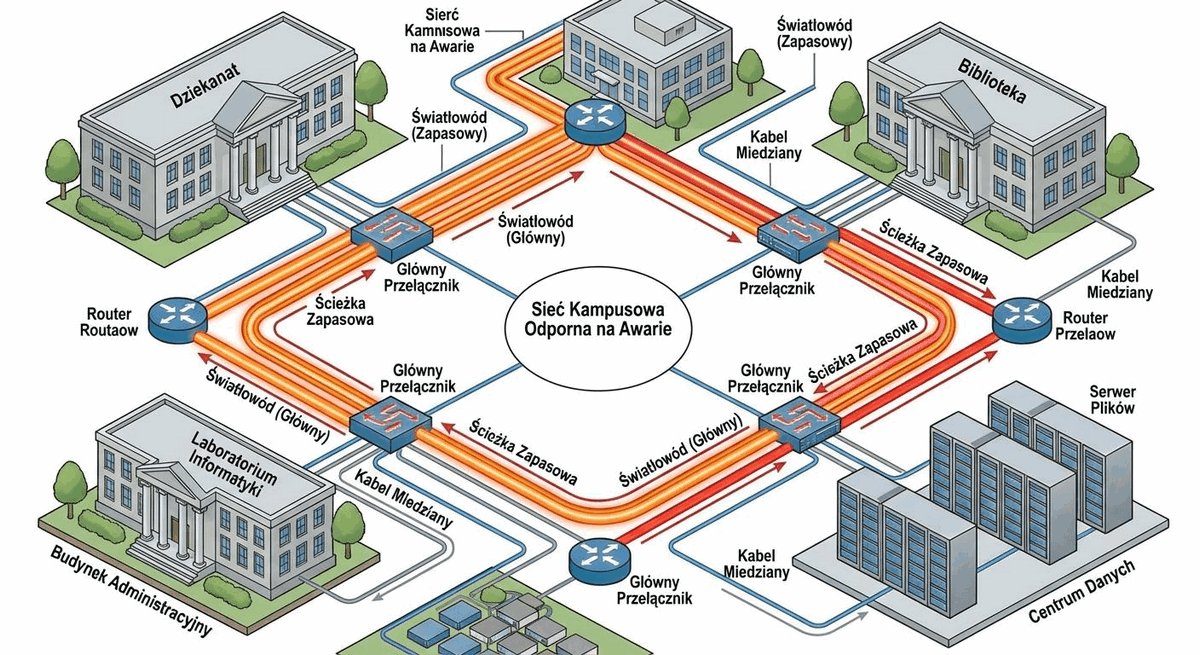
Wysoka dostępność (HA) i redundancja w sieci kampusowej

Przedstawienie inżynierskich zasad projektowania sieci kampusowych o wysokiej dostępności i eliminacji pojedynczych punktów awarii.

Wykład 4: Architektura odporna na awarie

  • Zakres wykładu: metodyka projektowania systemów High Availability (HA), metryki niezawodnościowe oraz wielowarstwowe mechanizmy redundancji.
  • Ochrona warstwy łącza: protokoły drzewa rozpinającego STP/RSTP/MSTP oraz dynamiczna agregacja połączeń LACP.
  • Wymagania ciągłości działania: procedury projektowe eliminujące pojedyncze punkty awarii (SPOF) i gwarantujące ciągłość usług.
Wysoka dostępność (High Availability, HA) to właściwość systemu teleinformatycznego gwarantująca ciągłość świadczenia usług sieciowych na zdefiniowanym poziomie jakości pomimo wystąpienia awarii pojedynczych komponentów sprzętowych lub programowych. Osiąga się ją poprzez celowe dublowanie zasobów oraz automatyzację procesów przełączania awaryjnego.
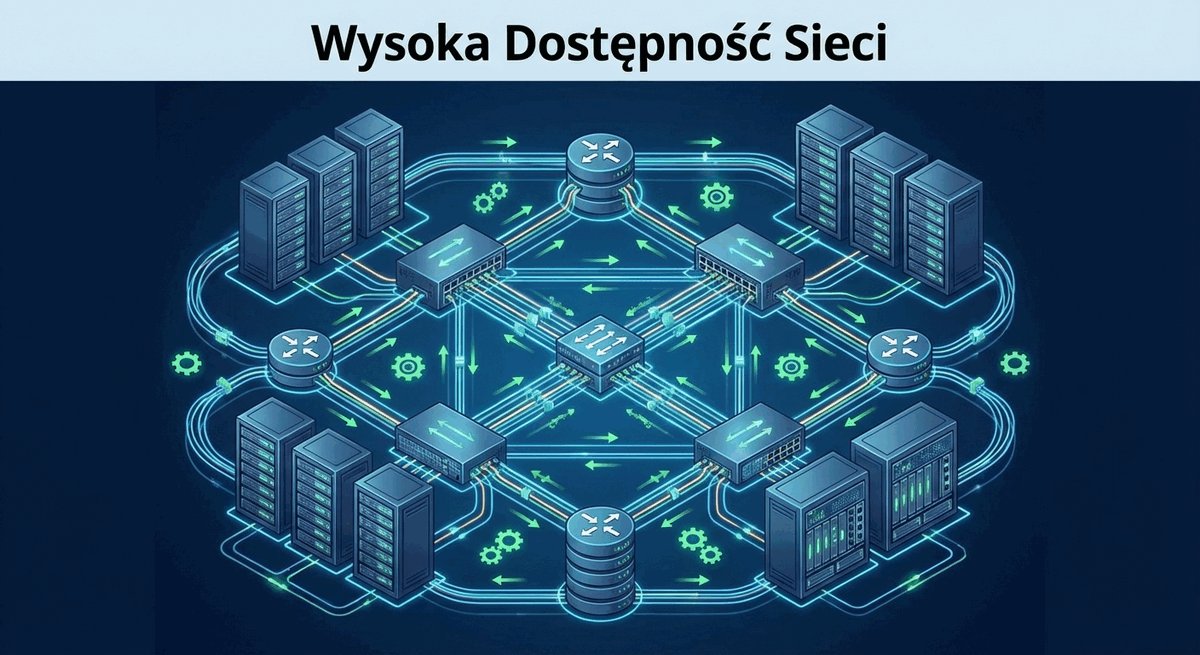
Wysoka dostępność i redundancja w architekturze sieci kampusowej

Projektowanie architektury wysokiej dostępności wymaga całościowego spojrzenia na infrastrukturę teleinformatyczną. Obejmuje ono nie tylko redundancję logiczną protokołów sieciowych, ale także zdublowane tory zasilania gwarantowanego (UPS/agregaty), redundantne systemy klimatyzacji precyzyjnej w punktach dystrybucyjnych oraz fizycznie rozdzielone trasy kablowe.

Współczesne organizacje opierają kluczowe procesy biznesowe i edukacyjne na sieci IP, co sprawia, że nawet kilkuminutowy przestój generuje dotkliwe straty finansowe i wizerunkowe. Celem inżyniera sieciowego jest redukcja czasu przełączenia awaryjnego (Failover Time) do wartości subsekundowych.

Skróty użyte w tym slajdzie:
HA - High Availability, zespół technologii gwarantujących ciągłą pracę infrastruktury teleinformatycznej.
SLA - Service Level Agreement, formalna umowa określająca gwarantowane parametry dostępności i jakości usług.
UPS - Uninterruptible Power Supply, zasilacz awaryjny podtrzymujący pracę urządzeń sieciowych.
IEEE - Institute of Electrical and Electronics Engineers, organizacja rozwijająca międzynarodowe standardy sieciowe.

2/26

Agenda dzisiejszego wykładu

Przedstawienie harmonogramu wykładu poświęconego zagadnieniom dostępności, protokołom drzewa rozpinającego oraz agregacji łączy.

Plan spotkania

  • Podstawy teoretyczne: definicja wysokiej dostępności, klasyfikacja współczynników dostępności oraz eliminacja punktów SPOF.
  • Protokoły drzewa rozpinającego: geneza pętli warstwy 2, algorytm STP, ewolucja do Rapid-PVST+ oraz standardu MSTP (IEEE 802.1Q).
  • Agregacja łączy i podsumowanie: protokół LACP (IEEE 802.1AX), algorytmy haszowania ruchu oraz dobre praktyki projektowe.
Plan wykładu wyznacza logiczną ścieżkę analizy niezawodnościowej: od matematycznych wskaźników dostępności, poprzez fizyczne mechanizmy redundancji, aż po protokoły dynamicznego zarządzania topologią sieci. Pozwala studentom zrozumieć współzależności pomiędzy poszczególnymi mechanizmami warstwy 2 i 3.
Plan wykładu o wysokiej dostępności i redundancji

Struktura wykładu prowadzi od ogólnych założeń inżynierskich do szczegółowych konfiguracji sprzętowych. Rozpoczynamy od zdefiniowania pojedynczych punktów awarii (SPOF) i omówienia matematycznych modeli wyliczania dostępności systemów szeregowych i równoległych.

W dalszej części przechodzimy do technicznego sedna: dlaczego redundancja w warstwie 2 stwarza ryzyko pętli przełączania i jak protokoły STP, RSTP i LACP pozwalają na bezpieczne wykorzystanie zdublowanych połączeń kablowych.

Skróty użyte w tym slajdzie:
SPOF - Single Point of Failure, pojedynczy element infrastruktury, którego awaria paraliżuje cały system.
STP - Spanning Tree Protocol, protokół blokujący pętle w topologiach ethernetowych.
RSTP - Rapid Spanning Tree Protocol, protokół szybkiego drzewa rozpinającego.
LACP - Link Aggregation Control Protocol, protokół sterujący automatycznym łączeniem fizycznych portów.

3/26

Czym jest wysoka dostępność (High Availability)?

Przedstawienie definicji i podstawowych pojęć inżynierii niezawodności w odniesieniu do systemów teleinformatycznych.

Podstawy inżynierii niezawodności

  • Ciągłość operacyjna: zdolność systemu do nieprzerwanego świadczenia usług teleinformatycznych w założonym reżimie czasowym.
  • Odporność na usterki (Fault Tolerance): natychmiastowe przejęcie obciążenia przez komponent zapasowy bez degradacji jakości sesji użytkownika.
  • Ocena ryzyka: systematyczna identyfikacja słabych punktów architektury i analiza skutków ewentualnych awarii urządzeń.
Odporność na awarie (Fault Tolerance) to zdolność systemu sieciowego do bezprzerwowej pracy pomimo wystąpienia uszkodzenia jednego z komponentów. W odróżnieniu od zwykłego odzyskiwania po awarii, tolerancja na uszkodzenia nie dopuszcza do zerwania aktywnych sesji transmisyjnych użytkowników.
Podstawy inżynierii niezawodności i wysoka dostępność

W inżynierii sieciowej wysoka dostępność nie jest cechą binarną (jest lub jej nie ma), lecz parametrem mierzalnym. Wymaga zdefiniowania dopuszczalnego czasu przestoju (Downtime) oraz czasu konwergencji sieci po wystąpieniu incydentu sprzętowego.

Prawidłowe wdrożenie HA opiera się na trzech filarach: redundancji sprzętowej (zdublowane procesory, zasilacze, łącza), redundancji logicznej (protokoły STP, FHRP, dynamiczny routing) oraz automatycznym monitoringu stanu sieci (telemetria, SNMP, Syslog) umożliwiającym natychmiastową reakcję serwisu.

Skróty użyte w tym slajdzie:
MTBF - Mean Time Between Failures, średni czas bezawaryjnej pracy urządzenia wyrażony w godzinach.
MTTR - Mean Time To Repair, średni czas potrzebny na naprawę lub wymianę uszkodzonego modułu.
SNMP - Simple Network Management Protocol, protokół monitorowania i zarządzania urządzeniami sieciowymi.
FT - Fault Tolerance, właściwość systemu gwarantująca bezprzerwową pracę mimo uszkodzenia elementu.

4/26

Miara dostępności: „dziewiątki”

Przedstawienie matematycznej skali dziewiątek dostępności oraz korelacji z dopuszczalnym rocznym czasem niedostępności usług.

Kwantyfikacja wskaźników dostępności (Availability SLA)

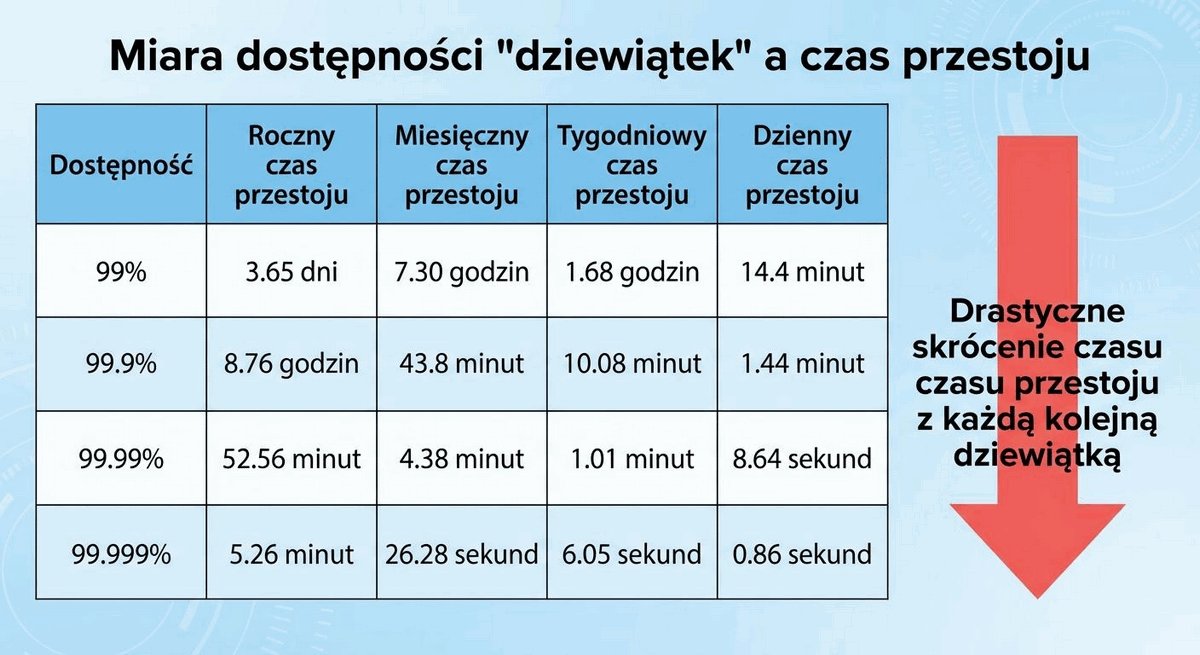
  • Wskaźnik 99% (Dwie dziewiątki): dopuszcza do 3,65 dnia przestoju rocznie, co jest nieakceptowalne dla instytucji uczelnianych i korporacji.
  • Wskaźnik 99,99% (Cztery dziewiątki): dopuszcza maksymalny roczny czas przestoju na poziomie 52,6 minuty, stanowiąc standardowy cel dla sieci kampusowych.
  • Wskaźnik 99,999% (Pięć dziewiątek): reżim operatorski pozwalający na maksymalnie 5,26 minuty niedostępności rocznie w infrastrukturze krytycznej.
Współczynnik dostępności (Availability) to stosunek rzeczywistego czasu prawidłowego funkcjonowania systemu do całkowitego czasu obserwacji, wyrażany procentowo. Jest podstawowym parametrem określanym w umowach SLA, rzutującym na koszty inwestycyjne i wymagany stopień redundancji.
Zestawienie wskaźników dostępności i dopuszczalnego czasu awarii

Wzrost dostępności o każdą kolejną dziewiątkę wiąże się z wykładniczym wzrostem kosztów infrastruktury (CAPEX) oraz nakładów operacyjnych (OPEX). Osiągnięcie pięciu dziewiątek (99,999%) wymaga nie tylko dublowania każdego przełącznika i routera, ale także redundantnego zasilania z dwóch niezależnych GPZ, podwójnych tras światłowodowych wprowadzanych do budynków różnymi duktami oraz całodobowego wsparcia serwisowego z czasem reakcji do 4 godzin.

Dla większości kampusów uniwersyteckich i biurowych standardem docelowym jest dostępność na poziomie czterech dziewiątek (99,99%), co zapewnia optymalny kompromis pomiędzy stabilnością a budżetem inwestycyjnym.

Skróty użyte w tym slajdzie:
GPZ - Główny Punkt Zasilania, stacja transformatorowa wysokiego lub średniego napięcia zasilająca obiekt.
CAPEX - Capital Expenditure, nakłady finansowe ponoszone jednorazowo na zakup infrastruktury.
OPEX - Operational Expenditure, bieżące koszty operacyjne ponoszone na utrzymanie systemów.
SLA - Service Level Agreement, gwarantowany umownie poziom dostępności usług.

5/26

Pojedynczy punkt awarii (SPOF)

Przedstawienie metodyki wykrywania pojedynczych punktów awarii w fizycznej i logicznej strukturze sieci.

Identyfikacja i eliminacja wąskich gardeł niezawodności

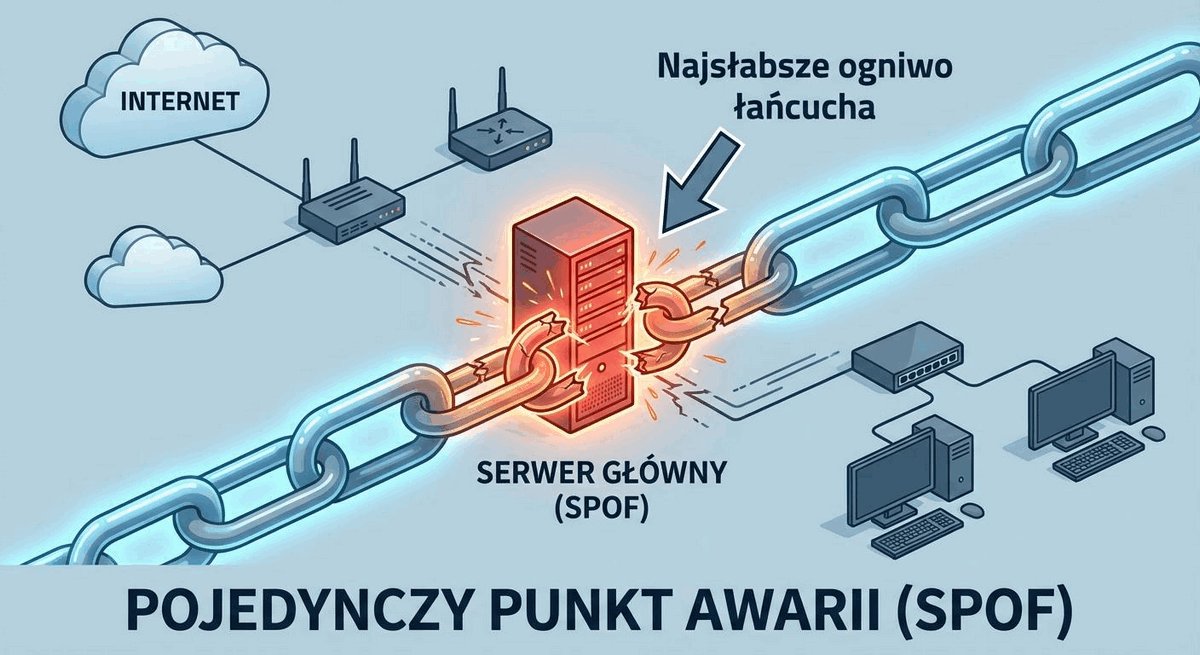
  • Definicja zagrożenia: komponent, którego uszkodzenie prowadzi do natychmiastowego przerwania działania całego systemu lub jego kluczowego segmentu.
  • Typowe punkty SPOF: pojedynczy przełącznik rdzeniowy, pojedyncze łącze dosyłowe, pojedynczy zasilacz lub wspólny trakt kablowy.
  • Zasady audytu: szczegółowa analiza ścieżek przepływu danych pod kątem odporności na awarię każdego elementu pośredniczącego.
Pojedynczy punkt awarii (Single Point of Failure, SPOF) to dowolny element infrastruktury sprzętowej, logicznej lub zasilającej, którego uszkodzenie skutkuje przerwaniem świadczenia usług w całym systemie lub wyodrębnionym segmencie sieci. Eliminacja SPOF jest nadrzędnym celem inżynierii wysokiej dostępności.
Identyfikacja pojedynczego punktu awarii w architekturze sieci

Eliminacja SPOF wymaga wnikliwej analizy wszystkich warstw modelu odniesienia. Częstym błędem początkujących projektantów jest skupienie się wyłącznie na zdublowaniu przełączników, przy jednoczesnym pozostawieniu pojedynczego kabla zasilającego w szafie RACK lub poprowadzeniu dwóch redundantnych wiązek światłowodowych w tym samym fizycznym korycie kablowym.

W przypadku mechanicznego uszkodzenia koryta (np. podczas prac budowlanych) obydwa tory ulegają jednoczesnemu zerwaniu, co ujawnia tzw. ukryty punkt SPOF (Common Cause Failure). Rzetelny projekt wymaga separacji przestrzennej tras kablowych.

Skróty użyte w tym slajdzie:
SPOF - Single Point of Failure, pojedynczy punkt awarii w strukturze sieciowej.
RACK - Standard szaf montażowych 19 cali dla urządzeń teleinformatycznych.
PDU - Power Distribution Unit, jednostka dystrybucji zasilania montowana w szafach teletechnicznych.
CCF - Common Cause Failure, awaria wywołana wspólną przyczyną niszczącą redundantne komponenty.

6/26

Koncepcja redundancji

Wyjaśnienie technicznych modeli redundancji sprzętowej, logicznej i zasilającej w węzłach sieciowych.

Dublowanie zasobów jako fundament odporności

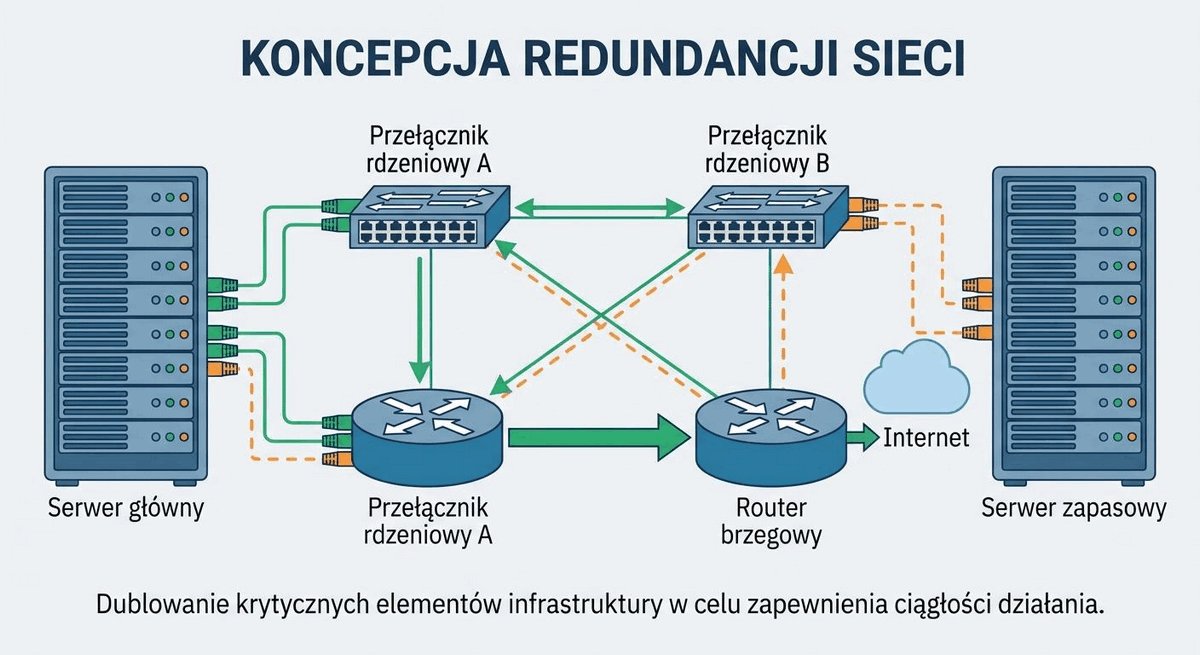
  • Redundancja sprzętowa: instalacja podwójnych zasilaczy hot-swap, modułów wentylatorów oraz zapasowych procesorów routingu.
  • Redundancja logiczna: alternatywne ścieżki transmisji zarządzane automatycznie przez protokoły dynamiczne.
  • Tryby pracy: układ aktywny-zapasowy (Active-Standby) oraz aktywny-aktywny (Active-Active) umożliwiający równoważenie obciążenia ruchem.
Redundancja sieciowa to celowe wprowadzenie nadmiarowych elementów sprzętowych, połączeń kablowych oraz instancji oprogramowania w celu zapewnienia zastępczych ścieżek przesyłania danych w przypadku awarii. Dzieli się na redundancję zimną (wymagającą manualnego włączenia), ciepłą oraz gorącą (automatyczne przełączenie w czasie rzeczywistym).
Modele redundancji sprzętowej i logicznej w sieci

W nowoczesnych przełącznikach dystrybucyjnych i rdzeniowych powszechnie stosuje się redundancję procesorów zarządzających w technologii Stateful Switchover (SSO) wspieraną przez Non-Stop Forwarding (NSF). W przypadku awarii aktywnego procesora procesor zapasowy przejmuje kontrolę bez resetowania kart liniowych i bez utraty tablicy routingu CEF.

Pozwala to na zachowanie ciągłości transmisji pakietów na poziomie matrycy przełączającej podczas procedury przełączania procesorów, co sprawia, że awaria sprzętowa jest całkowicie niezauważalna dla użytkowników końcowych i aplikacji czasu rzeczywistego.

Skróty użyte w tym slajdzie:
SSO - Stateful Switchover, technologia synchronizacji stanu procesorów umożliwiająca bezprzerwowe przełączenie.
NSF - Non-Stop Forwarding, mechanizm podtrzymania przekazywania pakietów przez matrycę podczas restartu procesora routingu.
CEF - Cisco Express Forwarding, zaawansowana technologia sprzętowego przełączania pakietów IP.
RPS - Redundant Power Supply, redundantny system zasilania urządzeń sieciowych.

7/26

Redundancja w warstwie dostępu

Przedstawienie metod realizacji redundancji w warstwie dostępu za pomocą podwójnych łączy uplink i stosów przełączników.

Dublowanie połączeń dosyłowych ze stacji roboczych

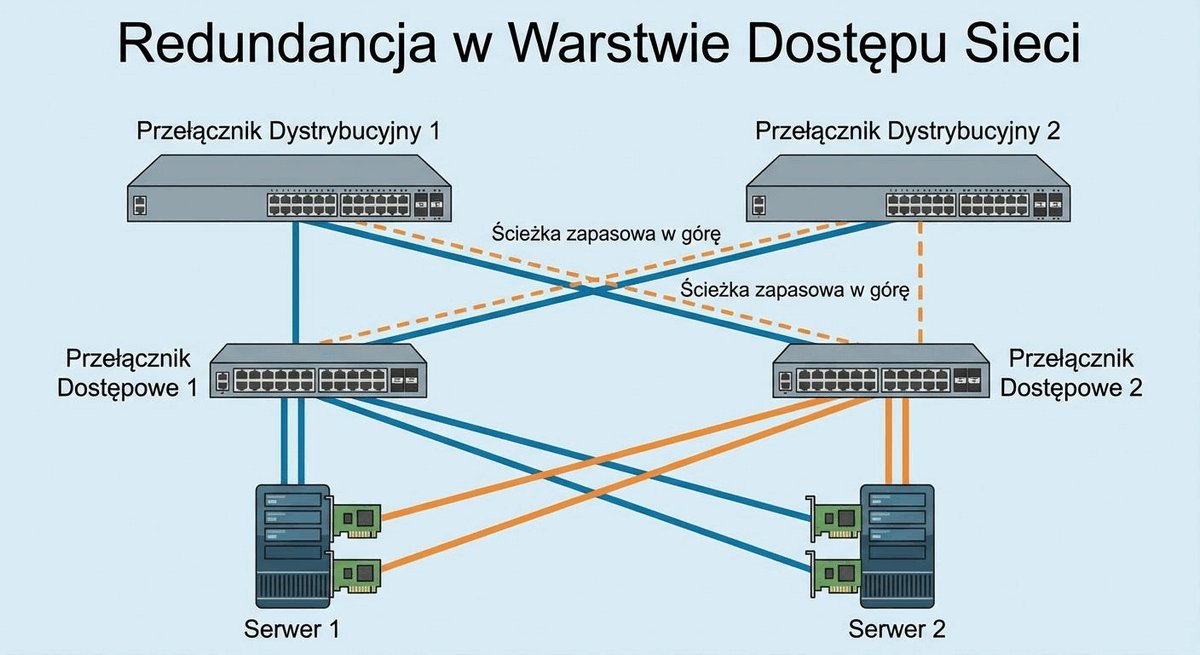
  • Podwójne łącza dosyłowe: podłączenie przełącznika dostępowego do dwóch niezależnych przełączników dystrybucyjnych (Dual-Homing).
  • Stackowanie przełączników (Switch Stacking): łączenie wielu przełączników w jedną logiczną jednostkę za pomocą magistrali dedykowanej.
  • Wyeliminowanie blokowania łączy: wykorzystanie technologii wielochassisowej agregacji portów (M-LAG/vPC/Stacking) w celu pełnego wykorzystania pasma obu łączy.
Stos przełączników (Switch Stack) to zespół fizycznych przełączników dostępowych połączonych dedykowaną magistralą o wysokiej przepustowości, zarządzany jako jedno logiczne urządzenie z pojedynczym adresem IP i wspólną tablicą kontrolną. Umożliwia tworzenie logicznych kanałów agregacji łączy rozproszonych pomiędzy fizycznymi jednostkami stosu.
Redundancja łączy uplink w warstwie dostępu

Tradycyjne podłączenie przełącznika dostępowego dwoma łączami do dwóch oddzielnych przełączników dystrybucyjnych wymuszało działanie protokołu STP, który blokował jedno z połączeń w celu uniknięcia pętli. Oznaczało to, że 50% zakupionego pasma transmisyjnego pozostawało bezużyteczne w warunkach normalnej pracy sieci.

Zastosowanie technologii stosów (np. Cisco StackWise) lub wirtualizacji węzłów dystrybucyjnych (Virtual Switching System / vPC / MLAG) pozwala na spięcie obu łączy uplink w jeden logiczny interfejs Port-Channel za pomocą protokołu LACP. Dzięki temu oba połączenia aktywnie przesyłają ruch, podwajając dostępną przepustowość.

Skróty użyte w tym slajdzie:
M-LAG - Multi-Chassis Link Aggregation Group, agregacja łączy do dwóch niezależnych fizycznie urządzeń przełączających.
vPC - Virtual Port Channel, technologia wirtualizacji łączy agregowanych w przełącznikach sieciowych.
VSS - Virtual Switching System, technologia łączenia dwóch fizycznych przełączników w jeden logiczny węzeł.
STP - Spanning Tree Protocol, protokół blokowania pętli w sieciach Ethernet.

8/26

Redundancja w warstwie dystrybucji i rdzenia

Przedstawienie mechanizmów wysokiej dostępności i routingu równorzędnego w warstwach agregacji i rdzenia.

Odporność na awarie w szkielecie sieci kampusowej

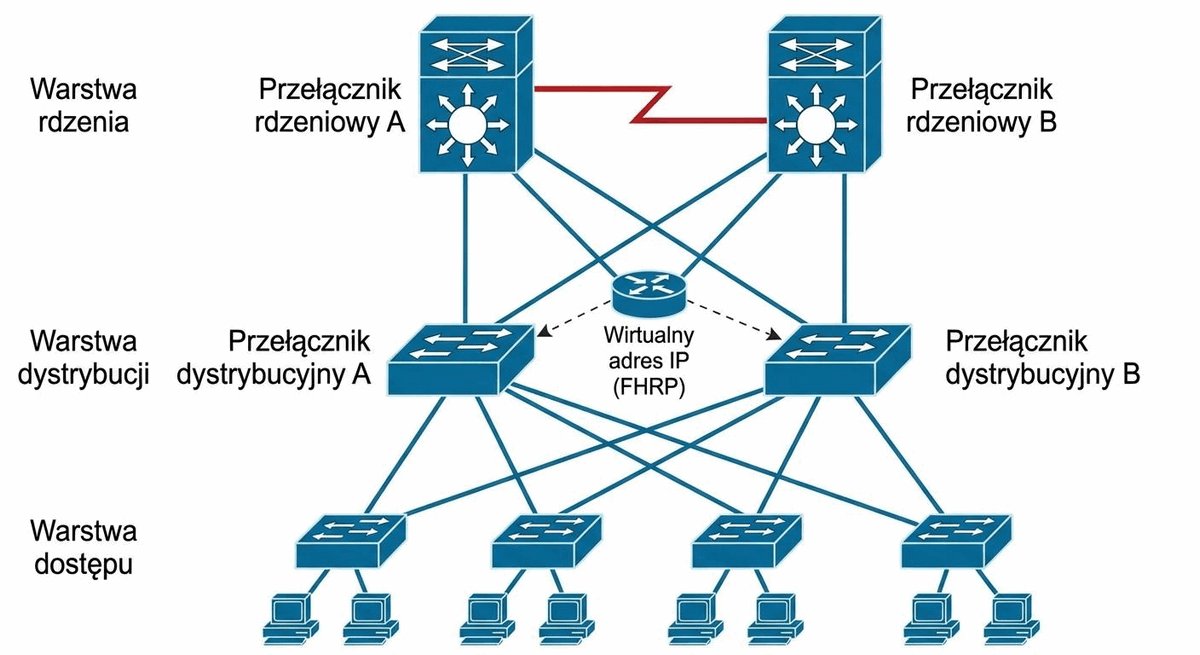
  • Pary urządzeń dystrybucyjnych: instalacja przełączników wielowarstwowych w układzie redundantnym terminującym sieci VLAN.
  • Routing dynamiczny z ECMP: wykorzystanie protokołów IGP (OSPF/IS-IS) równomiernie rozkładających ruch na wiele ścieżek o równym koszcie (ECMP).
  • Protokoły redundancji bramy: zapewnienie wirtualnego adresu bramy domyślnej dla stacji końcowych za pomocą protokołów FHRP (HSRP, VRRP).
Equal-Cost Multi-Path (ECMP) to zaawansowana strategia routingu polegająca na równoległym przekazywaniu pakietów przez wiele ścieżek o identycznej metryce kosztu. Zwiększa sumaryczną przepustowość rdzenia sieci oraz zapewnia natychmiastowe przekierowanie ruchu w przypadku awarii jednego z łączy tranzytowych.
Redundancja i routing ECMP w rdzeniu sieci

W klasycznym kampusie rdzeń sieci buduje się niemal wyłącznie przy użyciu technologii routowanej (Layer 3 Core). Zamiast zawodnych i wolno zbieżnych protokołów warstwy 2, przełączniki rdzeniowe łączone są za pomocą łączy punkt-punkt (Point-to-Point) z maską /30 lub /31, na których uruchomiony jest wewnętrzny protokół stanu łącza (OSPF lub EIGRP).

Dzięki architekturze pełnej siatki połączeń (Full-Mesh) awaria dowolnego kabla światłowodowego lub pojedynczego przełącznika rdzeniowego powoduje natychmiastowe przekierowanie strumieni pakietów przez łącza alternatywne za pomocą mechanizmu ECMP, bez konieczności renegocjacji stanów portów w warstwie 2.

Skróty użyte w tym slajdzie:
ECMP - Equal-Cost Multi-Path, równoważenie obciążenia na trasach o jednakowym koszcie metryki.
IGP - Interior Gateway Protocol, klasa protokołów routingu wewnętrznego stosowanych w sieciach kampusowych.
OSPF - Open Shortest Path First, protokół stanu łącza wyznaczający optymalne trasy IP.
FHRP - First Hop Redundancy Protocols, protokoły zapewniające redundancję bramy domyślnej.

9/26

Problem z redundancją: pętle w warstwie 2

Przedstawienie zjawiska powstawania pętli przełączania w warstwie łącza danych oraz braku mechanizmów ograniczających czas życia ramki.

Anatomia zagrożenia w topologiach z redundantnymi łączami

  • Brak pola TTL w ramce Ethernet: ramka warstwy 2 nie posiada licznika przeskoków (Time to Live), co wyklucza jej automatyczne wygaszenie po zapętleniu.
  • Zalewanie ruchem nieznanym: nieustanna cyrkulacja ramek rozgłoszeniowych i nieznanych jednoemisyjnych (unknown unicast) w zamkniętych pętlach fizycznych.
  • Ryzyko paraliżu sieci: nasycenie pasma magistrali i przeciążenie procesorów przełączników przez lawinowo narastający ruch zapętlony.
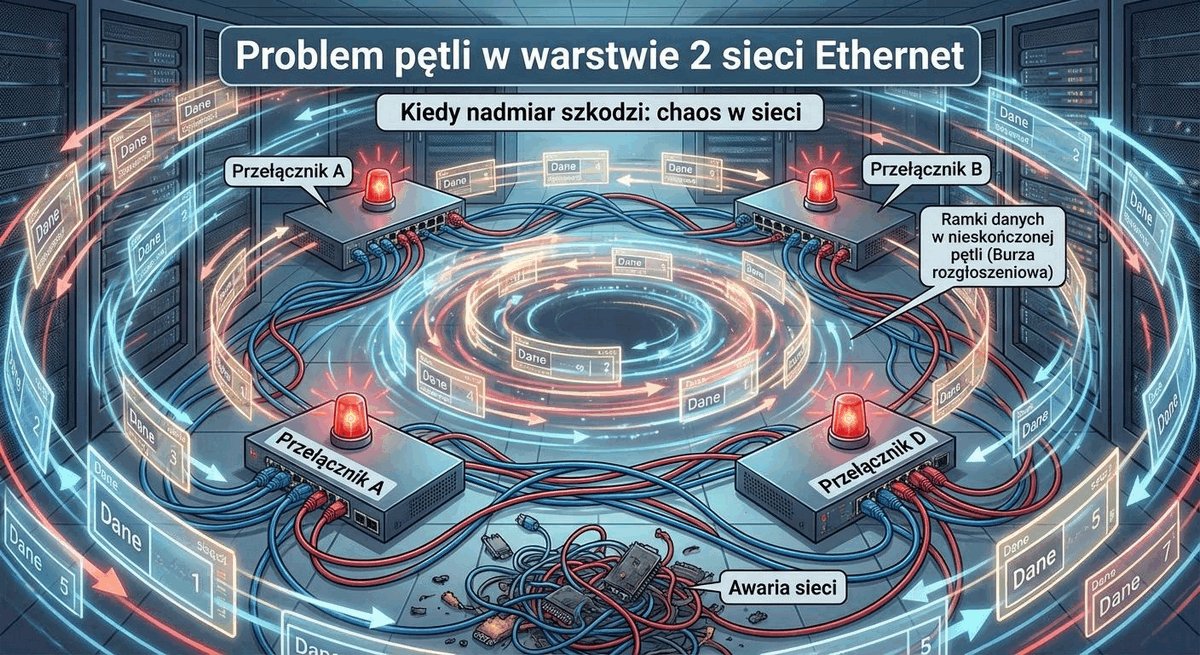
Pętla w warstwie 2 (Switching Loop) to sytuacja w sieci ethernetowej, w której pomiędzy dwoma lub więcej przełącznikami istnieje więcej niż jedna aktywna ścieżka fizyczna bez uruchomionych mechanizmów blokowania. Z uwagi na brak mechanizmu TTL w nagłówku Ethernet ramki krążą w pętli w nieskończoność, doprowadzając do zapaści sieci.
Zjawisko pętli w warstwie 2 z redundantnymi połączeniami

W przeciwieństwie do warstwy 3 (pakiet IP), gdzie pole Time-to-Live (TTL) jest dekrementowane przez każdy router i po osiągnięciu zera pakiet jest bezpiecznie niszczony, ramka Ethernet nie posiada żadnego mechanizmu starzenia. Jeśli ramka rozgłoszeniowa (np. zapytanie ARP Request) trafi do zamkniętej pętli fizycznej, przełączniki będą ją powielać w nieskończoność na wszystkich portach.

Zjawisko to w ciągu ułamka sekundy doprowadza do wygenerowania milionów zduplikowanych pakietów, co całkowicie paraliżuje pasmo transmisyjne oraz przeciąża interfejsy stacji roboczych zmuszonych do przetwarzania lawinowo napływających rozgłoszeń.

Skróty użyte w tym slajdzie:
ARP - Address Resolution Protocol, protokół mapowania adresów logicznych IP na adresy fizyczne MAC.
TTL - Time to Live, pole nagłówka pakietu IP zapobiegające nieskończonemu krążeniu pakietu.
MAC - Media Access Control, adres sprzętowy warstwy łącza danych.
BPDU - Bridge Protocol Data Unit, ramka kontrolna wymieniana pomiędzy przełącznikami w procesie STP.

10/26

Konsekwencje pętli przełączania

Omówienie destrukcyjnych skutków pętli warstwy 2: burz rozgłoszeniowych, niestabilności tablic MAC oraz duplikacji ramek.

Skutki awarii i zjawisko burzy rozgłoszeniowej

  • Burza rozgłoszeniowa (Broadcast Storm): niekontrolowane zwielokrotnianie ramek rozgłoszeniowych nasycające 100% pasma portów w ułamku sekundy.
  • Niestabilność tablicy MAC (MAC Flapping): ciągłe przepisywanie portu skojarzonego z danym adresem źródłowym MAC w pamięci CAM.
  • Zwielokrotnienie ramek unicast: odbieranie przez stację docelową zduplikowanych kopii tej samej ramki, destabilizujące pracę stosów sieciowych.
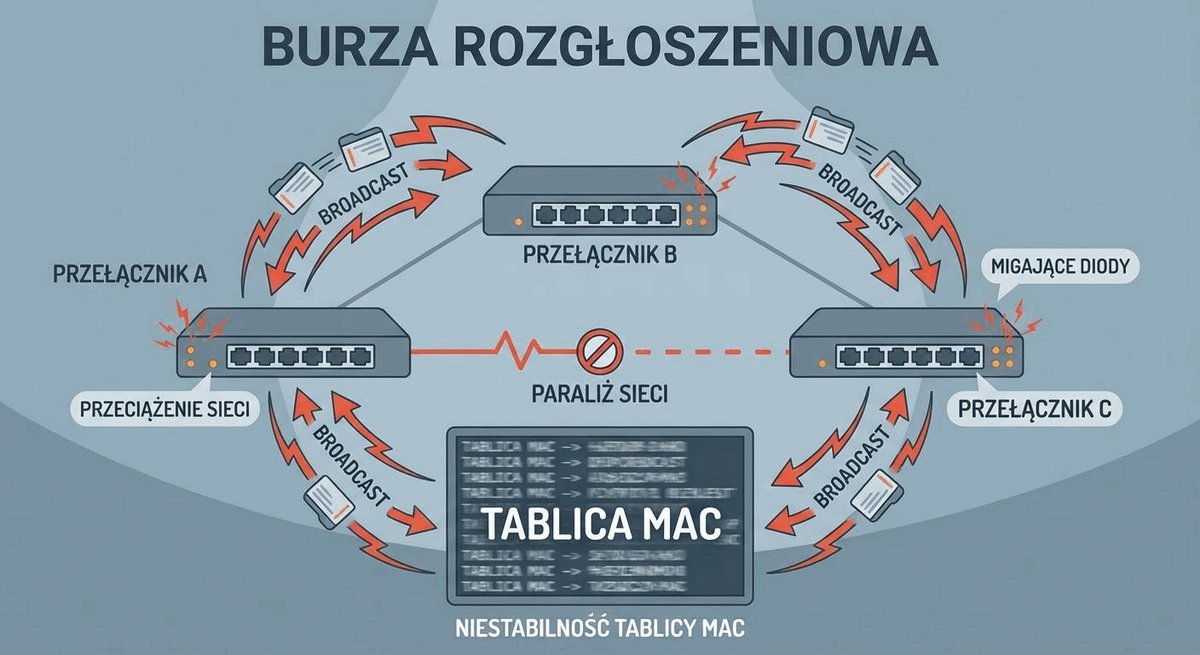
Burza rozgłoszeniowa (Broadcast Storm) to stan krytyczny sieci ethernetowej wywołany niekontrolowaną cyrkulacją i powielaniem ramek rozgłoszeniowych lub multiemisyjnych (multicast) w pętli warstwy 2. Skutkuje stuprocentowym nasyceniem łączy transmisyjnych, zawieszeniem usług sieciowych oraz przerwaniem komunikacji stacji roboczych.
Skutki pętli przełączania: burza rozgłoszeniowa i MAC flapping

Zjawisko MAC Table Instability (często rejestrowane w logach systemowych jako MAC Flapping) polega na tym, że przełącznik odbiera ramki o tym samym adresie MAC źródłowym naprzemiennie na dwóch różnych portach fizycznych (np. co kilka milisekund). Pamięć CAM jest nieustannie aktualizowana, co prowadzi do drastycznego spadku wydajności procesora przełącznika.

W takim stanie przełącznik traci zdolność do prawidłowego kierowania ruchu unicast, zaczyna traktować wszystkie adresy jako nieznane i przechodzi w stan ciągłego zalewania (Unknown Unicast Flooding), co pogłębia zapaść całego segmentu LAN.

Skróty użyte w tym slajdzie:
CAM - Content Addressable Memory, pamięć przechowująca tablicę powiązań port-MAC w przełączniku.
CPU - Central Processing Unit, procesor zarządzający pracą urządzenia sieciowego.
IOS - Internetwork Operating System, sieciowy system operacyjny urządzeń firmy Cisco.
LAN - Local Area Network, lokalna sieć teleinformatyczna łącząca komputery w obiekcie.

11/26

Rozwiązanie: Spanning Tree Protocol (STP)

Przedstawienie protokołu STP jako mechanizmu dynamicznego blokowania redundantnych portów w celu utworzenia bezpętlowego drzewa.

Matematyczny algorytm eliminacji pętli w sieciach Ethernet

  • Geneza protokołu: algorytm drzewa rozpinającego opracowany przez Radię Perlman, ustandaryzowany pierwotnie w IEEE 802.1D.
  • Logiczna topologia bezpętlowa: dynamiczne wyznaczanie i blokowanie portów zapasowych przy zachowaniu pełnej ciągłości fizycznej.
  • Wymiana ramek BPDU: cykliczne rozsyłanie komunikatów kontrolnych (Bridge Protocol Data Units) w celu budowy i utrzymania bezpętlowej topologii.
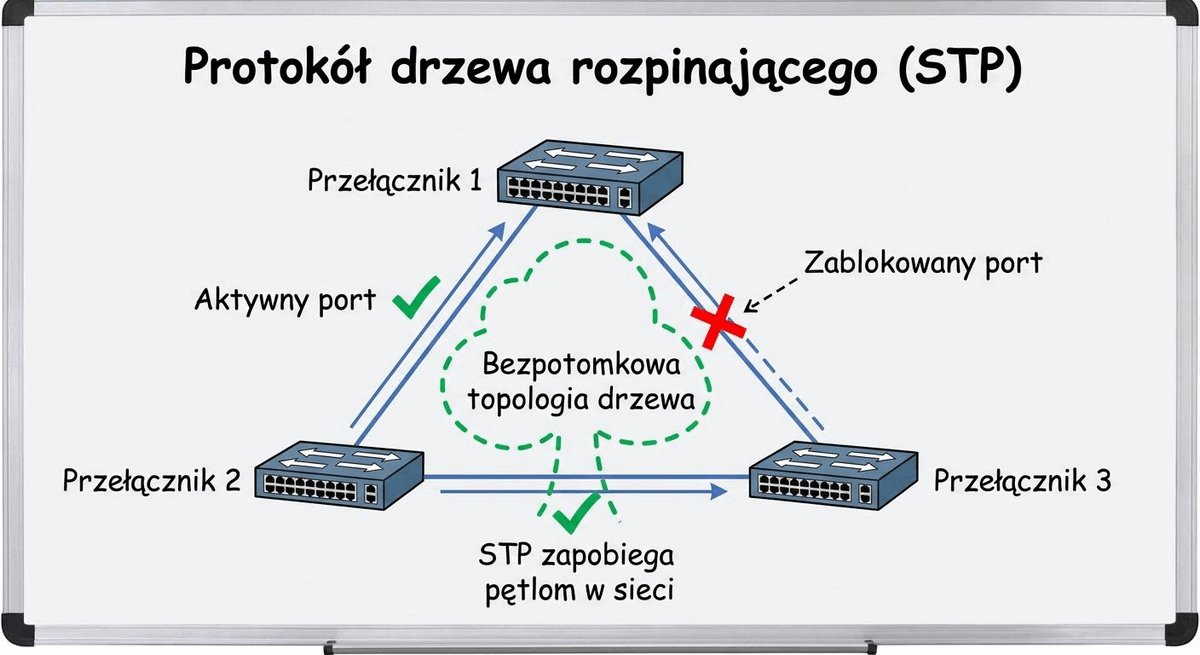
Spanning Tree Protocol (STP) to protokół warstwy łącza danych, który zapobiega powstawaniu pętli w sieciach Ethernet poprzez dynamiczne blokowanie wybranych portów przełączników. W przypadku awarii aktywnego połączenia STP automatycznie odblokowuje port zapasowy, przywracając komunikację w sieci.
Zasada działania algorytmu Spanning Tree Protocol

Protokół STP tworzy logiczną topologię drzewa rozpinającego, w której pomiędzy dowolnymi dwoma węzłami w sieci istnieje dokładnie jedna aktywna ścieżka transmisyjna. Wszystkie pozostałe ścieżki fizyczne zostają wprowadzone w stan blokowania (Blocking), nie przesyłając ramek danych użytkowników.

Przełączniki komunikują się za pomocą specjalnych ramek Bridge Protocol Data Unit (BPDU), wysyłanych co 2 sekundy (Hello Time) na zarezerwowany adres multiemisyjny (multicast). Dzięki temu urządzenia stale monitorują stan łączy i są w stanie zareagować na fizyczne uszkodzenie kabla lub wyłączenie sąsiedniego węzła.

Skróty użyte w tym slajdzie:
STP - Spanning Tree Protocol, protokół tworzenia bezpętlowej topologii logicznej.
BPDU - Bridge Protocol Data Unit, ramka danych algorytmu drzewa rozpinającego.
CST - Common Spanning Tree, pojedyncza instancja drzewa STP dla całej sieci zdefiniowana w 802.1D.
IEEE - Institute of Electrical and Electronics Engineers, instytucja standaryzująca protokół STP.

12/26

Jak działa STP? Proces elekcji Root Bridge

Przedstawienie algorytmu wyboru przełącznika głównego (Root Bridge) na podstawie identyfikatora Bridge ID.

Kroki wyznaczania korzenia drzewa rozpinającego

  • Struktura Bridge ID (BID): priorytet przełącznika (konfigurowalny w krokach co 4096) połączony z unikalnym adresem MAC urządzenia.
  • Kryterium wygranej w elekcji: przełącznik o najniższej wartości Bridge ID (priorytet + adres MAC) zostaje wybrany korzeniem drzewa (Root Bridge).
  • Świadome projektowanie: ręczne obniżenie priorytetu przełącznika dystrybucyjnego w celu deterministycznego wyznaczenia roli Root Bridge.
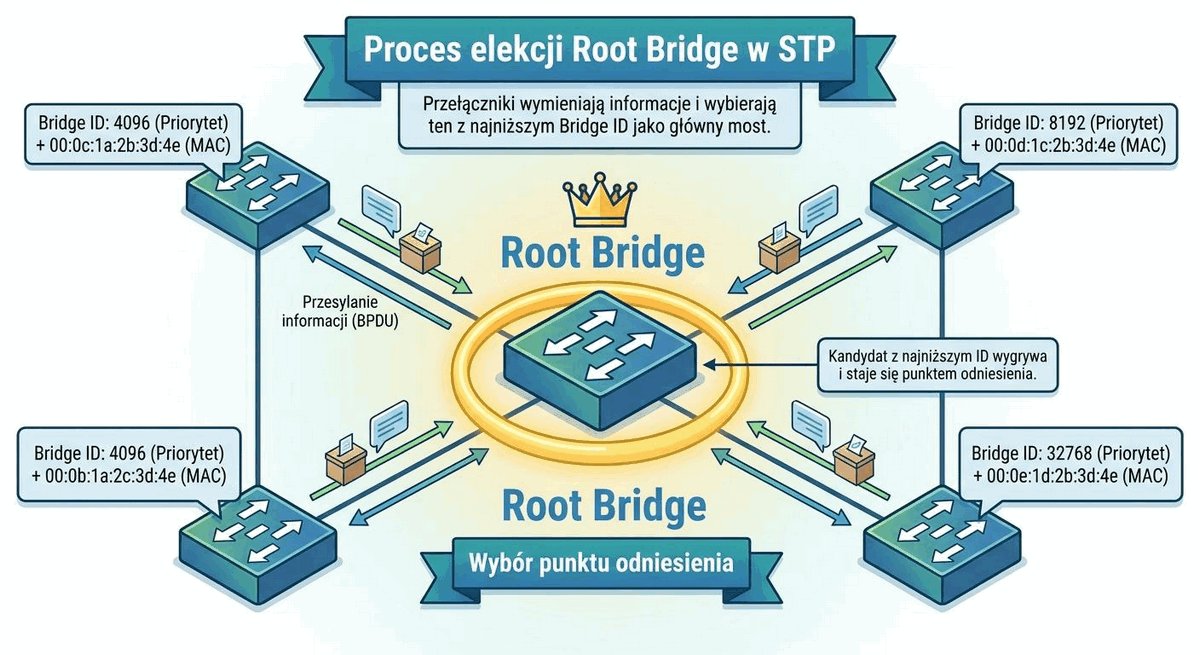
Root Bridge (Most Główny) to centralny przełącznik w topologii STP stanowiący punkt odniesienia (korzeń logiczny) dla wszystkich obliczeń bezpętlowych ścieżek w sieci. Każdy inny przełącznik wyznacza najkrótszą ścieżkę do Root Bridge na podstawie sumarycznego kosztu portów.
Wybór Root Bridge na podstawie najniższego Bridge ID

Współczesne protokoły drzewa rozpinającego (Rapid-PVST+ oraz MSTP) stosują format Bridge ID zdefiniowany w standardzie IEEE 802.1t. Tradycyjne 16-bitowe pole priorytetu podzielono na: 4 bity priorytetu mostu (Bridge Priority) – wartości konfigurowalne od 0 do 61440 wyłącznie z krokiem co 4096 (np. 0, 4096, 8192, 28672, 32768, 61440), oraz 12 bitów rozszerzenia systemowego (Extended System ID) – pole przechowujące numer identyfikacyjny VLAN (VLAN ID w zakresie 1–4094). Dzięki temu całkowity Bridge ID zachowuje unikalność dla każdego VLAN-u przy współdzieleniu tego samego sprzętowego adresu MAC przełącznika. Domyślna wartość priorytetu w przełącznikach wynosi 32768 + numer VLAN (np. 32778 dla VLAN 10).

Niezwykle ważne jest, aby inżynier projektant ręcznie ustawił niski priorytet (np. 4096 lub 8192) na wydajnych przełącznikach warstwy dystrybucji/rdzenia. Pozostawienie wartości domyślnych (32768) sprawi, że o wyborze Root Bridge zadecyduje najniższy adres MAC, co może uczynić korzeniem sieci stary, powolny przełącznik dostępowy na odległym piętrze.

Skróty użyte w tym slajdzie:
BID - Bridge Identifier, 8-bajtowy identyfikator przełącznika w protokole STP.
MAC - Media Access Control, unikalny fizyczny adres sprzętowy urządzenia.
PVST+ - Per-VLAN Spanning Tree Plus, protokół Cisco uruchamiający niezależną instancję STP dla każdego VLAN-u.
VLAN - Virtual Local Area Network, logicznie wydzielona sieć wirtualna.

13/26

Jak działa STP? Role i stany portów

Przedstawienie ról portów oraz stanów operacyjnych w algorytmie drzewa rozpinającego.

Wyznaczanie portów głównych, desygnowanych i zablokowanych

  • Root Port (RP): dokładnie jeden port na każdym przełączniku niebędącym Root Bridge, oferujący najniższy sumaryczny koszt dotarcia do korzenia.
  • Designated Port (DP): port wyznaczony do przesyłania ruchu użytkowników w danym segmencie sieci Ethernet.
  • Port zablokowany (Alternate/Blocking): port zapasowy odcięty logicznie od przekazywania ramek danych w celu eliminacji pętli logicznych.
Rola portu w STP określa funkcję, jaką dany interfejs pełni w topologii drzewa rozpinającego (np. port prowadzący do korzenia lub port segmentowy). Stan portu (Blocking, Listening, Learning, Forwarding) określa natomiast, czy interfejs może przetwarzać ramki BPDU, uczyć się adresów MAC oraz przekazywać ruch użytkowników.
Role i stany portów w protokole Spanning Tree

Po wybraniu Root Bridge każdy pozostały przełącznik (Non-Root Bridge) wybiera dokładnie jeden port główny (Root Port) o najniższym koszcie ścieżki (Root Path Cost). Koszt ścieżki wynika ze standardowych wartości przypisanych do prędkości łączy (np. 1 Gb/s to koszt 4 wg starej normy lub 20 000 wg nowej skali IEEE 802.1D-2004).

W każdym fizycznym segmencie sieci (łączu pomiędzy dwoma przełącznikami) musi zostać wybrany dokładnie jeden port wyznaczony (Designated Port), który przekazuje ruch do tego segmentu. Na przełączniku głównym (Root Bridge) wszystkie aktywne porty stają się automatycznie portami wyznaczonymi (Designated Ports).

Skróty użyte w tym slajdzie:
RP - Root Port, port przełącznika zapewniający najkrótszą drogę do mostu głównego.
DP - Designated Port, port wyznaczony odpowiedzialny za obsługę danego segmentu sieci.
AP - Alternate Port, zapasowy port w protokole RSTP gotowy do natychmiastowego przejęcia roli.
BPDU - Bridge Protocol Data Unit, pakiet kontrolny protokołu drzewa rozpinającego.

14/26

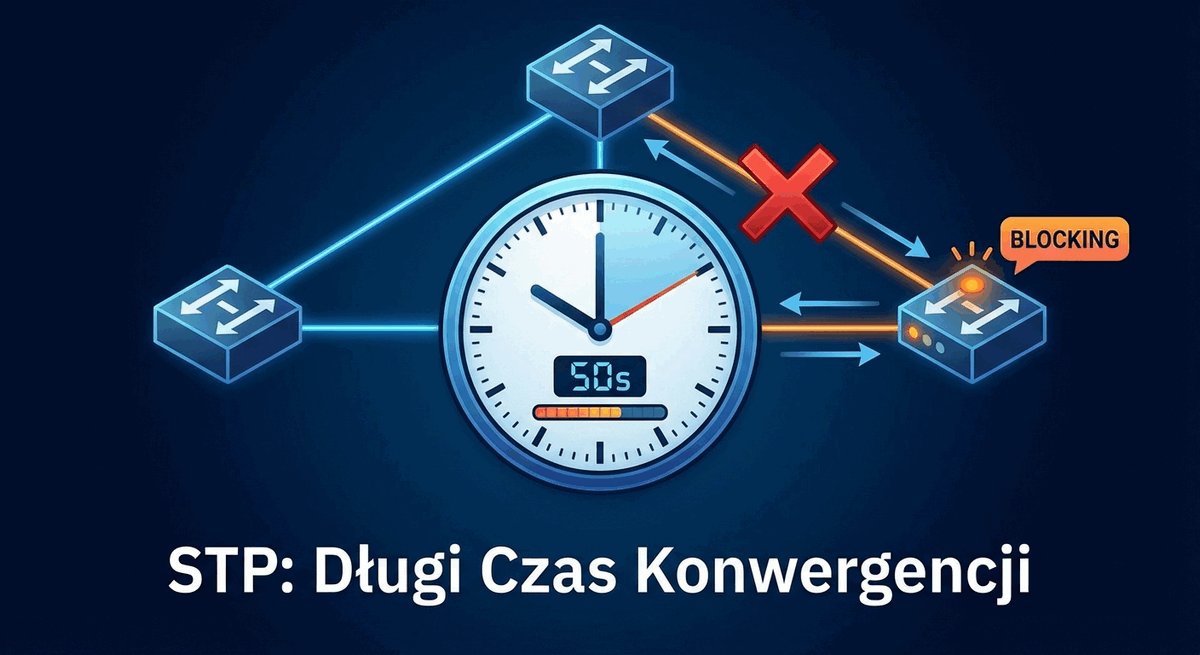
Problem z klasycznym STP: czas konwergencji

Przedstawienie faz przejściowych klasycznego STP oraz wyjaśnienie przyczyn długiego czasu zbieżności dochodzącego do 50 sekund.

Ograniczenia czasowe standardu IEEE 802.1D

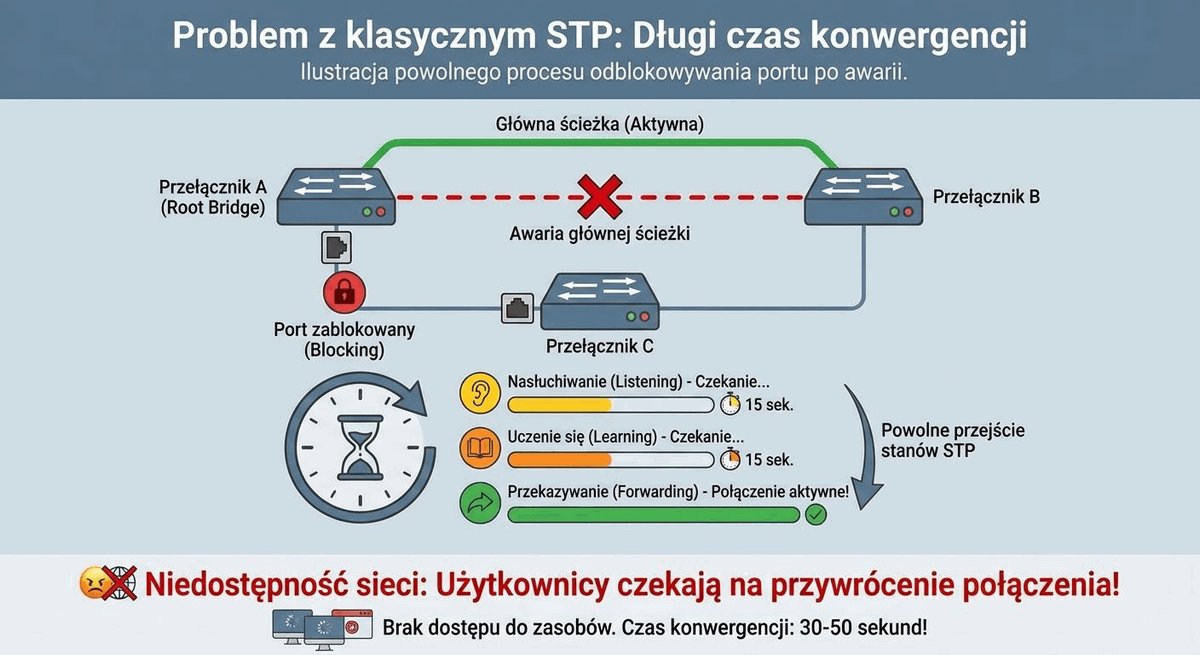
  • Fazy zbieżności: stany Blocking (20 s Max Age), Listening (15 s Forward Delay) oraz Learning (15 s Forward Delay).
  • Łączny czas przestoju: od 30 do 50 sekund do momentu ponownego osiągnięcia stanu Forwarding przez port zapasowy.
  • Niezgodność z wymaganiami VoIP: tak długi czas rekonfiguracji powoduje zerwanie połączeń telefonii IP, wideokonferencji oraz sesji aplikacji biznesowych.
Czas zbieżności (Convergence Time) w warstwie 2 to całkowity czas potrzebny przełącznikom na wykrycie awarii łącza, rozesłanie zaktualizowanych ramek BPDU i przejście portu zapasowego w stan pełnego przekazywania ramek (Forwarding). W klasycznym STP wynosił on od 30 do 50 sekund, co jest niedopuszczalne we współczesnych sieciach.
Fazy zbieżności i czasy opóźnień w klasycznym STP

Długie czasy oczekiwania w standardzie IEEE 802.1D wynikały z konieczności zabezpieczenia sieci przed przedwczesnym odblokowaniem portu w rozległych sieciach mostkowanych z lat 80. i 90. Zegar Max Age (20 s) odliczał czas do uznania ramki BPDU za przedawnioną, a dwa kolejne interwały Forward Delay (po 15 s każdy) służyły do nasłuchiwania BPDU i bezpiecznego uczenia się adresów MAC.

W nowoczesnym środowisku kampusowym, gdzie dominują połączenia światłowodowe typu punkt-punkt oraz aplikacje czasu rzeczywistego (VoIP, MS Teams, systemy bazodanowe), przestój trwający 30-50 sekund powoduje całkowite zerwanie sesji roboczych i masowe błędy aplikacji biznesowych.

Skróty użyte w tym slajdzie:
STP - Spanning Tree Protocol, protokół zapobiegający pętlom w sieciach przełączanych warstwy 2.
BPDU - Bridge Protocol Data Unit, ramka sterująca wykorzystywana przez przełączniki do elekcji i synchronizacji drzewa.
CST - Common Spanning Tree, pojedyncza instancja drzewa rozpinającego dla całej sieci fizycznej zgodnie z IEEE 802.1D.
VoIP - Voice over IP, telefonia cyfrowa wrażliwa na przerwy konwergencji drzewa rozpinającego.
MAC - Media Access Control, unikalny adres fizyczny wykorzystywany w procesie tworzenia identyfikatora Bridge ID.

15/26

Ewolucja: Rapid Spanning Tree (RSTP)

Przedstawienie mechanizmów protokołu RSTP (IEEE 802.1w/802.1Q) redukujących czas zbieżności do ułamków sekundy.

Skrócenie konwergencji do wartości subsekundowych

  • Mechanizm negocjacji Proposal-Agreement: bezpośrednia synchronizacja ról portów na łączach punkt-punkt eliminująca konieczność oczekiwania na upływ timerów.
  • Porty krawędziowe (Edge Ports / PortFast): natychmiastowe przejście do stanu Forwarding dla portów podłączonych do stacji roboczych.
  • Uproszczenie stanów portów: zredukowanie stanów operacyjnych portu do trzech: Discarding, Learning oraz Forwarding.
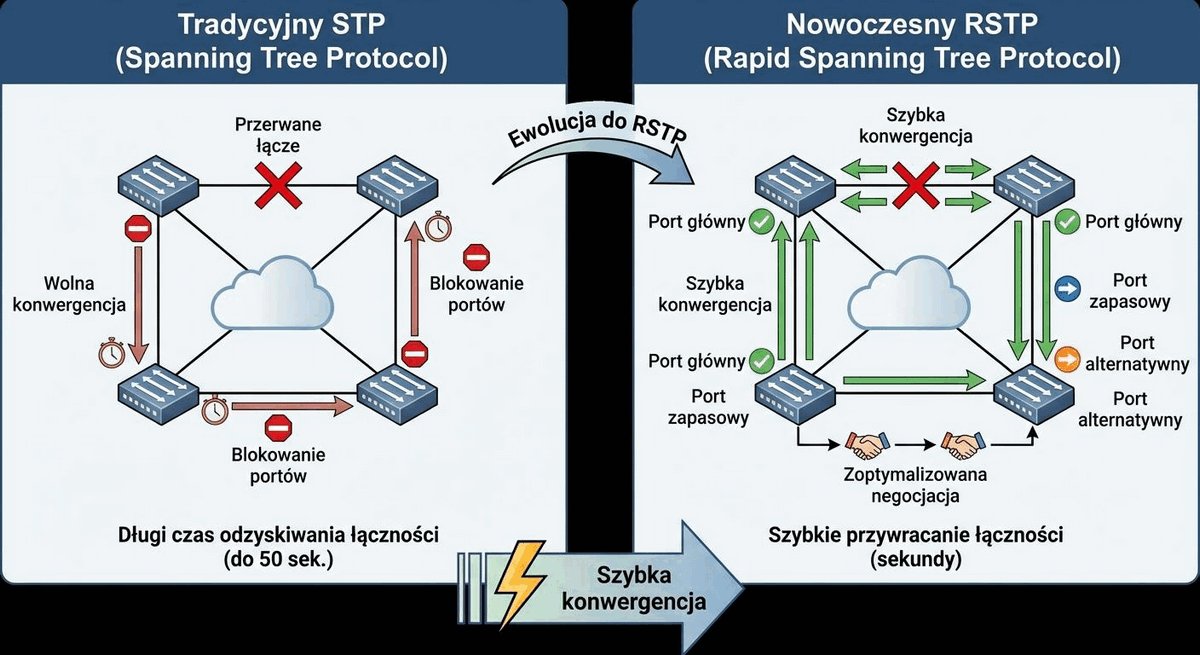
Rapid Spanning Tree Protocol (RSTP, norma IEEE 802.1w wchłonięta przez IEEE 802.1Q) to udoskonalona wersja protokołu drzewa rozpinającego, która skraca czas konwergencji po awarii do kilkudziesięciu milisekund. Osiąga to dzięki bezpośredniej procedurze uzgadniania stanów portów pomiędzy sąsiednimi przełącznikami.
Mechanizm Proposal-Agreement i zbieżność w protokole RSTP

Szybka synchronizacja stanów portów w protokole RSTP (IEEE 802.1w) opiera się na bezpośredniej wymianie ramek Proposal oraz Agreement pomiędzy sąsiednimi przełącznikami. Warunkiem koniecznym do zadziałania tego mechanizmu jest praca łącza w trybie pełnego dupleksu (Point-to-Point Full-Duplex). Jeżeli na interfejsie zostanie wykryty tryb półdupleksu (Half-Duplex), przełącznik traktuje medium jako współdzielone i z przyczyn bezpieczeństwa wyłącza mechanizm Proposal/Agreement, powracając do klasycznych timerów 802.1D (Forward Delay równe 15 s dla stanu Listening oraz 15 s dla Learning).

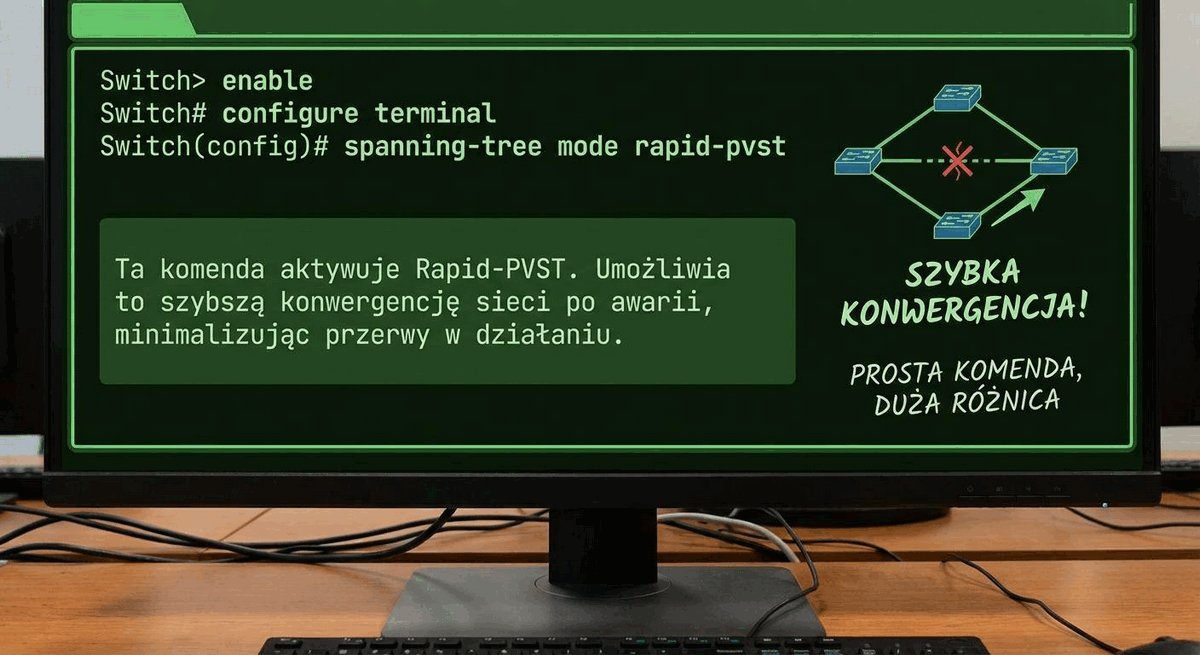
Należy sprostować obiegową opinię, jakoby większość przełączników domyślnie pracowała w trybie RSTP. W systemie Cisco IOS domyślnie aktywny jest klasyczny protokół PVST+, a włączenie szybkiej zbieżności wymaga jawnego wydania polecenia konfiguracji globalnej spanning-tree mode rapid-pvst.

Skróty użyte w tym slajdzie:
RSTP - Rapid Spanning Tree Protocol, uaktualniony standard drzewa rozpinającego IEEE 802.1w redukujący czas zbieżności poniżej 50 ms.
PVST+ - Per-VLAN Spanning Tree Plus, własnościowy protokół Cisco utrzymujący niezależną instancję STP dla każdego VLAN-u.
TC - Topology Change, mechanizm powiadamiania o zmianie topologii fizycznej i natychmiastowego czyszczenia tablic CAM.
IEEE - Institute of Electrical and Electronics Engineers, międzynarodowa organizacja standaryzacyjna rozwijająca standardy serii 802.

16/26

Przykład: migracja do Rapid-PVST+ (Cisco IOS)

Przedstawienie składni poleceń wdrożenia trybu Rapid-PVST+ oraz zabezpieczeń PortFast i BPDU Guard.

Konfiguracja i zabezpieczenie portów dostępowych

Poniższa sekwencja poleceń demonstruje globalne przełączenie trybu STP na Rapid-PVST+ oraz konfigurację portu krawędziowego z aktywną ochroną:

  • Aktywacja trybu Rapid-PVST+: globalna konfiguracja trybu pracy przełącznika zapewniająca zbieżność drzewa w ułamkach sekund.
  • Konfiguracja PortFast: natychmiastowe ominięcie faz nasłuchiwania dla portu podłączonego do stacji roboczej.
  • Ochrona BPDU Guard: automatyczne przejście portu w stan err-disable po odebraniu nieoczekiwanej ramki BPDU na porcie krawędziowym.
Switch(config)# spanning-tree mode rapid-pvst
Switch(config)# interface GigabitEthernet0/1
Switch(config-if)# spanning-tree portfast edge
Switch(config-if)# spanning-tree bpduguard enable
BPDU Guard to zaawansowany mechanizm bezpieczeństwa warstwy 2 blokujący porty dostępowe (Edge Ports) w trybie err-disable w chwili odebrania jakiejkolwiek ramki BPDU. Chroni sieć kampusową przed nieautoryzowanym podłączeniem przełącznika przez użytkownika i próbą przejęcia roli Root Bridge.
Konfiguracja Rapid-PVST+ i mechanizmu BPDU Guard w Cisco IOS

Włączenie mechanizmu PortFast jest kluczowe dla prawidłowego działania usług DHCP i PXE na stacjach roboczych. Bez PortFast stacja robocza podłączona do portu musiałaby czekać do 30 sekund na odblokowanie ruchu, co w wielu systemach operacyjnych powoduje przekroczenie limitu czasu oczekiwania na dzierżawę adresu IP z serwera DHCP.

Należy jednak bezwzględnie pamiętać o powiązaniu funkcji PortFast z ochroną BPDU Guard. Pozostawienie portu PortFast bez ochrony stwarza krytyczną podatność - przypadkowe lub celowe wpięcie kabla w dwa gniazdka ścienne natychmiast wywoła niszczycielską pętlę warstwy 2.

Skróty użyte w tym slajdzie:
PXE - Preboot Execution Environment, środowisko uruchamiania systemu operacyjnego przez sieć komputerową.
DHCP - Dynamic Host Configuration Protocol, protokół automatycznego przydzielania parametrów sieciowych.
BPDU - Bridge Protocol Data Unit, ramka kontrolna algorytmu drzewa rozpinającego.
CLI - Command Line Interface, tekstowy interfejs wiersza poleceń konfiguracji przełącznika.

17/26

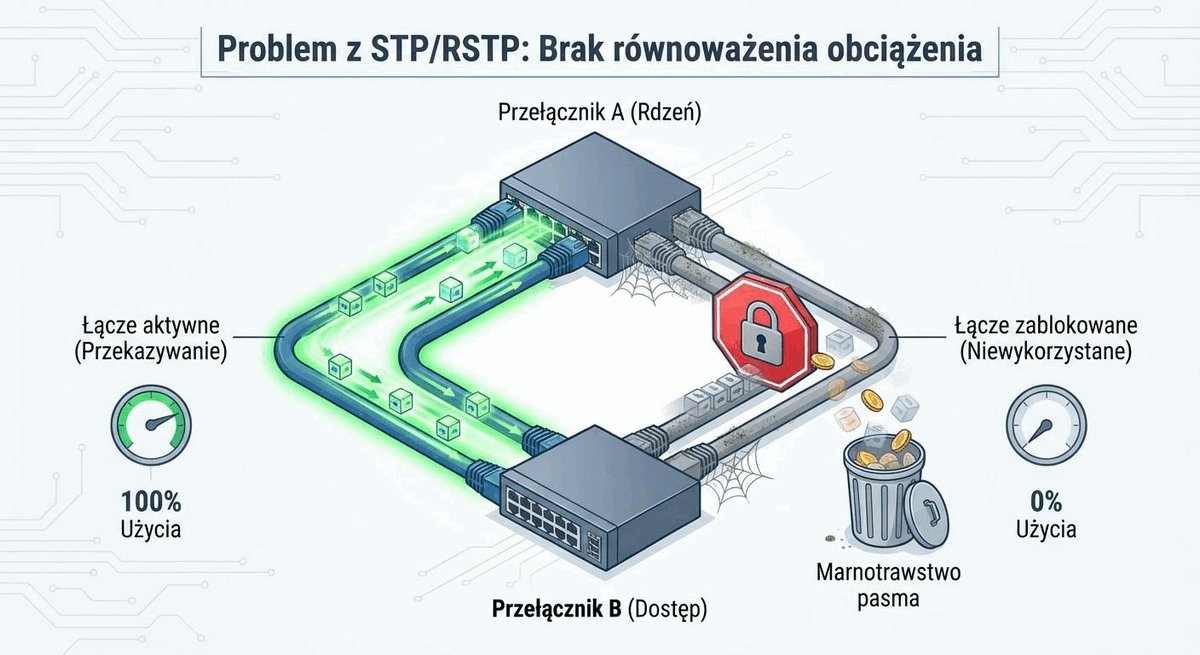
Wada STP/RSTP: brak równoważenia obciążenia

Przedstawienie ograniczeń protokołów jednoinstancyjnych CST oraz metody równoważenia obciążenia za pomocą PVST+.

Ograniczenia pojedynczego drzewa i koncepcja Per-VLAN

  • Ograniczenia Common Spanning Tree (CST): jedna wspólna instancja drzewa dla wszystkich sieci VLAN niepotrzebnie blokująca pasmo na łączach redundantnych.
  • Równoważenie w PVST+/Rapid-PVST+: przypisanie różnych węzłów jako Root Bridge dla poszczególnych VLAN-ów pozwala na efektywne rozłożenie obciążenia.
  • Efektywność łączy: aktywne wykorzystanie obydwu fizycznych łączy dosyłowych (uplinków) poprzez rozłożenie ruchu parzystych i nieparzystych VLAN-ów.
Per-VLAN Spanning Tree (PVST+) to technologia uruchamiająca niezależną instancję protokołu drzewa rozpinającego dla każdej wirtualnej sieci VLAN skonfigurowanej w przełączniku. Pozwala na optymalizację ruchu poprzez wybór różnych przełączników głównych dla poszczególnych podsieci i równomierne obciążenie łączy redundantnych.
Równoważenie obciążenia w technologii Per-VLAN Spanning Tree

Klasyczny standard IEEE 802.1D definiował jedno wspólne drzewo (Common Spanning Tree - CST) dla całej sieci fizycznej, bez względu na liczbę skonfigurowanych sieci wirtualnych VLAN. W efekcie, jeśli dane łącze zostało zablokowane przez algorytm, nie mógł przez nie płynąć żaden ruch, co prowadziło do marnotrawstwa zasobów pasma.

Cisco rozwiązało ten problem, tworząc protokół PVST+, a następnie Rapid-PVST+. Konfigurując np. przełącznik Dystrybucja-1 jako Root Bridge dla VLAN 10 i 20, a przełącznik Dystrybucja-2 jako Root Bridge dla VLAN 30 i 40, inżynier osiąga równomierny podział obciążenia magistrali (Load Balancing) w warunkach normalnej pracy sieci.

Skróty użyte w tym slajdzie:
CST - Common Spanning Tree, jedno wspólne drzewo rozpinające dla wszystkich VLAN-ów.
PVST+ - Per-VLAN Spanning Tree Plus, protokół budujący niezależne drzewo STP dla każdego VLAN-u.
VLAN - Virtual Local Area Network, sieć lokalna wydzielona logicznie w obrębie przełącznika.
IEEE - Institute of Electrical and Electronics Engineers, międzynarodowa instytucja inżynierii elektrycznej.

18/26

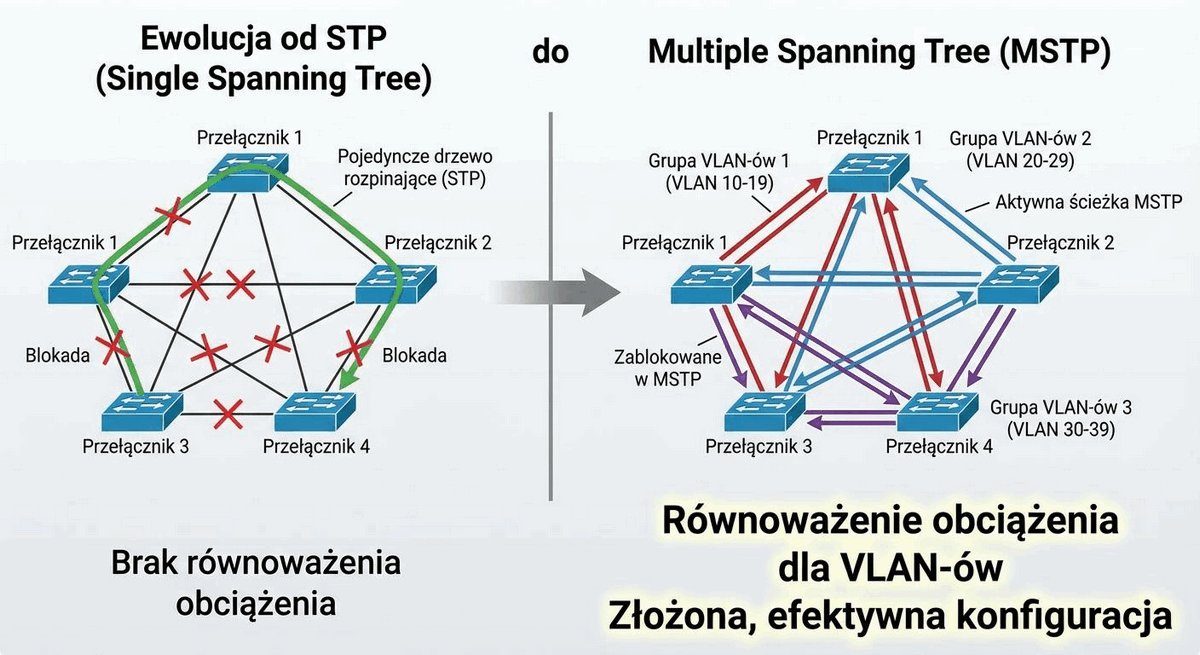
Ewolucja: Multiple Spanning Tree Protocol (MSTP)

Przedstawienie standardu MSTP optymalizującego zużycie zasobów procesora poprzez mapowanie wielu VLAN-ów na instancje MSTI.

Skalowalność drzew rozpinających w dużych sieciach kampusowych

  • Ograniczenia PVST+ przy dużej skali: konieczność utrzymywania setek procesów STP i wysyłania tysięcy BPDU obciążających CPU urządzenia.
  • Standaryzacja w IEEE 802.1Q: włączenie mechanizmów protokołu Multiple Spanning Tree Protocol (dawniej IEEE 802.1s) do standardu IEEE 802.1Q.
  • Instancje MSTI: mapowanie dziesiątek sieci VLAN na 2-4 instancje drzewa rozpinającego (Multiple Spanning Tree Instances) drastycznie redukujące obciążenie CPU.
Multiple Spanning Tree Protocol (MSTP) to otwarty standard protokołu drzewa rozpinającego zdefiniowany w IEEE 802.1Q, umożliwiający przypisanie wielu wirtualnych sieci VLAN do ograniczonej liczby niezależnych instancji logicznych (MSTI). Zapewnia optymalne równoważenie obciążenia przy minimalnym zużyciu pamięci i mocy obliczeniowej przełączników.
Architektura instancji w protokole Multiple Spanning Tree Protocol

W rozległych sieciach kampusowych posiadających 200-500 VLAN-ów protokół Rapid-PVST+ generuje olbrzymi narzut na procesory przełączników, które muszą generować i przetwarzać setki oddzielnych ramek BPDU na każdym łączu magistralnym (Trunk). Prowadzi to do spadku wydajności i ryzyka fałszywych stanów utraty zbieżności.

Protokół MSTP rozwiązuje ten problem w sposób elegancki: sieć jest dzielona na Regiony MST, wewnątrz których administrator definiuje np. dwie instancje (MSTI 1 dla VLAN-ów użytkowników oraz MSTI 2 dla VLAN-ów serwerów i telefonii). Wszystkie VLAN-y w danej instancji dzielą tę samą topologię bezpętlową, co ogranicza liczbę procesów STP do zaledwie kilku. Standard definiujący MSTP został zintegrowany w specyfikacji IEEE Std 802.1Q.

Skróty użyte w tym slajdzie:
MSTP - Multiple Spanning Tree Protocol, standard obsługi wielu instancji drzewa rozpinającego.
MSTI - Multiple Spanning Tree Instance, logiczna instancja drzewa STP grupująca wybrane VLAN-y.
IST - Internal Spanning Tree, domyślna instancja zerowa obsługująca komunikację wewnątrz regionu MST.
CPU - Central Processing Unit, procesor główny przełącznika zarządzający procesami sieciowymi.

19/26

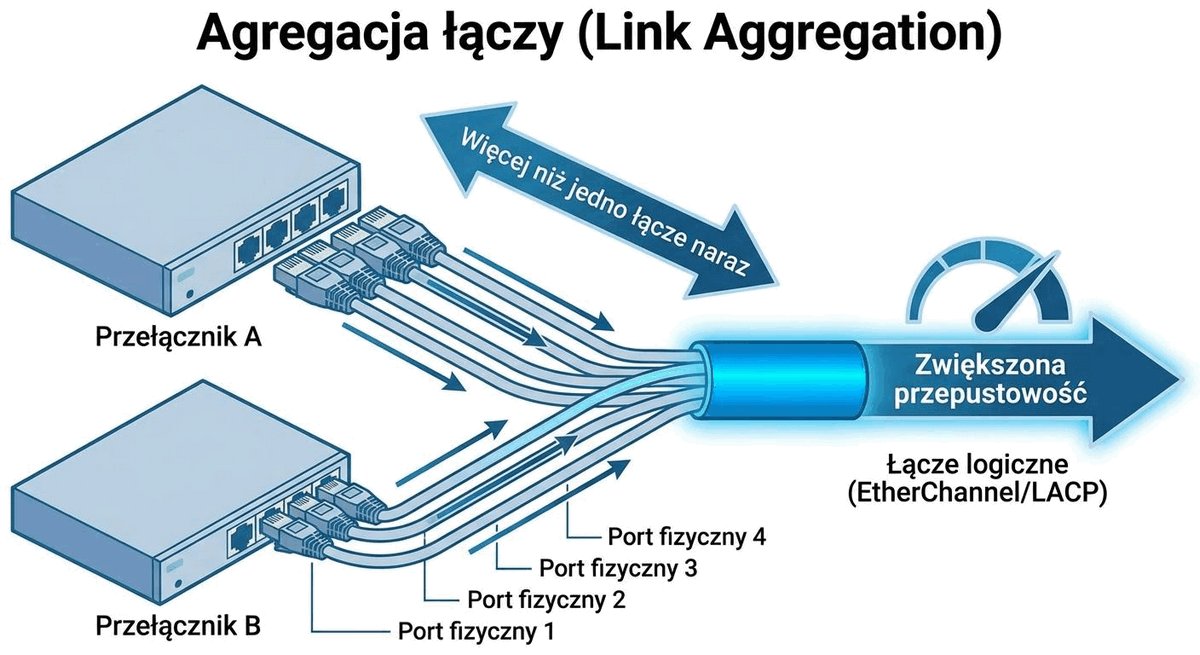
Agregacja łączy (Link Aggregation)

Przedstawienie koncepcji agregacji łączy jako metody zwiększania przepustowości i redundancji bez blokowania portów przez STP.

Łączenie równoległych połączeń fizycznych w jeden kanał logiczny

  • Pojedynczy kanał logiczny (LAG/Port-Channel): logiczne połączenie wiązki do 8 równoległych łączy fizycznych w jeden wirtualny interfejs o zwielokrotnionym paśmie.
  • Eliminacja blokowania STP: protokół STP widzi cały kanał jako pojedyncze łącze, pozostawiając wszystkie fizyczne kable w stanie aktywnym.
  • Automatyczna protekcja: natychmiastowa retransmisja przez pozostałe sprawne łącza w wiązce w przypadku awarii pojedynczego kabla fizycznego.
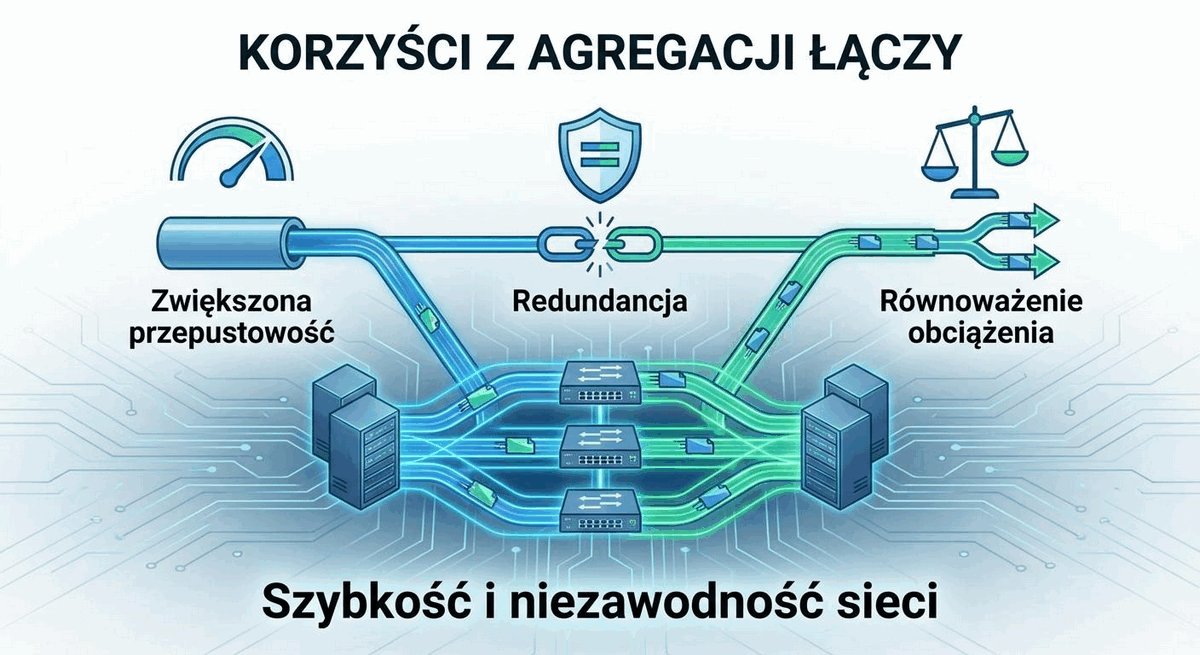
Agregacja łączy (Link Aggregation, LAG / EtherChannel) to technologia łączenia wielu fizycznych portów sieciowych w jeden logiczny interfejs transmisyjny o zwielokrotnionej przepustowości i wbudowanej odporności na awarie. Zapobiega blokowaniu portów przez protokół STP, umożliwiając pełne wykorzystanie wszystkich zainstalowanych łączy.
Koncepcja agregacji łączy fizycznych w logiczny Port-Channel

Agregacja łączy stanowi fundamentalne narzędzie każdego projektanta sieci kampusowej. Zamiast budować relacje dystrybucja-rdzeń przy użyciu pojedynczych kabli, spina się ze sobą 2, 4 lub 8 portów (np. 10 GbE lub 25 GbE) w jeden interfejs Port-Channel. Otwarty standard agregacji definiuje dokument IEEE Std 802.1AX: Link Aggregation.

W przypadku fizycznego uszkodzenia jednego ze światłowodów lub wyjęcia wkładki SFP, zagregowany kanał nie ulega przerwaniu - jego sumaryczna przepustowość zmniejsza się proporcjonalnie, a pakiety są płynnie przesyłane przez pozostałe sprawne łącza w czasie rzędu kilku milisekund, bez konieczności rekonwergencji drzewa STP.

Skróty użyte w tym slajdzie:
LAG - Link Aggregation Group, grupa fizycznych portów połączonych w jeden interfejs logiczny.
LACP - Link Aggregation Control Protocol, ustandaryzowany protokół sterowania agregacją łączy.
STP - Spanning Tree Protocol, protokół drzewa rozpinającego zarządzający pętlami.
GbE - Gigabit Ethernet, rodzina standardów sieciowych o prędkości 1 Gb/s.

20/26

Mechanizm haszowania a ograniczenie pojedynczego przepływu

Wyjaśnienie zasady działania funkcji haszującej w agregacji łączy oraz ograniczenia przepustowości pojedynczego przepływu.

Rozkład ruchu w kanale agregowanym i zasada niezmienności kolejności

  • Algorytm haszowania: wybór łącza fizycznego dla ramki na podstawie haszowania adresów MAC, adresów IP lub portów warstwy czwartej (TCP/UDP).
  • Zachowanie kolejności pakietów: skierowanie całego strumienia (Flow) na jedno łącze zapobiegające powstawaniu zjawiska Out-of-Order Delivery.
  • Ograniczenie prędkości: pojedyncza sesja TCP/UDP korzysta zawsze z jednego fizycznego łącza w wiązce, co zapobiega reasocjacji i rozbieżności pakietów.
Haszowanie w agregacji łączy to deterministyczny algorytm matematyczny obliczający indeks portu fizycznego na podstawie wybranych parametrów nagłówka pakietu (np. adresów IP i portów L4). Gwarantuje, że wszystkie pakiety należące do tej samej sesji transmisyjnej przesyłane są tą samą ścieżką fizyczną, eliminując ryzyko przestawienia kolejności ramek.
Algorytm haszowania i rozkład przepływów w kanale LAG

Częstym błędem poznawczym jest przekonanie, że spięcie czterech łączy 1 Gb/s w EtherChannel pozwoli na pobranie pojedynczego pliku z prędkością 4 Gb/s. Algorytm haszowania realizowany sprzętowo w układach ASIC wybiera łącze fizyczne w wiązce na podstawie wybranych pól nagłówka (adresy MAC nadawcy/odbiorcy, adresy IP lub porty warstwy czwartej TCP/UDP). Wszystkie pakiety należące do tego samego strumienia (rozpoznawane identycznym hashem) są bezwzględnie przesyłane przez ten sam interfejs fizyczny. Zapobiega to docieraniu pakietów do odbiorcy w zmienionej kolejności (Packet Reordering). W konsekwencji żaden pojedynczy transfer danych nie może przekroczyć przepustowości pojedynczego łącza składowego (1 Gb/s w wiązce 4x 1 Gb/s). Sumaryczny zysk przepustowości widoczny jest wyłącznie przy dużej liczbie zróżnicowanych przepływów od wielu użytkowników.

Sumaryczna przepustowość 4 Gb/s jest osiągana dopiero przy równoległej obsłudze wielu zróżnicowanych przepływów od dziesiątek lub setek stacji roboczych. Dlatego w konfiguracji przełączników zaleca się stosowanie zaawansowanych algorytmów haszowania uwzględniających porty warstwy czwartej (src-dst-mixed-ip-port).

Skróty użyte w tym slajdzie:
TCP - Transmission Control Protocol, połączeniowy protokół warstwy transportowej gwarantujący dostarczenie danych.
UDP - User Datagram Protocol, bezpołączeniowy protokół transportowy o niskich opóźnieniach.
LAG - Link Aggregation Group, zagregowana grupa portów fizycznych.
CRC - Cyclic Redundancy Check, cykliczny kod nadmiarowy wykorzystywany m.in. w funkcjach haszujących.

21/26

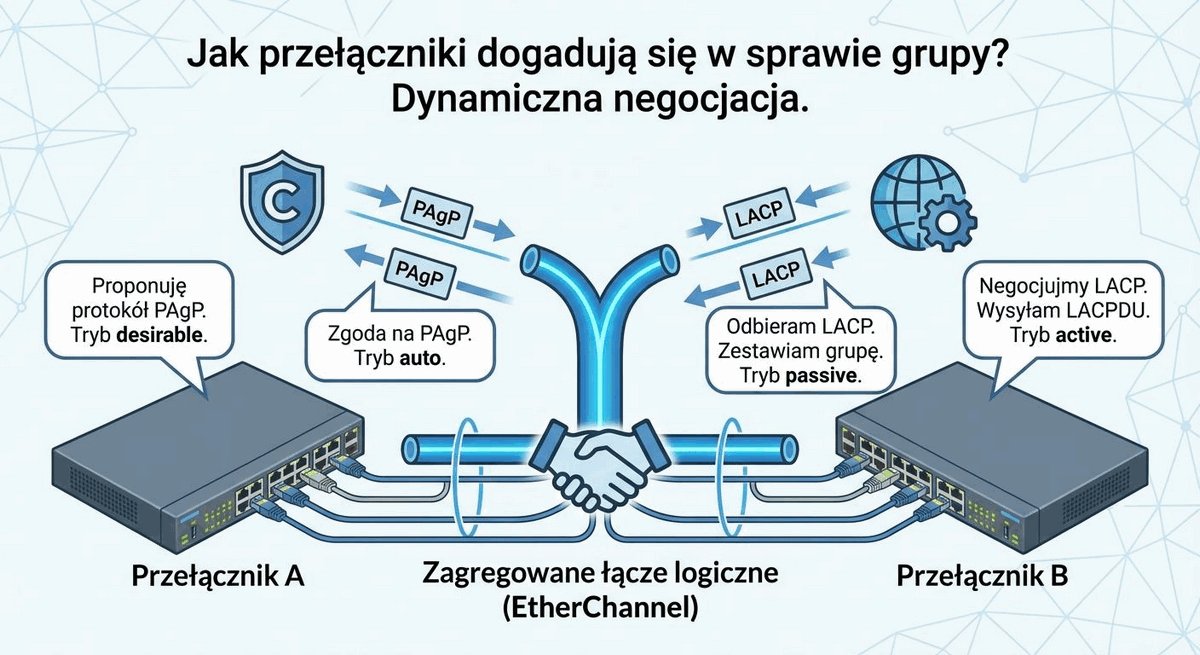
Protokoły negocjacji agregacji: LACP vs PAgP

Porównanie standardu IEEE LACP z protokołem PAgP oraz omówienie trybów negocjacji active, passive i konfiguracji statycznej on.

Standard otwarty IEEE 802.1AX kontra rozwiązanie własnościowe

  • Standard LACP (IEEE 802.1AX): uniwersalny protokół przemysłowy automatyzujący tworzenie i nadzorowanie wiązek zagregowanych.
  • Własnościowy protokół PAgP: historyczne rozwiązanie firmy Cisco (Port Aggregation Protocol) wycofywane w nowoczesnych sieciach.
  • Tryby operacyjne LACP: tryb aktywny (Active - inicjuje negocjację LACP) oraz pasywny (Passive - odpowiada na pakiety LACPDU).
Link Aggregation Control Protocol (LACP, standard IEEE 802.1AX) to znormalizowany protokół dynamicznej negocjacji i monitorowania stanu zagregowanych łączy ethernetowych. Wymieniając pakiety LACPDU, urządzenia upewniają się, że połączone porty mają identyczne parametry (prędkość, dupleks, dozwolone VLAN-y) przed aktywacją kanału.
Porównanie protokołów negocjacji LACP i PAgP

Należy zwrócić szczególną uwagę na rozróżnienie pojęć: tryb on w konfiguracji Cisco EtherChannel NIE jest trybem negocjacji protokołu LACP! Wpisanie channel-group mode on wymusza statyczne zestawienie kanału bez jakiejkolwiek wymiany pakietów kontrolnych. Zgodnie ze standardem IEEE 802.1AX zalecanym trybem pracy jest aktywna negocjacja LACP.

Stosowanie trybu on w środowiskach produkcyjnych jest wysoce niewskazane i uznawane za błąd projektowy. Jeśli jedno z łączy ulegnie uszkodzeniu jednostronnemu (Unidirectional Link) lub zostanie błędnie wpięte do innego urządzenia, statyczny EtherChannel nie wykryje problemu i będzie nadal kierował ruch w pustkę, powodując czarną dziurę (Black Hole) dla ruchu sieciowego.

Skróty użyte w tym slajdzie:
LACP - Link Aggregation Control Protocol, otwarty protokół automatycznej agregacji łączy.
PAgP - Port Aggregation Protocol, własnościowy protokół firmy Cisco służący do negocjacji kanałów EtherChannel.
LACPDU - Link Aggregation Control Protocol Data Unit, pakiet kontrolny wymieniany przez interfejsy LACP.
IEEE - Institute of Electrical and Electronics Engineers, międzynarodowa instytucja rozwijająca standardy.

22/26

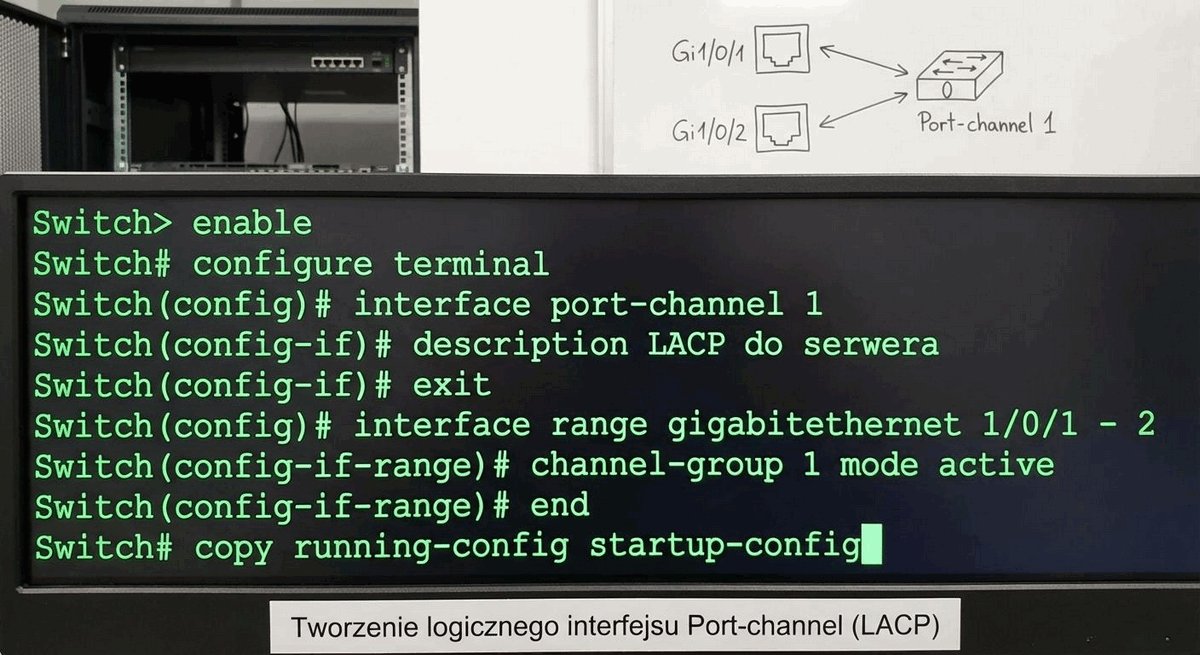
Przykład: konfiguracja i weryfikacja LACP (Cisco IOS)

Przedstawienie składni konfiguracji aktywnej negocjacji LACP oraz zasad spójności parametrów portów składowych.

Praktyczna deklaracja kanału Port-Channel w systemie Cisco IOS

Poniższy listing przedstawia wzorcową procedurę dodania portów do grupy kanałowej LACP oraz konfiguracji magistrali trunk na interfejsie logicznym:

  • Deklaracja grupy kanałowej: polecenie channel-group 1 mode active aktywuje automatyczną wymianę ramek LACPDU i dynamiczne formowanie kanału.
  • Konfiguracja na interfejsie logicznym: definicja trybu trunk i dozwolonych sieci wirtualnych bezpośrednio na porcie Port-channel1.
  • Dobre praktyki bezpieczeństwa: wyłączenie dynamicznej negocjacji trunkingu (switchport nonegotiate) na łączu magistralnym Port-Channel.
Switch(config)# interface range GigabitEthernet0/1 - 2
Switch(config-if-range)# channel-group 1 mode active
Switch(config-if-range)# exit
Switch(config)# interface Port-channel1
Switch(config-if)# switchport mode trunk
Switch(config-if)# switchport trunk allowed vlan 10,20,30
Switch(config-if)# switchport nonegotiate
Spójność parametrów portów w LACP to wymóg inżynierski, zgodnie z którym wszystkie fizyczne porty należące do danej grupy kanałowej muszą posiadać identyczną prędkość, tryb dupleksu, natywny VLAN oraz listę dozwolonych sieci VLAN. Niezgodność któregokolwiek parametru skutkuje natychmiastowym wyłączeniem portu z kanału logicznego.
Konfiguracja kanału LACP i interfejsu Port-channel w Cisco IOS

Złotą zasadą konfiguracji kanałów agregowanych w systemie Cisco IOS jest dokonywanie wszelkich zmian konfiguracyjnych (dotyczących trybu pracy, dozwolonych VLAN-ów czy parametrów QoS) wyłącznie na logicznym interfejsie Port-channel, a nie na pojedynczych portach fizycznych. System operacyjny automatycznie propaguje wprowadzone ustawienia na wszystkie powiązane porty składowe.

Do weryfikacji poprawności działania kanału służy polecenie show etherchannel summary. W prawidłowo działającym łączu interfejs Port-Channel powinien posiadać flagi SU (Switched, Up), a poszczególne porty składowe flagę P (Bundled in port-channel). Pojawienie się flagi D (Down) lub I (Stand-alone) wskazuje na błąd negocjacji LACP lub niespójność konfiguracji.

Skróty użyte w tym slajdzie:
DTP - Dynamic Trunking Protocol, protokół Cisco automatycznie negocjujący tryb magistrali na porcie.
VLAN - Virtual Local Area Network, wirtualna sieć lokalna.
CLI - Command Line Interface, interfejs wiersza poleceń w urządzeniach sieciowych.
QoS - Quality of Service, mechanizmy priorytetyzacji ruchu w urządzeniach komutacyjnych.

23/26

Podsumowanie wykładu

Podsumowanie zasad łączenia redundancji fizycznej, protokołów drzewa rozpinającego oraz agregacji łączy.

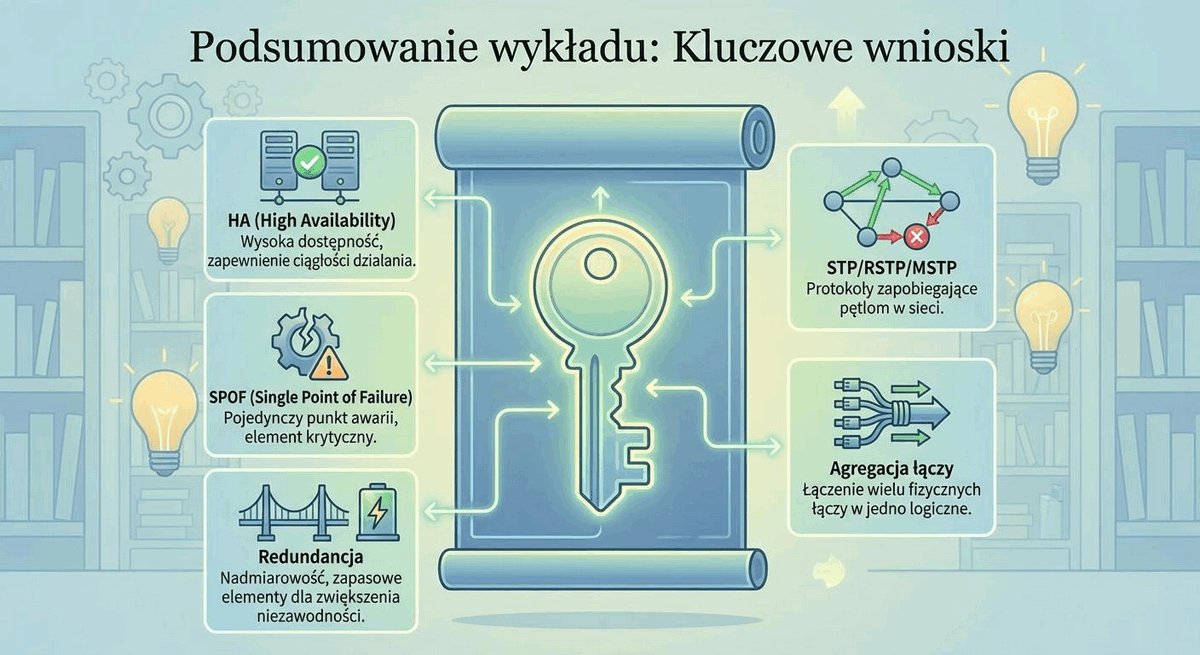
Kluczowe filary niezawodności w sieci kampusowej

  • Projektowanie bez pojedynczych punktów awarii: eliminacja SPOF w zasilaniu, trasach kablowych i węzłach dystrybucyjnych.
  • Optymalizacja warstwy 2: wdrożenie protokołów szybkiej zbieżności Rapid-PVST+ lub MSTP (IEEE 802.1Q) wraz z mechanizmami BPDU Guard i Root Guard.
  • Efektywna agregacja połączeń: wykorzystanie standardu LACP (IEEE 802.1AX) do łączenia redundantnych łączy fizycznych w bezpętlowe magistrale logiczne.
Zintegrowana architektura wysokiej dostępności to holistyczny układ redundantnych urządzeń, zdublowanych magistrali światłowodowych i protokołów subsekundowej konwergencji. Zapewnia nieprzerwane działanie infrastruktury teleinformatycznej organizacji przy jednoczesnej optymalizacji wykorzystania zakupionego pasma transmisyjnego.
Zestawienie kluczowych filarów wysokiej dostępności sieci

Opanowanie mechanizmów wysokiej dostępności i kontroli pętli warstwy 2 stanowi jeden z najważniejszych etapów kształcenia inżyniera sieciowego. Błędy popełnione przy planowaniu ról Root Bridge lub brak zabezpieczeń BPDU Guard na portach dostępowych są najczęstszą przyczyną rozległych awarii w sieciach korporacyjnych i kampusowych.

W nowoczesnych projektach dąży się do minimalizowania zasięgu warstwy 2 poprzez przesuwanie granicy routingu (L3) jak najbliżej użytkownika (tzw. Routed Access). W sytuacjach, gdzie rozciąganie VLAN-ów jest konieczne, połączenie technik MSTP, LACP oraz wirtualizacji urządzeń gwarantuje stabilność i najwyższą wydajność.

Skróty użyte w tym slajdzie:
SPOF - Single Point of Failure, pojedynczy punkt awarii unieruchamiający system.
RSTP - Rapid Spanning Tree Protocol, szybkie drzewo rozpinające IEEE 802.1w.
MSTP - Multiple Spanning Tree Protocol, skalowalny protokół wielu instancji drzewa IEEE 802.1Q.
LACP - Link Aggregation Control Protocol, otwarty protokół łączenia portów w logiczny kanał.

24/26

Zapowiedź kolejnego wykładu

Przedstawienie tematyki kolejnego wykładu poświęconego logicznej segmentacji sieci, tagowaniu 802.1Q i routingowi między sieciami VLAN.

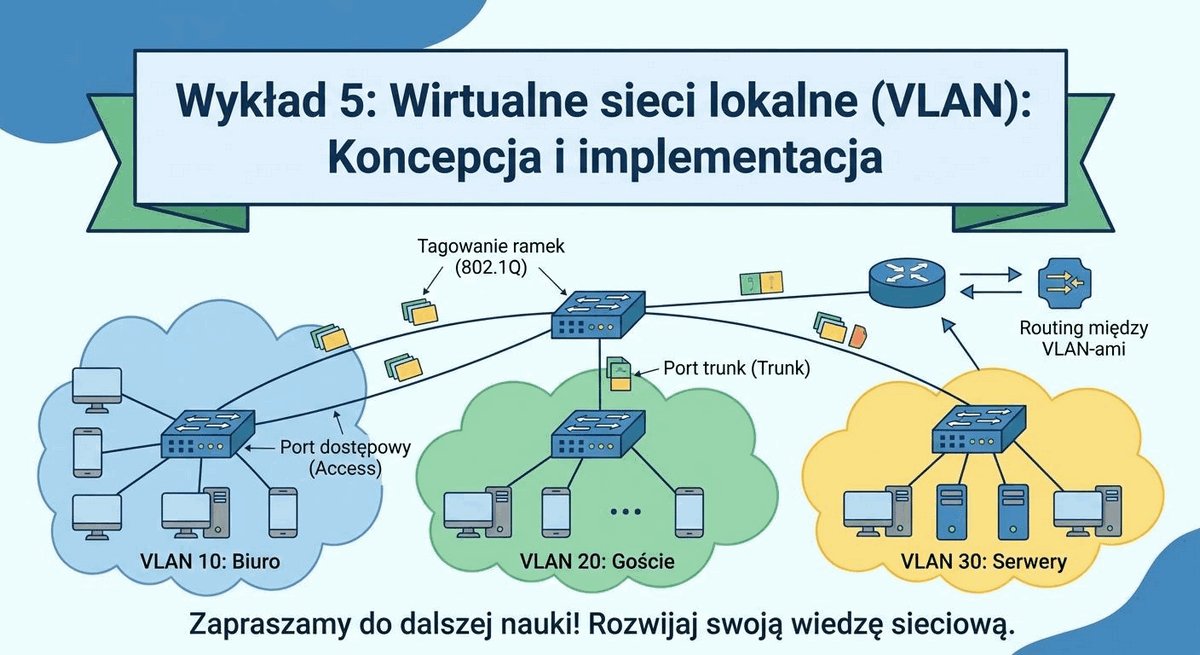
Wykład 5: Wirtualne sieci lokalne (VLAN) i routing między VLAN-ami

  • Segmentacja logiczna: tworzenie odizolowanych domen rozgłoszeniowych VLAN i tagowanie ramek w standardzie IEEE 802.1Q.
  • Magistrale trunk i enkapsulacja: zasada tagowania nagłówka ramki czterobajtowym znacznikiem VLAN ID i obsługa Native VLAN.
  • Routing między sieciami VLAN: modele Router-on-a-Stick, logiczne interfejsy SVI oraz routowane porty przełączników warstwy 3.
Wirtualna sieć lokalna (Virtual Local Area Network, VLAN) to logicznie wyodrębniona domena rozgłoszeniowa utworzona w obrębie fizycznej infrastruktury przełączników sieciowych. Umożliwia separację ruchu poszczególnych działów organizacji, podnosząc bezpieczeństwo i ułatwiając zarządzanie pasmem transmisyjnym.
Zapowiedź tematyki sieci VLAN i routingu między sieciami VLAN

Kolejny wykład poświęcimy fundamentalnej technologii separacji ruchu w sieciach kampusowych - sieciom wirtualnym VLAN. Szczegółowo przeanalizujemy budowę 4-bajtowego nagłówka tagu IEEE 802.1Q, w tym pola TPID, priorytetu PCP oraz 12-bitowego identyfikatora VLAN ID.

Porównamy również klasyczne metody routingu między sieciami VLAN za pomocą routera z subinterfejsami (Router-on-a-Stick) z nowoczesnym podejściem opartym na interfejsach SVI w przełącznikach warstwy 3, analizując ich wpływ na opóźnienia i skalowalność kampusu.

Skróty użyte w tym slajdzie:
VLAN - Virtual Local Area Network, logicznie wyodrębniony segment sieci lokalnej.
TPID - Tag Protocol Identifier, 16-bitowe pole nagłówka 802.1Q identyfikujące ramkę tagowaną (wartość 0x8100).
PCP - Priority Code Point, 3-bitowe pole nagłówka 802.1Q definiujące priorytet ramki w warstwie 2.
SVI - Switch Virtual Interface, wirtualny interfejs routowalny przypisany do danej sieci VLAN.

25/26

Pytania i odpowiedzi (Q&A)

Wyjaśnienie problemów projektowych i operacyjnych związanych z drzewem rozpinającym i agregacją łączy.

Sesja dyskusyjna i wyjaśnienie wątpliwości

  • Weryfikacja wiedzy: analiza różnic w zbieżności i zapotrzebowaniu na zasoby procesora pomiędzy klasycznym STP, Rapid-PVST+ a standardem MSTP.
  • Przypadki laboratoryjne: scenariusze diagnostyki błędów konfiguracji agregacji LACP oraz reakcji BPDU Guard na nieautoryzowane przełączniki.
  • Konsultacje: omówienie harmonogramu laboratoriów i dostępności stanowisk sprzętowych w pracowniach sieciowych uczelni.
Sesja pytań i odpowiedzi to kluczowy element procesu dydaktycznego pozwalający na konfrontację wiedzy teoretycznej z rzeczywistymi problemami spotykanymi podczas uruchamiania sieci. Ułatwia zrozumienie zjawisk dynamicznych zachodzących w protokołach drzewa rozpinającego.
Sesja pytań i odpowiedzi dotycząca protokołów STP i LACP

Podczas sesji dyskusyjnej zachęcam do zadawania pytań dotyczących zachowania sieci w nietypowych stanach awaryjnych - np. w przypadku wystąpienia pętli logicznej mimo działania protokołu STP lub problemów z asymetrią ruchu w łączach agregowanych LACP.

Wszystkie prezentowane przykłady konfiguracji będą bezpośrednio testowane podczas nadchodzących ćwiczeń laboratoryjnych w środowisku fizycznych przełączników Cisco Catalyst oraz emulatorach sieciowych (Cisco CML / EVE-NG).

Skróty użyte w tym slajdzie:
CML - Cisco Modeling Labs, oficjalne oprogramowanie do emulacji środowisk sieciowych Cisco.
EVE-NG - Emulated Virtual Environment Next Generation, platforma emulacji systemów sieciowych.
QA - Quality Assurance, procedury weryfikacji jakości i stabilności konfiguracji.
CLI - Command Line Interface, interfejs wiersza poleceń przełączników.

26/26

Dziękuję za uwagę

Zakończenie wykładu i wskazanie literatury uzupełniającej z zakresu wysokiej dostępności i redundancji w sieciach LAN.

Zakończenie wykładu

  • Podziękowanie: za aktywny udział w analizie zagadnień wysokiej dostępności i eliminacji pętli warstwy 2.
  • Literatura podstawowa: Paweł Zaręba, Praktyczne projekty sieciowe, rozdział 5, Helion 2019.
  • Normy i zbiory wytycznych: oficjalne specyfikacje IEEE 802.1Q (Bridges and Bridged Networks) oraz IEEE 802.1AX (Link Aggregation).
Literatura specjalistyczna i dokumentacja inżynierska to podstawowe źródło wiedzy o niuansach implementacyjnych i zachowaniu protokołów sieciowych w warunkach granicznych. Stanowi niezbędną pomoc przy projektowaniu środowisk produkcyjnych o wysokich wymaganiach SLA.
Zakończenie wykładu czwartego i rekomendowana literatura

Wiedza z zakresu działania protokołów STP, RSTP i LACP jest kluczowa dla bezpiecznego wdrażania zaawansowanych usług sieciowych w kolejnych etapach kursu. Niezrozumienie procesu elekcji Root Bridge lub mechanizmów haszowania EtherChannel prowadzi do niestabilności sieci, trudnych do zdiagnozowania problemów wydajnościowych oraz przestojów usług.

Przed kolejnymi zajęciami zaleca się samodzielną lekturę wskazanego rozdziału literatury oraz powtórzenie zasad tagowania ramek w standardzie IEEE 802.1Q w celu płynnego przejścia do tematyki wirtualnych sieci LAN.

Skróty użyte w tym slajdzie:
ISBN - International Standard Book Number, unikalny międzynarodowy identyfikator wydawnictwa zwartego.
IEEE - Institute of Electrical and Electronics Engineers, międzynarodowa instytucja standaryzacyjna.
PKN - Polski Komitet Normalizacyjny, krajowa jednostka certyfikacji norm technicznych.
HA - High Availability, wysoka dostępność systemów teleinformatycznych.

Podgląd okładki książki