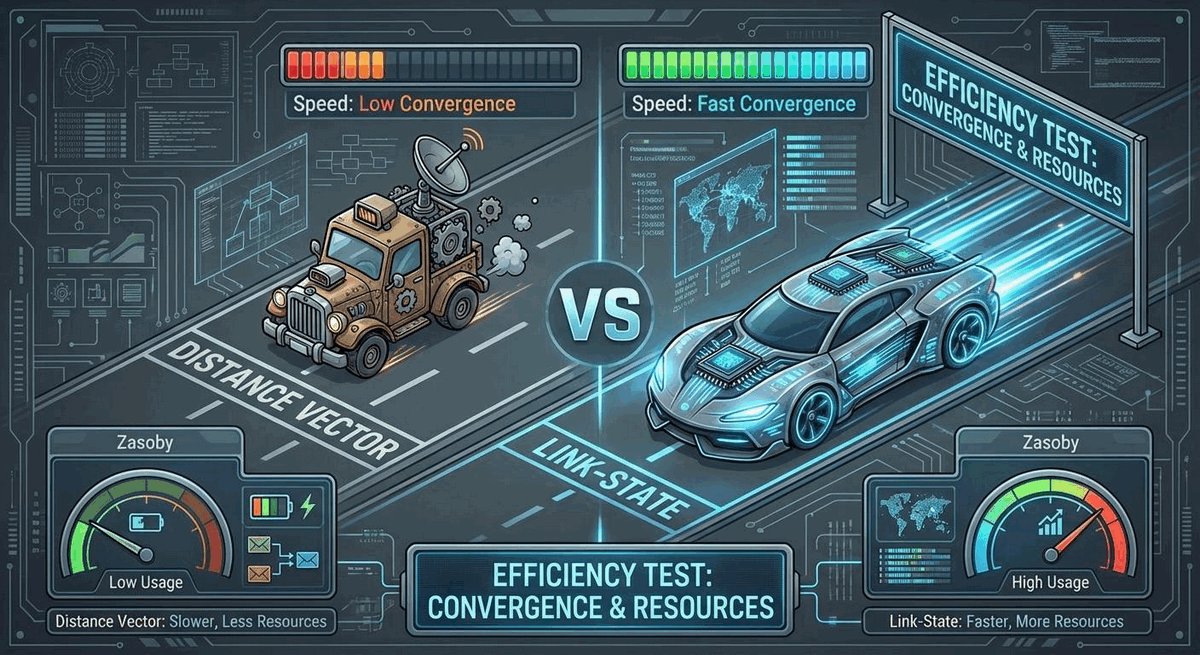
Wykład 7: Podstawy routingu w sieci kampusowej: routing statyczny i dynamiczny

1/52

Podstawy routingu w sieci kampusowej: routing statyczny i dynamiczny

Slajd tytułowy definiujący zakres tematyczny wykładu poświęconego trasowaniu pakietów w warstwie 3.

Wykład 7: Podstawy routingu w sieci kampusowej: routing statyczny i dynamiczny

  • Tytuł wykładu i kontekst inżynierski: podejmowanie decyzji o przekazywaniu pakietów w infrastrukturze wielopodsieciowej.
  • Zakres zagadnień: od anatomii tablicy routingu i reguły Longest Prefix Match, przez routing statyczny i trasy pływające, po koncepcję systemów autonomicznych i rodziny protokołów IGP/EGP.
  • Wprowadzenie fundamentów pod zaawansowane protokoły stanu łącza.
  • Miejsce w programie: fundament warstwy sieciowej kampusu.
Routing pakietów to proces wyznaczania optymalnej ścieżki i przekazywania danych w warstwie sieciowej modelu OSI (L3) pomiędzy logicznie odrębnymi podsieciami IP.
Ilustracja techniczna do slajdu 1: Podstawy routingu w sieci kampusowej: routing statyczny i dynamiczny

Routing w warstwie sieciowej stanowi kluczowy proces decyzyjny gwarantujący wymianę pakietów IP pomiędzy odrębnymi domenami rozgłoszeniowymi i budynkami w kampusie. Odpowiada za łączenie wyizolowanych sieci VLAN w spójny, ogólnouczelniany system teleinformatyczny.

W architekturze szkieletowej inżynier staje przed wyborem pomiędzy deterministycznym, lecz sztywnym routingiem statycznym a dynamicznymi protokołami IGP i EGP. Zrozumienie wewnętrznych mechanizmów podejmowania decyzji przez procesor routera decyduje o stabilności i skalowalności kampusu.

W rzeczywistych instalacjach kampusowych decyzje o trasowaniu łączą się bezpośrednio z segmentacją logiczną zrealizowaną w warstwie 2 za pomocą standardu IEEE 802.1Q. Przełączniki wielowarstwowe (MLS) w węzłach dystrybucyjnych pełnią funkcję bramy domyślnej dla poszczególnych podsieci, realizując routing między VLAN-ami przy użyciu wirtualnych interfejsów SVI (Switched Virtual Interface) lub portów trasowanych (Routed Ports). Dzięki temu ruch lokalny wewnątrz budynku może być filtrowany i izolowany jeszcze przed wejściem do szkieletu sieci, co znacząco odciąża rdzeń i podnosi poziom cyberbezpieczeństwa całego środowiska.

Skróty użyte w tym slajdzie:
RIB (Routing Information Base) - Logiczna tablica routingu w pamięci RAM zawierająca wszystkie trasy wyuczone przez router.
FIB (Forwarding Information Base) - Sprzętowa tablica przekazywania pakietów przechowująca bezpośrednio skompilowane prefiksy dla układów ASIC.
LPM (Longest Prefix Match) - Podstawowa reguła routingu nakazująca wybór wpisu o najdłuższej masce podsieci.
AD (Administrative Distance) - Wskaźnik wiarygodności źródła trasy stosowany do wyboru wpisu przy identycznym prefiksie.
IGP (Interior Gateway Protocol) - Protokół routingu dynamicznego działający wewnątrz pojedynczego systemu autonomicznego.

2/52

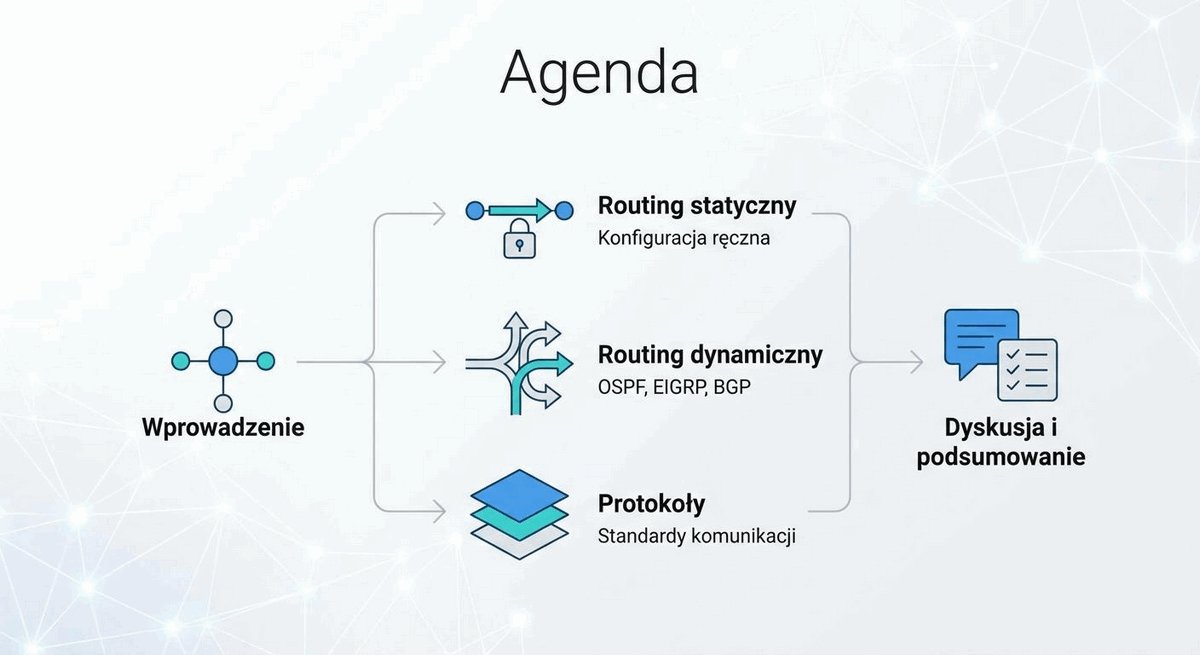
Cel i agenda wykładu

Przedstawienie harmonogramu wykładu i kluczowych zagadnień.

Wykład 7: Cel i agenda wykładu

  • Część 1: rola warstwy 3 i mechanika podejmowania decyzji o trasowaniu.
  • Część 2: anatomia tablicy routingu (RIB/FIB) i reguła najdłuższego dopasowania prefiksu (LPM).
  • Część 3: dystans administracyjny (AD) oraz pojęcie metryki trasy.
  • Część 4: routing statyczny - konfiguracja, trasa domyślna 0.0.0.0/0, trasy pływające i śledzenie IP SLA.
  • Część 5: bilans zalet i ograniczeń routingu statycznego.
  • Część 6: koncepcja routingu dynamicznego i systemy autonomiczne (AS, RFC 1930).
  • Część 7: klasyfikacja protokołów routingu (IGP vs EGP) oraz rodziny Distance Vector vs Link-State.
  • Część 8: mechanizmy zapobiegania pętlom routingu.
  • Część 9: podsumowanie wykładu i wnioski inżynierskie.
Plan wykładu systematyzuje proces poznawczy: rozpoczyna się od analizy struktur tablic routingu (RIB/FIB) i reguły LPM, przez projektowanie tras statycznych i pływających z IP SLA, po architekturę protokołów dynamicznych IGP i EGP.
Ilustracja techniczna do slajdu 2: Cel i agenda wykładu

Agenda wykładu przeprowadza studentów przez całościową teorię i praktykę routingu: od dekompozycji zadań warstwy 3 (wyznaczanie ścieżki vs przełączanie pakietów), przez strukturę tablicy routingu RIB/FIB, aż po bezwzględną nadrzędność reguły Longest Prefix Match.

Druga część modułu poświęcona jest analizie ograniczeń tras statycznych i metod ich monitorowania (IP SLA, Object Tracking, BFD) oraz systematycznemu porównaniu rodzin protokołów dynamicznych: wektora odległości (Distance Vector) i stanu łącza (Link-State) pod kątem odporności na pętle.

Zrozumienie relacji pomiędzy tablicą routingu RIB a tablicą przekazywania FIB pozwala przyszłym inżynierom pojąć, jak nowoczesne przełączniki kampusowe osiągają przepustowości rzędu setek gigabitów na sekundę bez przeciążania jednostki sterującej. Wykład kładzie szczególny nacisk na praktyczne scenariusze awaryjne, w których niewłaściwie dobrana metryka lub brak precyzyjnych tras zapasowych prowadzi do powstawania czarnych dziur (Black Holes) bądź asymetrii ruchu. Pozwoli to studentom zdobyć wiedzę niezbędną do świadomego konfigurowania urządzeń w laboratoriach sieciowych.

Skróty użyte w tym slajdzie:
AS (Autonomous System) - Zbiór sieci IP zarządzanych przez jedną organizację z jednolitymi zasadami routingu (RFC 1930).
ASN (Autonomous System Number) - Unikalny numer identyfikujący system autonomiczny w globalnym routingu BGP.
BGP (Border Gateway Protocol) - Protokół wektora ścieżki (RFC 4271) stanowiący szkielet światowego routingu międzysystemowego.
SPF (Shortest Path First) - Algorytm wyznaczania najkrótszych ścieżek w grafie sieci opracowany przez Edsgera Dijkstrę.
LSA (Link-State Advertisement) - Struktura danych opisująca stan i koszt łącza rozsyłana przez routery w protokołach stanu łącza.

3/52

Wykaz norm i dokumentów IETF RFC

Zestawienie dokumentów normalizacyjnych IETF.

Wykład 7: Wykaz norm i dokumentów IETF RFC

  • Wymagania dla routerów IPv4: IETF RFC 1812, Requirements for IP Version 4 Routers.
  • Koncepcja i wytyczne systemów autonomicznych: IETF RFC 1930, Guidelines for creation, selection, and registration of an Autonomous System (AS).
  • Prywatne pule numerów ASN: IETF RFC 6996, Autonomous System (AS) Reservation for Private Use.
  • Protokół zewnętrzny bramy: IETF RFC 4271, A Border Gateway Protocol 4 (BGP-4).
  • Wytyczne projektowania routingu w sieciach kampusowych.
Normy IETF (RFC 1812, RFC 4632, RFC 5880, RFC 6793) oraz zalecenia CSIRT NASK / CERT Polska i IANA stanowią międzynarodowy fundament standaryzacji procesów routingu i bezpieczeństwa sieci kampusowej.
Ilustracja techniczna do slajdu 3: Wykaz norm i dokumentów IETF RFC

Standaryzacja operacji routingu opiera się na kluczowych dokumentach IETF RFC, w tym specyfikacji wymagań dla routerów IPv4 (RFC 1812), bezklasowego routingu CIDR (RFC 4632) oraz protokołów OSPFv2 (RFC 2328), BGP-4 (RFC 4271) i szybkiej detekcji BFD (RFC 5880).

Wymogi formalne uzupełniają procedury alokacji numerów systemów autonomicznych ASN w rejestrach IANA i RIPE NCC, zalecenia techniczne konsorcjum PIONIER oraz krajowe regulacje z zakresu ciągłości działania i cyberbezpieczeństwa sieci szkieletowych.

Standard RFC 1812 precyzuje obowiązki węzła trasującego w zakresie obsługi nagłówków IPv4, weryfikacji sum kontrolnych oraz bezwzględnego zmniejszania wartości pola Time to Live (TTL) o jedność przed wysłaniem pakietu do kolejnego skoku. W przypadku osiągnięcia wartości zero router ma obowiązek odrzucić pakiet i wygenerować komunikat ICMP Time Exceeded (RFC 792), co zapobiega nieskończonemu krążeniu pakietów w pętlach sieciowych. Z kolei mechanizm BFD, opisany w RFC 5880, uniezależnia czas reakcji protokołów routingu od parametrów warstwy fizycznej, umożliwiając wykrywanie przerw w transmisji w czasie kilkudziesięciu milisekund.

Skróty użyte w tym slajdzie:
IETF (Internet Engineering Task Force) - Międzynarodowy komitet standaryzujący protokoły i architekturę Internetu.
RFC (Request for Comments) - Oficjalny dokument techniczny publikowany przez IETF zawierający standardy sieciowe.
CIDR (Classless Inter-Domain Routing) - Standard bezklasowego adresowania i agregacji tras IP (RFC 4632).
BFD (Bidirectional Forwarding Detection) - Protokół szybkiej detekcji awarii łączy dwupunktowych w czasie poniżej 50 ms (RFC 5880).

4/52

Rola warstwy 3 w architekturze sieci kampusowej

Znaczenie routingu dla łączenia odizolowanych segmentów i obiektów.

Wykład 7: Rola warstwy 3 w architekturze sieci kampusowej

  • Ograniczenie warstwy 2: przełączniki L2 operują wyłącznie w granicach pojedynczej domeny rozgłoszeniowej; nie potrafią podjąć decyzji o przesłaniu pakietu do innej podsieci.
  • Zadanie warstwy 3: logiczne łączenie różnych sieci VLAN, budynków, centrum danych oraz łączy do operatorów internetowych.
  • Niezależność od medium fizycznego: pakiet IP przemieszcza się przez skrętkę, światłowód jednomodowy, fale radiowe Wi-Fi bez naruszenia nagłówka L3.
  • Rola zapory i punktu kontrolnego: granica L3 stanowi naturalne miejsce egzekwowania polityk bezpieczeństwa.
Warstwa 3 (sieciowa) w architekturze hierarchicznej integruje odseparowane segmenty VLAN, ogranicza domeny rozgłoszeniowe i zapewnia kontrolowaną komunikację międzypodsieciową za pomocą przełączników wielowarstwowych MLS i routerów.
Ilustracja techniczna do slajdu 4: Rola warstwy 3 w architekturze sieci kampusowej

Warstwa 3 modelu OSI w kampusie odpowiada za terminację lokalnych domen warstwy 2 na poziomie przełączników dystrybucyjnych oraz zapewnienie skalowalnego transportu pakietów przez rdzeń sieci (Core Layer). Zapewnia logiczną separację podsieci oraz optymalizację tras.

Dzięki zastosowaniu routingu w dystrybucji awarie w warstwie łącza danych (np. niestabilność STP czy burze rozgłoszeniowe w jednym z budynków) zostają ściśle odizolowane i nie rozprzestrzeniają się na pozostałe węzły uczelni, co stanowi fundament stabilności kampusu.

Ograniczenie zasięgu rozgłoszeń warstwy 2 do pojedynczego węzła dystrybucyjnego (Local VLAN model) eliminuje konieczność rozciągania pętli protokołu Spanning Tree (STP) pomiędzy budynkami. W klasycznym projekcie kampusowym Cisco Validated Design (CVD) łącza pomiędzy warstwą dystrybucji a rdzeniem są łączami czysto trasowanymi (Routed Links L3) z punktowymi podsieciami /30 lub /31. Taka architektura pozwala na pełne wykorzystanie wszystkich dostępnych ścieżek fizycznych dzięki mechanizmowi równego kosztu ECMP (Equal-Cost Multi-Path), eliminując blokowanie portów typowe dla protokołu STP.

Skróty użyte w tym slajdzie:
L3 (Layer 3 (Network Layer)) - Warstwa sieciowa modelu OSI odpowiedzialna za logiczne adresowanie pakietów i routing.
L2 (Layer 2 (Data Link Layer)) - Warstwa łącza danych odpowiedzialna za lokalne przełączanie ramek na podstawie adresów MAC.
SVI (Switched Virtual Interface) - Wirtualny interfejs warstwy 3 na przełączniku wielowarstwowym reprezentujący daną sieć VLAN.
MLS (Multilayer Switch) - Przełącznik wielowarstwowy realizujący przełączanie L2 oraz routing pakietów L3 z prędkością łącza.

5/52

Koncepcja routingu: wyznaczanie ścieżki vs przekazywanie pakietu

Rozróżnienie między płaszczyzną sterowania a płaszczyzną danych.

Wykład 7: Koncepcja routingu: wyznaczanie ścieżki vs przekazywanie pakietu

  • Proces wyznaczania ścieżki (Routing / Path Determination): procesy płaszczyzny sterowania (Control Plane) analizujące topologię sieci i budujące tablicę routingu.
  • Proces przekazywania pakietu (Forwarding / Packet Switching): procesy płaszczyzny danych (Data Plane) odpowiedzialne za pobranie pakietu z interfejsu wejściowego, odczytanie docelowego IP, zmianę nagłówka L2 i wysłanie odpowiednim interfejsem wyjściowym.
  • Współczesne przełączniki kampusowe L3 realizują proces Forwarding sprzętowo z prędkością wire-speed (mechanizm CEF).
Architektura współczesnego routera rozdziela płaszczyznę sterowania (Control Plane), odpowiedzialną za wymianę tras i budowę bazy RIB, od sprzętowej płaszczyzny danych (Data Plane / FIB), realizującej przekazywanie pakietów z prędkością łącza.
Ilustracja techniczna do slajdu 5: Koncepcja routingu: wyznaczanie ścieżki vs przekazywanie pakietu

Fundamentalnym pojęciem inżynierskim jest rozdzielenie procesu routingu na dwa odrębne zadania: wyznaczanie ścieżki (Path Determination) oraz przekazywanie pakietów (Packet Forwarding). Wyznaczanie ścieżki to zadanie płaszczyzny sterowania (Control Plane), realizowane przez procesor CPU.

Z kolei przekazywanie pakietów (Data Plane / Forwarding Plane) polega na fizycznym odebraniu ramki, weryfikacji sumy kontrolnej, dekrementacji pola TTL, zmianie nagłówka L2 i wysłaniu pakietu przez interfejs wyjściowy. We współczesnych urządzeniach operacja ta zachodzi sprzętowo z prędkością line-rate (CEF).

W nowoczesnych przełącznikach warstwy 3 płaszczyzna danych jest całkowicie odseparowana od procesora ogólnego przeznaczenia i oparta na układach ASIC (Application-Specific Integrated Circuit) oraz dedykowanych pamięciach TCAM (Ternary Content Addressable Memory). Podczas gdy procesor CPU buduje logiczną tablicę RIB na podstawie wymiany komunikatów routingu, mechanizm Cisco Express Forwarding (CEF) kompiluje te dane do sprzętowej tablicy FIB oraz tablicy sąsiedztwa (Adjacency Table). W rezultacie wyszukiwanie najdłuższego dopasowania prefiksu i przepisanie nagłówka ramki Ethernet odbywa się w jednym cyklu zegarowym bez angażowania systemu operacyjnego.

Skróty użyte w tym slajdzie:
Control Plane (Control Plane) - Płaszczyzna sterowania routera odpowiedzialna za wymianę informacji i budowanie tablic routingu.
Data Plane (Data Plane (Forwarding Plane)) - Płaszczyzna danych odpowiedzialna za bezpośrednie, sprzętowe przekazywanie pakietów przez interfejsy.

6/52

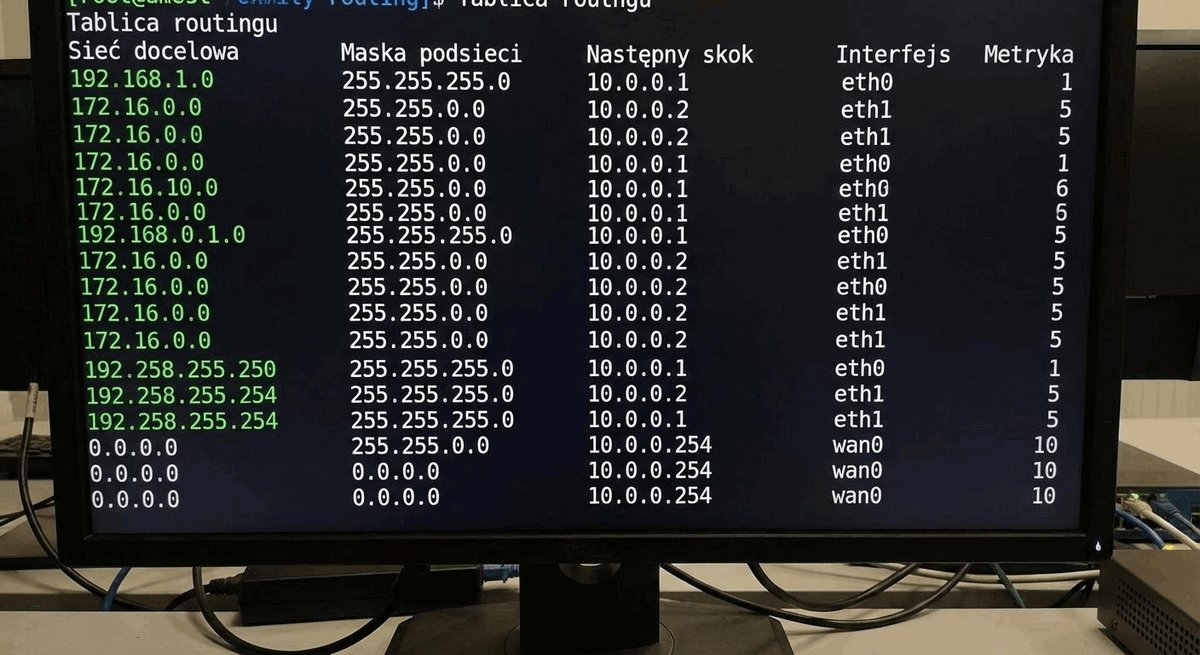
Anatomia tablicy routingu (Routing Table / RIB)

Struktura bazy danych trasowania w pamięci urządzenia.

Wykład 7: Anatomia tablicy routingu (Routing Table / RIB)

  • Pojęcie RIB (Routing Information Base): centralna tablica, w której system operacyjny routera gromadzi najlepsze znane ścieżki do poszczególnych podsieci.
  • Pola pojedynczego wpisu w tablicy routingu:
  • Źródło trasy (kod literowy, np. C, L, S, O, B).
  • Docelowy prefiks sieciowy wraz z długością maski podsieci (np. 10.20.0.0/16).
  • Dystans administracyjny oraz metryka trasy (np. [110/20]).
  • Adres IP następnego skoku (Next-Hop IP Address).
  • Czas obecności wpisu w tablicy (Uptime / Age).
  • Fizyczny lub logiczny interfejs wyjściowy (Outgoing Interface).
Tablica routingu (RIB - Routing Information Base) to przechowywana w pamięci operacyjnej urządzenia logiczna baza wszystkich zweryfikowanych i aktywnych ścieżek sieciowych wraz z ich parametrami metrycznymi i administracyjnymi.
Ilustracja techniczna do slajdu 6: Anatomia tablicy routingu (Routing Table / RIB)

Tablica routingu (RIB - Routing Information Base) to centralna baza wiedzy routera przechowująca zweryfikowane, najlepsze trasy do znanych podsieci docelowych. Każdy wpis w tablicy zawiera prefiks sieci, maskę podsieci, adres następnego skoku (Next-Hop IP) lub interfejs wyjściowy.

Do tablicy RIB trafiają wyłącznie wpisy o najwyższym stopniu zaufania, wybrane na podstawie dystansu administracyjnego spośród informacji dostarczanych przez protokoły dynamiczne, trasy statyczne oraz bezpośrednio połączone łącza fizyczne.

Struktura pojedynczego wpisu w tablicy RIB w systemie Cisco IOS obejmuje kod protokołu (np. C, S, O, D, B), prefiks sieciowy z długością maski, parę wartości w nawiasach kwadratowych oznaczającą dystans administracyjny oraz metrykę trasy (np. [110/20]), adres IP następnego skoku (Next-Hop), czas od ostatniej aktualizacji (Age/Uptime) oraz nazwę interfejsu wyjściowego. Weryfikację zawartości tablicy wykonuje się poleceniem show ip route, które można zawężać za pomocą filtrów protokołowych (np. show ip route ospf lub show ip route static), co stanowi podstawowe narzędzie diagnostyczne inżyniera sieciowego.

Skróty użyte w tym slajdzie:
Next Hop (Next Hop Router) - Adres IP kolejnego urządzenia pośredniczącego na drodze do podsieci docelowej.
Metric (Routing Metric) - Wartość liczbowa obliczana przez protokół routingu służąca do oceny jakości ścieżki.

7/52

Rodzaje wpisów w tablicy routingu: trasy połączone bezpośrednio

Automatyczne wpisy generowane przez aktywne interfejsy.

Wykład 7: Rodzaje wpisów w tablicy routingu: trasy połączone bezpośrednio

  • Trasy bezpośrednio połączone (Connected Networks - kod C w CLI):
  • Warunek powstania: interfejs fizyczny lub logiczny SVI ma skonfigurowany adres IP i znajduje się w stanie operacyjnym Up/Up.
  • Dystans administracyjny: wartość równa 0 (trasa o najwyższym możliwym stopniu zaufania w systemie).
  • Znaczenie: router natychmiast wie, że stacje z tej podsieci znajdują się w bezpośrednim zasięgu łącza i może wysyłać do nich pakiety bezpośrednio na podstawie tablicy ARP.
Trasy połączone (Connected - kod C) to prefiksy podsieci dodawane automatycznie do tablicy routingu w chwili aktywacji i poprawnej konfiguracji fizycznej oraz logicznej interfejsu routera (stan up/up).
Ilustracja techniczna do slajdu 7: Rodzaje wpisów w tablicy routingu: trasy połączone bezpośrednio

Trasy połączone bezpośrednio (Connected Routes, oznaczane literą C) to trasy instalowane automatycznie w tablicy routingu dla podsieci skonfigurowanych bezpośrednio na fizycznych interfejsach routera lub wirtualnych interfejsach SVI przełącznika L3.

Warunkiem pojawienia się wpisu Connected w tablicy RIB jest przejście interfejsu w stan operacyjny up/up (zarówno warstwa fizyczna, jak i protokół łącza danych muszą być aktywne). Trasy połączone mają najwyższy możliwy priorytet (dystans administracyjny równy 0).

Z punktu widzenia działania protokołów trasowania trasy połączone bezpośrednio stanowią korzeń każdego drzewa routingu, ponieważ każdy pakiet opuszczający router musi ostatecznie zostać przekazany przez lokalny interfejs fizyczny. Gdy łącze przechodzi w stan down/down (np. na skutek uszkodzenia światłowodu lub odłączenia kabla miedzianego), system operacyjny routera natychmiast usuwa powiązany wpis Connected z tablicy RIB. To z kolei wymusza natychmiastowe unieważnienie wszystkich tras statycznych i dynamicznych, których adres następnego skoku wskazywał na ten interfejs lub był osiągalny wyłącznie przez tę podsieć.

Skróty użyte w tym slajdzie:
Connected (Directly Connected Network) - Trasa do podsieci bezpośrednio dołączonej do aktywnego interfejsu routera (AD = 0).
Interface (Network Interface) - Fizyczny lub logiczny punkt przyłączenia urządzenia do łącza transmisyjnego.

8/52

Rodzaje wpisów: trasy lokalne (Local)

Precyzyjne trasy do własnych interfejsów routera.

Wykład 7: Rodzaje wpisów: trasy lokalne (Local)

  • Trasy lokalne (Local Networks - kod L w CLI):
  • Wprowadzone w nowoczesnych wersjach systemów operacyjnych (np. Cisco IOS 15.x i nowsze).
  • Maska trasy: zawsze maska pełna `/32` dla IPv4 oraz `/128` dla IPv6.
  • Znaczenie: wskazuje dokładny, unikalny adres IP przypisany do konkretnego interfejsu samego routera.
  • Cel optymalizacyjny: pozwala silnikowi przełączania CEF na natychmiastowe rozpoznanie, że pakiet jest zaadresowany bezpośrednio do samego routera (ruch do procesora) bez konieczności sprawdzania podsieci.
Trasy lokalne (Local - kod L) wprowadzane w systemie Cisco IOS z 32-bitową maską (/32 dla IPv4 lub /128 dla IPv6) reprezentują bezpośredni adres IP przypisany do interfejsu routera, optymalizując obsługę pakietów kierowanych bezpośrednio do urządzenia.
Ilustracja techniczna do slajdu 8: Rodzaje wpisów: trasy lokalne (Local)

Wpisy lokalne (Local Routes, oznaczane literą L) zostały wprowadzone w nowoczesnych wersjach systemu Cisco IOS/IOS-XE. Reprezentują one konkretny adres IP przypisany do interfejsu urządzenia i są instalowane ze stałą maską 32-bitową (/32) dla IPv4 lub 128-bitową (/128) dla IPv6.

Trasy lokalne pozwalają procesorowi przełącznika na natychmiastowe rozpoznanie, że nadchodzący pakiet jest adresowany bezpośrednio do samego routera (ruch do Control Plane), co optymalizuje proces generowania tablicy CEF i zapobiega niepotrzebnemu przetwarzaniu tranzytowemu.

Wprowadzenie tras lokalnych /32 zoptymalizowało architekturę bezpieczeństwa urządzeń sieciowych. Umożliwia to precyzyjne kierowanie ruchu zmierzającego do samego routera - takiego jak sesje SSH, zapytania SNMP czy komunikaty protokołów routingu BGP/OSPF - bezpośrednio do wewnętrznych kolejek procesora CPU nadzorowanych przez mechanizm CoPP (Control Plane Policing). Dzięki temu ruch tranzytowy generowany przez użytkowników nie ma wpływu na stabilność płaszczyzny sterowania, co zapobiega atakom typu odmowa usługi (DoS) polegającym na zalewaniu interfejsów przełącznika pakietami IP.

Skróty użyte w tym slajdzie:
Local Route (Local Host Route) - Automatycznie tworzony wpis z maską /32 (IPv4) lub /128 (IPv6) reprezentujący własny adres IP interfejsu.

9/52

Proces podejmowania decyzji o trasowaniu przez router

Krok po kroku: algorytm analizy przychodzącego pakietu IP.

Wykład 7: Proces podejmowania decyzji o trasowaniu przez router

  • Krok 1: odebranie ramki Ethernet, weryfikacja sumy kontrolnej FCS (uszkodzone ramki są natychmiast odrzucane).
  • Krok 2: zdjęcie nagłówka L2 i odczytanie docelowego adresu IP (Destination IP) z nagłówka L3.
  • Krok 3: dekrementacja pola czasu życia pakietu (Time To Live - TTL); jeśli TTL = 0, pakiet zostaje odrzucony i generowany jest komunikat ICMP Time Exceeded.
  • Krok 4: przeszukanie tablicy routingu za pomocą reguły najdłuższego dopasowania prefiksu.
  • Krok 5: enkapsulacja pakietu w nowy nagłówek L2 (odczytanie MAC docelowego z tablicy ARP/NDP) i wysłanie interfejsem wyjściowym.
Algorytm przekazywania pakietu przez router podlega rygorystycznej hierarchii: absolutny priorytet ma najdłuższe dopasowanie maski (LPM), dystans administracyjny (AD) rozstrzyga wybór między trasami różnych protokołów do tego samego prefiksu, a metryka wskazuje najlepszą ścieżkę wewnątrz protokołu.
Ilustracja techniczna do slajdu 9: Proces podejmowania decyzji o trasowaniu przez router

Proces podejmowania decyzji o przekazaniu pakietu przez router podlega ścisłej, deterministycznej hierarchii algorytmicznej. Po odebraniu pakietu IP router przeszukuje tablicę routingu pod kątem adresu docelowego zawartego w nagłówku pakietu.

Częstym błędem inżynierskim jest mylenie roli dystansu administracyjnego (AD) z dopasowaniem adresu. Router w pierwszej kolejności bezwzględnie stosuje regułę najdłuższego dopasowania prefiksu (Longest Prefix Match - LPM). Parametr AD nie ma żadnego wpływu na dopasowanie pakietu do trasy.

W procedurze analizy pakietu router najpierw weryfikuje sumę kontrolną nagłówka IPv4 (Header Checksum) oraz sprawdza, czy pole TTL jest większe od 1. Jeśli pakiet nie jest uszkodzony i nie uległ przedawnieniu, układ wyszukiwania prefiksów porównuje adres docelowy pakietu ze wszystkimi dostępnymi wpisami w sprzętowej tablicy FIB. Dopiero w sytuacji, gdy w tablicy znajduje się kilka tras o dokładnie takiej samej, najdłuższej długości maski i identycznym dystansie administracyjnym pochodzących z tego samego protokołu, router rozkłada ruch pomiędzy te ścieżki za pomocą algorytmu haszującego w ramach mechanizmu ECMP.

Skróty użyte w tym slajdzie:
Packet Forwarding (Packet Forwarding Engine) - Mechanizm dopasowywania nagłówka pakietu IP do bazy FIB w celu wyboru portu wyjściowego.

10/52

Reguła najdłuższego dopasowania prefiksu (Longest Prefix Match - LPM)

Fundamentalna, żelazna zasada działania każdego routera IP.

Wykład 7: Reguła najdłuższego dopasowania prefiksu (Longest Prefix Match - LPM)

  • Zasada Longest Prefix Match (LPM): router zawsze wybiera ten wpis w tablicy routingu, który ma NAJDŁUŻSZĄ maskę podsieci (najwięcej kolejnych bitów zgodnych z docelowym adresem IP).
  • Bezwzględny priorytet: reguła LPM jest ważniejsza niż dystans administracyjny i ważniejsza niż metryka trasy.
  • Nawet jeśli trasa z dłuższą maską pochodzi z mniej wiarygodnego protokołu (np. RIP) lub ma wyższy koszt, router BEZWZGLĘDNIE wybierze trasę o dłuższej masce.
  • Dopiero w przypadku remisu długości masek router porównuje dystans administracyjny (AD).
Longest Prefix Match (LPM) to żelazna reguła architektury trasowania IP nakazująca routerowi bezwzględny wybór trasy o najdłuższej masce podsieci, bez względu na dystans administracyjny czy źródło pochodzenia wpisu.
Ilustracja techniczna do slajdu 10: Reguła najdłuższego dopasowania prefiksu (Longest Prefix Match - LPM)

Reguła najdłuższego dopasowania prefiksu (Longest Prefix Match - LPM) nakazuje routerowi wybranie tej trasy, której maska podsieci ma najwięcej zgodnych bitów z adresem docelowym pakietu (najbardziej szczegółowa trasa w tablicy routingu).

Dla pakietu zmierzającego na adres 10.1.5.25 trasa 10.1.5.0/24 zostanie wybrana bezwzględnie przed trasą 10.1.0.0/16 oraz trasą domyślną 0.0.0.0/0, niezależnie od tego, z jakiego protokołu pochodzą te wpisy i jaki mają dystans administracyjny.

Reguła LPM wynika wprost ze struktury bezklasowego adresowania CIDR opisanego w standardzie RFC 4632. Matematycznie proces dopasowania polega na wykonaniu operacji bitowego iloczynu logicznego (AND) pomiędzy adresem docelowym pakietu a maską danej trasy i porównaniu wyniku z adresem sieci z tablicy. Wyszukiwanie to realizowane jest od najdłuższych masek (/32) do najkrótszych (/0). Dzięki temu router zawsze preferuje wiedzę bardziej szczegółową, co pozwala administratorom na definiowanie precyzyjnych wyjątków od tras zbiorczych bez modyfikacji całej polityki routingu w kampusie.

Skróty użyte w tym slajdzie:
Prefix Length (Prefix Length) - Liczba bitów maski sieciowej określająca część sieciową adresu IP (np. /24, /28, /30).
Default (Default Route Match) - Dopasowanie do trasy domyślnej 0.0.0.0/0 w przypadku braku bardziej specyficznych wpisów.

11/52

Przykłady działania reguły Longest Prefix Match w praktyce

Analiza konkretnego scenariusza decyzyjnego.

Wykład 7: Przykłady działania reguły Longest Prefix Match w praktyce

  • Docelowy adres IP pakietu: `10.1.5.77`.
  • Dostępne trasy w tablicy routingu:
  • Trasa 1: `0.0.0.0/0` (długość dopasowania 0 bitów - trasa domyślna).
  • Trasa 2: `10.0.0.0/8` (długość dopasowania 8 bitów).
  • Trasa 3: `10.1.0.0/16` (długość dopasowania 16 bitów).
  • Trasa 4: `10.1.5.0/24` (długość dopasowania 24 bity).
  • Trasa 5: `10.1.5.77/32` (długość dopasowania 32 bity - trasa hosta).
  • Decyzja routera: wybór Trasy 5 (maska /32, dopasowanie 32 bity - najbardziej specyficzna ścieżka).
  • Gdyby Trasa 5 nie istniała, pakiet zostałby skierowany zgodnie z Trasą 4 (/24).
W praktyce inżynierskiej reguła LPM gwarantuje, że pakiet adresowany do stacji roboczej zostanie skierowany na trasę dedykowaną (/28 lub /24) zamiast ogólnej trasy nadrzędnej (/16) lub trasy domyślnej (/0).
Ilustracja techniczna do slajdu 11: Przykłady działania reguły Longest Prefix Match w praktyce

Praktyczne zastosowanie reguły LPM widać wyraźnie w sytuacjach awaryjnych oraz przy wdrażaniu polityk Traffic Engineering. Administrator może precyzyjnie przekierować ruch do pojedynczego serwera (trasa hosta /32) innym łączem niż ruch do całej podsieci (/24).

Zrozumienie LPM jest kluczem do unikania pętli transmisyjnych oraz poprawnej interpretacji zachowania tablicy routingu w przypadku współistnienia tras podsumowujących (Summary Routes) i tras specyficznych dla poszczególnych budynków kampusu.

Istotnym aspektem projektowym związanym z LPM jest obsługa tras podsumowujących typu Blackhole i Null0. Jeżeli router dystrybucyjny rozgłasza do rdzenia trasę zbiorczą 10.1.0.0/16, lecz w danym momencie podsieć 10.1.50.0/24 ulegnie awarii, pakiet nadesłany z rdzenia mógłby trafić na trasę domyślną i powrócić do nadawcy, tworząc pętlę. Zainstalowanie lokalnej trasy odrzucającej 10.1.0.0/16 kierującej do interfejsu Null0 gwarantuje, że pakiety do nieistniejących podsieci zostaną natychmiast cicho zutylizowane, podczas gdy pakiety do aktywnych podsieci zostaną poprawnie przekazane zgodnie z regułą najdłuższego dopasowania prefiksu.

Skróty użyte w tym slajdzie:
Specificity (Route Specificity) - Stopień szczegółowości trasy determinowany długością prefiksu maski sieciowej.

12/52

Pojęcie dystansu administracyjnego (Administrative Distance - AD)

Miara wiarygodności źródła informacji o trasie.

Wykład 7: Pojęcie dystansu administracyjnego (Administrative Distance - AD)

  • Problem: router może dowiedzieć się o istnieniu dokładnie tej samej podsieci (z tą samą maską) z kilku różnych źródeł (np. wpis statyczny, protokół OSPF i protokół BGP).
  • Rola dystansu administracyjnego: liczba całkowita z zakresu od 0 do 255 określająca stopień zaufania do danego źródła informacji.
  • Zasada wyboru: im NIŻSZA wartość AD, tym BARDZIEJ WIARYGODNE źródło trasy.
  • Wpis o niższym AD wygrywa i zostaje zainstalowany w tablicy routingu RIB; wpisy o wyższym AD oczekują w rezerwie.
Dystans administracyjny (AD) to wskaźnik wiarygodności źródła informacji o trasie wykorzystywany przez procesor routingu wyłącznie w sytuacji, gdy dwa różne protokoły zgłaszają ścieżkę do identycznego prefiksu o tej samej masce.
Ilustracja techniczna do slajdu 12: Pojęcie dystansu administracyjnego (Administrative Distance - AD)

Dystans administracyjny (AD - Administrative Distance) to wskaźnik zaufania (wiarygodności), jakim router darzy źródło informacji o trasie. Wartość AD mieści się w zakresie od 0 do 255, gdzie niższa wartość oznacza wyższy priorytet zaufania.

Krytyczną zasadą inżynierską jest pamiętanie, że wskaźnik AD jest brany pod uwagę WYŁĄCZNIE wtedy, gdy router odbiera informacje o IDENTYCZNYM prefiksie (ten sam adres sieci i ta sama długość maski) z dwóch różnych źródeł (np. ze statycznej trasy i z protokołu OSPF).

Warto podkreślić, że dystans administracyjny jest parametrem o znaczeniu czysto lokalnym dla danego routera i nie jest nigdzie transmitowany w nagłówkach protokołów sieciowych ani anonsach tras. Oznacza to, że każdy węzeł w sieci może mieć skonfigurowane odmienne wagi zaufania dla poszczególnych źródeł tras. Zdolność inżyniera do modyfikacji domyślnych wartości AD (Distance Manipulation) stanowi potężne narzędzie sterowania ruchem, pozwalające na tworzenie deterministycznych ścieżek zapasowych oraz bezpieczną redystrybucję tras pomiędzy różnymi protokołami routingu bez ryzyka powstania pętli zwrotnych.

Skróty użyte w tym slajdzie:
Trustworthiness (Administrative Trustworthiness) - Względny poziom zaufania nadawany poszczególnym źródłom tras w systemie operacyjnym routera.

13/52

Zestawienie standardowych wartości dystansu administracyjnego

Hierarchia wiarygodności źródeł w systemach sieciowych.

Wykład 7: Zestawienie standardowych wartości dystansu administracyjnego

  • Interfejs połączony bezpośrednio (Connected): AD = 0.
  • Trasa statyczna (Static Route): AD = 1.
  • Protokół eBGP (zewnętrzny BGP): AD = 20.
  • Protokół EIGRP (trasy wewnętrzne): AD = 90.
  • Protokół OSPF: AD = 110.
  • Protokół IS-IS: AD = 115.
  • Protokół RIP: AD = 120.
  • Protokół iBGP (wewnętrzny BGP): AD = 200.
  • Wartość AD = 255: źródło całkowicie niewiarygodne; trasa nigdy nie zostanie zainstalowana w tablicy routingu.
Standardowe wartości AD wahają się od 0 dla tras bezpośrednich, przez 1 dla tras statycznych, 90 dla EIGRP, 110 dla OSPF i 120 dla RIP, aż po 255 dla tras uznawanych za niewiarygodne i ignorowanych przez RIB.
Ilustracja techniczna do slajdu 13: Zestawienie standardowych wartości dystansu administracyjnego

Standardowe wartości dystansu administracyjnego w urządzeniach sieciowych (domyślnie w Cisco IOS) tworzą przejrzystą hierarchię: trasa połączona bezpośrednio (AD=0), trasa statyczna (AD=1), protokół EIGRP (trasa wewnętrzna, AD=90), protokół OSPF (AD=110), IS-IS (AD=115), a protokół RIP (AD=120).

Zewnętrzne trasy BGP (eBGP) mają bardzo wysoki priorytet zaufania (AD=20), natomiast wewnętrzne sesje iBGP charakteryzują się dystansem AD=200. Wartość AD=255 oznacza trasę całkowicie niezaufaną, która nigdy nie zostanie zainstalowana w tablicy RIB.

Różnica w wartościach AD pomiędzy wewnętrznymi protokołami routingu wynika z założeń architektonicznych ich twórców. Dla przykładu, trasy wewnętrzne EIGRP mają AD=90, co stawia je ponad protokołem OSPF (AD=110), z kolei trasy zewnętrzne EIGRP mają domyślnie AD=170, aby zapobiec ich przypadkowemu nadpisaniu przez stabilniejsze trasy wewnętrzne OSPF czy IS-IS. W sieciach kampusowych opartych na sprzęcie wielu producentów należy zachować szczególną ostrożność, ponieważ wartości te mogą się różnić w zależności od systemu operacyjnego (np. w systemach Junos czy Huawei domyślne wagi dla OSPF i tras statycznych mają odmienne wartości fabryczne).

Skróty użyte w tym slajdzie:
Static AD (Static Route Administrative Distance) - Domyślna wartość dystansu administracyjnego dla trasy statycznej (wartość 1).
OSPF AD (OSPF Administrative Distance) - Domyślna wartość dystansu administracyjnego dla tras wyuczonych przez OSPF (wartość 110 w Cisco).
EIGRP AD (EIGRP Administrative Distance) - Domyślny dystans administracyjny dla wewnętrznych tras EIGRP (wartość 90).

14/52

Metryka trasy jako kryterium wyboru wewnątrz protokołu

Sposób wyznaczania najlepszej ścieżki w ramach tego samego źródła.

Wykład 7: Metryka trasy jako kryterium wyboru wewnątrz protokołu

  • Różnica między AD a metryką: AD rozstrzyga spór między RÓŻNYMI protokołami; metryka rozstrzyga spór między RÓŻNYMI ścieżkami w ramach TEGO SAMEGO protokołu.
  • Zasada ogólna: im niższa metryka, tym lepsza ścieżka.
  • Zróżnicowanie metryk w protokołach:
  • RIP: liczba przeskoków (Hop Count, limit 15 routerów).
  • OSPF: koszt odwrotnie proporcjonalny do przepustowości (Cost).
  • EIGRP: złożona formuła uwzględniająca najmniejszą przepustowość łącza i sumę opóźnień.
  • BGP: zestaw atrybutów polityki (Weight, Local Preference, AS-Path, MED).
Metryka trasy to znormalizowana wartość liczbowa obliczana przez dany protokół dynamiczny (np. suma kosztów łączy w OSPF, liczba przeskoków w RIP), pozwalająca na wyznaczenie optymalnej ścieżki spośród tras oferowanych przez ten sam protokół.
Ilustracja techniczna do slajdu 14: Metryka trasy jako kryterium wyboru wewnątrz protokołu

Metryka trasy to wartość liczbowa wykorzystywana przez pojedynczy protokół routingu dynamicznego do porównywania i wyboru najlepszej ścieżki spośród wielu alternatywnych tras prowadzących do tej samej podsieci docelowej.

Każdy protokół stosuje własny, unikalny algorytm wyliczania metryki: protokół RIP bazuje wyłącznie na liczbie przeskoków (Hop Count), protokół OSPF na sumarycznym koszcie przepustowości interfejsów (Cost), a protokół EIGRP na złożonym wzorze uwzględniającym pasmo i opóźnienie.

Ponieważ metryki wyliczane przez różne protokoły opierają się na odmiennych skalach matematycznych, bezpośrednie porównywanie metryki OSPF (np. koszt 10) z metryką RIP (np. 3 przeskoki) jest niemożliwe. Z tego względu procesor routera nigdy nie porównuje metryk pochodzących z różnych protokołów, posługując się wówczas wyłącznie dystansem administracyjnym. W sytuacji, gdy inżynier decyduje się na redystrybucję tras (np. wstrzyknięcie tras OSPF do protokołu BGP), konieczne jest jawne zdefiniowanie metryki początkowej (Seed Metric), bez której proces redystrybucji nie zainstaluje obcych prefiksów w docelowej domenie trasowania.

Skróty użyte w tym slajdzie:
Cost (Link Cost) - Koszt łącza stosowany jako metryka w protokole OSPF obliczany na podstawie pasma referencyjnego.
Hop Count (Hop Count Metric) - Metryka protokołu RIP określająca liczbę routerów tranzytowych na drodze do celu.

15/52

Routing statyczny: definicja, mechanizm i filozofia

Ręczne programowanie ścieżek transmisyjnych przez administratora.

Wykład 7: Routing statyczny: definicja, mechanizm i filozofia

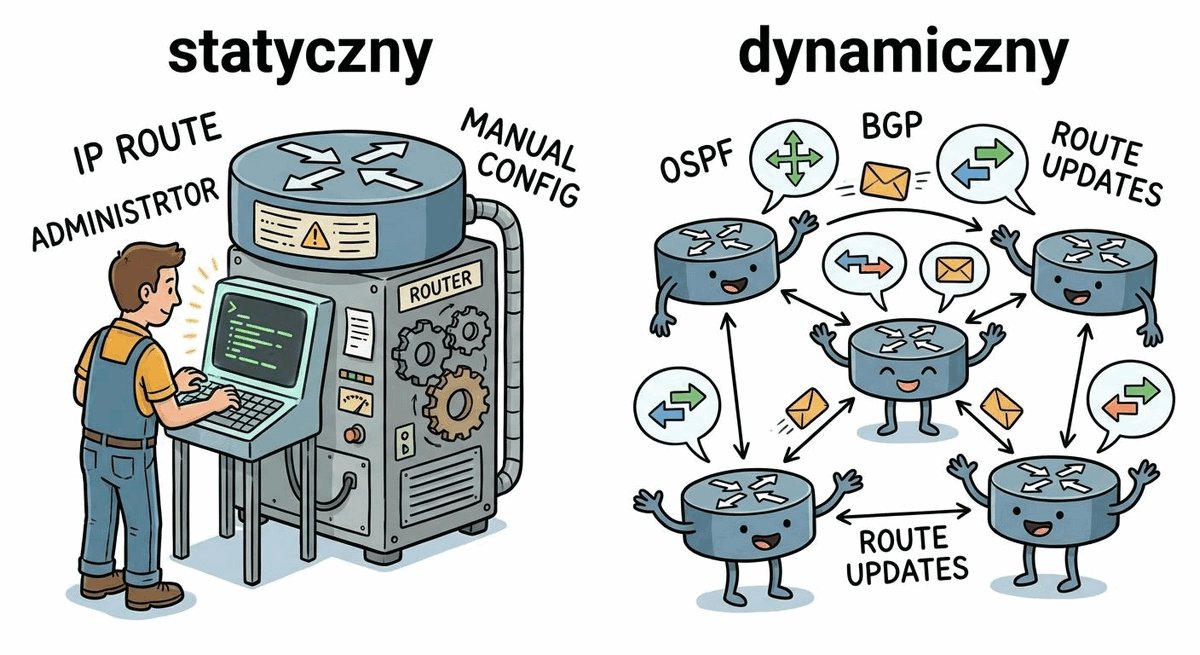
  • Definicja routingu statycznego: bezpośrednie wprowadzanie reguł trasowania do konfiguracji routera przez inżyniera sieciowego.
  • Filozofia: router nie wymienia żadnych komunikatów z sąsiadami; ślepo ufa administratorowi i wysyła pakiety na wskazany adres.
  • Statyczność wpisu: trasa istnieje w tablicy tak długo, jak długo interfejs powiązany ze ścieżką jest fizycznie aktywny (Up/Up).
  • Zastosowanie: małe sieci, proste łącza dostępowe do Internetu, sieci o restrykcyjnych wymogach bezpieczeństwa.
Routing statyczny to deterministyczny model trasowania polegający na ręcznym zdefiniowaniu ścieżek sieciowych przez administratora, zapewniający pełną kontrolę nad ruchem i brak obciążenia procesora pakietami sterującymi.
Ilustracja techniczna do slajdu 15: Routing statyczny: definicja, mechanizm i filozofia

Routing statyczny polega na ręcznym definiowaniu tras w konfiguracji routera przez inżyniera sieciowego za pomocą dedykowanych poleceń CLI. Charakteryzuje się pełnym determinizmem, brakiem narzutu na pasmo transmisyjne (brak pakietów anonsujących) oraz zerowym obciążeniem procesora.

Podejście to sprawdza się znakomicie w małych sieciach, na łączach brzegowych (Stub Networks) oraz w połączeniach do pojedynczego operatora ISP, jednak w rozległym kampusie z setkami podsieci staje się skrajnie trudne w utrzymaniu i podatne na błędy ludzkie.

W architekturze kampusowej routing statyczny znajduje szczególne zastosowanie przy konfiguracji tras do pętli zwrotnych (Loopback), zestawianiu tuneli wirtualnych (np. GRE, IPsec) oraz izolacji urządzeń zarządzających w dedykowanej sieci Out-of-Band (OOB). Brak automatycznej wymiany informacji eliminuje podatność na ataki typu Man-in-the-Middle polegające na zatruwaniu tablic routingu złośliwymi anonsami LSA czy RIP. Wymaga to jednak od zespołu teleinformatycznego prowadzenia ścisłej, sformalizowanej dokumentacji adresacji i procedur zarządzania zmianą (Change Management).

Skróty użyte w tym slajdzie:
Static Routing (Static Routing) - Ręczne definiowanie tras w konfiguracji routera przez administratora sieci.

16/52

Składnia polecenia trasy statycznej

Różnice między wskazaniem adresu następnego skoku a interfejsu wyjściowego.

Wykład 7: Składnia polecenia trasy statycznej

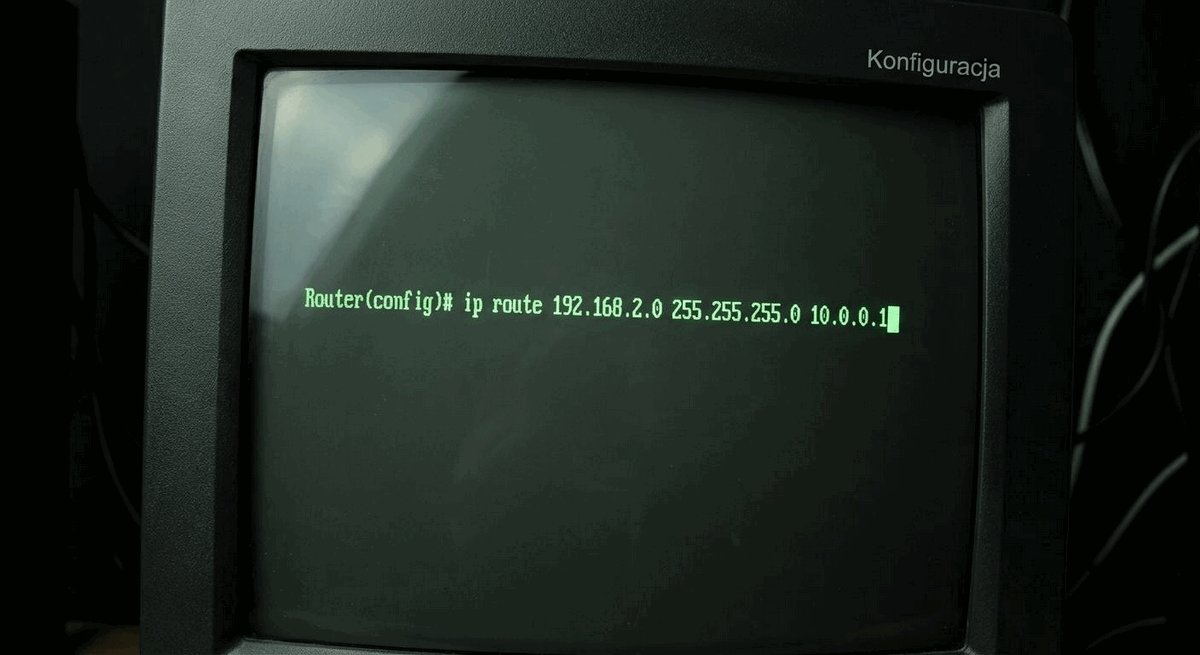
  • Format polecenia (Cisco IOS): `ip route <podsieć_docelowa> <maska> <next-hop | interfejs>`.
  • Wariant z adresem następnego skoku (Next-Hop IP):
  • Przykład: `ip route 10.20.0.0 255.255.0.0 192.168.1.2`.
  • Wymaga procedury wyszukiwania rekurencyjnego (Recursive Lookup): router musi najpierw sprawdzić, jakim interfejsem dotrzeć do adresu 192.168.1.2.
  • Wariant z interfejsem wyjściowym (Directly Attached Static Route):
  • Przykład: `ip route 10.20.0.0 255.255.0.0 GigabitEthernet0/1`.
  • Ostrzeżenie inżynierskie: stosowanie interfejsu wyjściowego typu Ethernet bez wskazania adresu IP powoduje, że router generuje zapytania ARP dla każdego docelowego hosta, co prowadzi do przepełnienia tablicy ARP (ARP Table Exhaustion).
Składnia polecenia trasy statycznej (ip route) wymaga precyzyjnego określenia prefiksu docelowego, maski podsieci oraz parametru przekazywania: adresu IP następnego skoku (Next-Hop IP) lub interfejsu wyjściowego.
Ilustracja techniczna do slajdu 16: Składnia polecenia trasy statycznej

Składnia polecenia konfiguracji trasy statycznej IPv4 w systemie Cisco IOS to: ip route <prefiks> <maska> {Next-Hop_IP | Interfejs_wyjściowy} [dystans]. Wybór pomiędzy wskazaniem adresu IP następnego skoku a nazwą interfejsu ma fundamentalne znaczenie operacyjne.

Wskazanie adresu Next-Hop IP wymaga od routera jednorazowego sprawdzenia osiągalności tego adresu (rekurencja tras). Z kolei wskazanie samego interfejsu wyjściowego jest poprawne wyłącznie na łączach dwupunktowych Point-to-Point (np. łącza szeregowe lub tunele GRE).

Z inżynierskiego punktu widzenia rekurencyjne rozwiązywanie trasy (Recursive Routing Lookup) wymusza na procesorze routera podwójne przeszukanie tablicy RIB w celu odnalezienia fizycznego portu powiązanego z adresem następnego skoku. W klasycznych routerach programowych generowało to zauważalny narzut wydajnościowy, lecz w nowoczesnej architekturze CEF cała rekurencja jest wstępnie skompilowana do tablicy FIB w momencie instalacji trasy. Jeżeli jednak prefiks adresu Next-Hop sam staje się nieosiągalny, trasa statyczna jest natychmiast wycofywana z tablicy FIB, co zapobiega bezproduktywnemu wysyłaniu pakietów w próżnię.

Skróty użyte w tym slajdzie:
CLI (Command Line Interface) - Tekstowy interfejs wiersza poleceń służący do zarządzania i konfiguracji urządzeń sieciowych.
Exit Interface (Outgoing Exit Interface) - Fizyczny interfejs routera, przez który pakiet jest wysyłany do celu.

17/52

Trasa statyczna w pełni określona (Fully Specified Static Route)

Najbardziej poprawna i bezpieczna forma zapisu trasy statycznej.

Wykład 7: Trasa statyczna w pełni określona (Fully Specified Static Route)

  • Koncepcja Fully Specified Static Route: jawne wskazanie ZARÓWNO interfejsu wyjściowego, JAK I adresu IP następnego skoku.
  • Przykład: `ip route 10.20.0.0 255.255.0.0 GigabitEthernet0/1 192.168.1.2`.
  • Zalety inżynierskie:
  • Eliminacja konieczności wyszukiwania rekurencyjnego w tablicy FIB (natychmiastowe przekazanie pakietu).
  • Precyzyjne ograniczenie zapytań ARP wyłącznie do wskazanego adresu routera następnego skoku.
  • Odporność na błędy w środowiskach wielodostępowych Ethernet.
  • W protokole IPv6 w przypadku adresów Link-Local zapis w pełni określony jest wymogiem formalnym.
Trasa statyczna w pełni określona (Fully Specified Static Route) definiuje jednocześnie interfejs wyjściowy oraz adres IP następnego skoku, co jest bezwzględnym wymogiem bezpieczeństwa na łączach wielodostępnych Ethernet w celu zapobiegania burzom Proxy ARP.
Ilustracja techniczna do slajdu 17: Trasa statyczna w pełni określona (Fully Specified Static Route)

Krytycznym błędem inżynierskim jest skonfigurowanie trasy statycznej ze wskazaniem wyłącznie interfejsu wyjściowego na łączu wielodostępnym Ethernet (np. ip route 10.20.0.0 255.255.0.0 GigabitEthernet0/0). Router uznaje wówczas całą podsieć za bezpośrednio połączoną na poziomie L2.

Dla każdego nowego pakietu router wysyła rozgłoszeniowe zapytanie ARP, licząc na odpowiedź Proxy ARP. Prowadzi to do błyskawicznego wyczerpania pamięci tablicy ARP (ARP Table Exhaustion) i załamania pracy CPU. Prawidłowym rozwiązaniem jest podanie adresu Next-Hop IP lub trasa w pełni określona (Fully Specified).

Trasa w pełni określona (Fully Specified Static Route) rozwiązuje problem nieefektywnego rozsyłania zapytań ARP na interfejsach wielodostępnych poprzez podanie w jednej komendzie zarówno interfejsu lokalnego, jak i adresu IP sąsiada: ip route <prefiks> <maska> GigabitEthernet0/0 <next-hop_ip>. W środowiskach IPv6 zastosowanie trasy w pełni określonej jest wymogiem formalnym w sytuacji, gdy adresem następnego skoku jest adres łącza lokalnego (Link-Local fe80::/10). Wynika to z faktu, że ten sam adres łącza lokalnego może występować na wielu różnych interfejsach fizycznych tego samego routera, co uniemożliwia jednoznaczną identyfikację węzła docelowego bez wskazania portu.

Skróty użyte w tym slajdzie:
Fully Specified (Fully Specified Static Route) - Trasa statyczna definiująca jednocześnie interfejs wyjściowy oraz adres IP kolejnego skoku.
Proxy ARP (Proxy Address Resolution Protocol) - Mechanizm (RFC 1027), w którym router odpowiada własnym adresem MAC na zapytania ARP dla obcych podsieci.

18/52

Trasa domyślna (Default Route): brama ostatniej szansy

Trasa obejmująca wszystkie możliwe adresy docelowe w Internecie.

Wykład 7: Trasa domyślna (Default Route): brama ostatniej szansy

  • Definicja trasy domyślnej (Default Route / Gateway of Last Resort): trasa dopasowująca każdy pakiet, dla którego w tablicy routingu nie ma bardziej szczegółowego wpisu.
  • Zapis w IPv4: adres `0.0.0.0` z maską `0.0.0.0` (zapis skrócony `0.0.0.0/0`).
  • Zapis w IPv6: `::/0`.
  • Długość dopasowania LPM: dokładnie 0 bitów (dopasowanie o najniższym priorytecie w sieci).
  • Polecenie konfiguracyjne: `ip route 0.0.0.0 0.0.0.0 203.0.113.1` (gdzie 203.0.113.1 to adres routera operatora ISP).
Trasa domyślna (Default Route: 0.0.0.0/0) to brama ostatniej szansy (Gateway of Last Resort) dopasowująca wszystkie pakiety, dla których w tablicy routingu nie odnaleziono bardziej szczegółowej ścieżki.
Ilustracja techniczna do slajdu 18: Trasa domyślna (Default Route): brama ostatniej szansy

Trasa domyślna (Default Route / Gateway of Last Resort) to specjalna trasa statyczna oznaczana adresem 0.0.0.0 z maską 0.0.0.0 (w notacji CIDR: 0.0.0.0/0). Ma zerową długość maski, przez co dopasowuje się do każdego możliwego pakietu IP.

Zgodnie z regułą Longest Prefix Match trasa domyślna jest wybierana przez router jako ostatnia deska ratunku - wyłącznie wtedy, gdy w tablicy routingu nie istnieje żaden bardziej szczegółowy wpis pasujący do adresu docelowego pakietu.

Z punktu widzenia matematyki prefiks 0.0.0.0/0 oznacza, że router porównuje dokładnie 0 bitów adresu docelowego z zadanym wzorcem, co formalnie czyni każdy możliwy adres IPv4 zgodnym z tą trasą. Ponieważ maska ma długość zero, trasa ta posiada najniższy możliwy priorytet w mechanizmie LPM i zostanie wybrana wyłącznie wtedy, gdy żaden wpis o dłuższej masce nie pasuje do pakietu. W systemie operacyjnym Cisco IOS trasa domyślna jest oznaczana w tablicy symbolem gwiazdki * (np. S*), co sygnalizuje jej rolę jako kandydata na domyślną bramę systemu (Candidate Default).

Skróty użyte w tym slajdzie:
Gateway of Last Resort (Gateway of Last Resort) - Brama ostatniej szansy - trasa statyczna 0.0.0.0/0 kierująca niesklasyfikowany ruch na zewnątrz.
Quad-Zero (Quad-Zero Route) - Potoczne określenie trasy domyślnej o adresie 0.0.0.0 i masce 0.0.0.0 (0.0.0.0/0).

19/52

Zastosowanie trasy domyślnej w sieci kampusowej

Kierowanie ruchu zewnętrznego na brzeg sieci.

Wykład 7: Zastosowanie trasy domyślnej w sieci kampusowej

  • Lokalizacja trasy domyślnej:
  • Na przełącznikach dostępowych i dystrybucyjnych: trasa domyślna wskazuje przełączniki rdzeniowe jako wyjście z budynku.
  • W rdzeniu kampusu: trasa domyślna wskazuje klastry zaporowe i routery brzegowe Enterprise Edge.
  • Na routerze brzegowym: trasa domyślna wskazuje łącze do operatora telekomunikacyjnego (ISP).
  • Dzięki trasie domyślnej przełączniki wewnątrz kampusu nie muszą znać miliona tras z globalnego Internetu.
W środowisku kampusowym trasa domyślna jest konfigurowana na przełącznikach rdzeniowych i routerach brzegowych, kierując cały nieznany ruch wewnętrzny do zapór sieciowych NGFW na styku z siecią Internet.
Ilustracja techniczna do slajdu 19: Zastosowanie trasy domyślnej w sieci kampusowej

W sieci kampusowej trasy domyślne odgrywają kluczową rolę w architekturze przełączników dostępowych i dystrybucyjnych w budynkach wydziałowych. Zamiast utrzymywać pełną wiedzę o tysiącach prefiksów w Internecie, przełącznik budynku ma jedną trasę 0.0.0.0/0 skierowaną do rdzenia.

Z kolei routery brzegowe kampusu (Border Routers) wykorzystują trasę domyślną skierowaną do routera nadrzędnego operatora telekomunikacyjnego (ISP), co dramatycznie zmniejsza rozmiar tablic FIB i upraszcza architekturę szkieletu.

W budynkach kampusowych stosowanie trasy domyślnej jest fundamentem koncepcji Stub Routing, gdzie węzły brzegowe nie uczestniczą w obliczaniu globalnego grafu połączeń. Zmniejszenie rozmiaru tablicy przekazywania FIB do zaledwie kilkunastu wpisów lokalnych oraz jednej trasy 0.0.0.0/0 pozwala na instalację tańszych przełączników dostępowych o mniejszej pamięci TCAM. Jednocześnie wymusza to symetryczną konfigurację ścieżek powrotnych w rdzeniu kampusu, który musi dysponować precyzyjną wiedzą o podsieciach użytkowników zlokalizowanych w poszczególnych obiektach.

Skróty użyte w tym slajdzie:
ISP (Internet Service Provider) - Operator telekomunikacyjny świadczący usługi dostępu do globalnej sieci Internet.
Edge Router (Campus Edge Router) - Router brzegowy kampusu łączący sieć uczelnianą z operatorami zewnętrznymi.

20/52

Trasa podsumowująca (Summary Static Route)

Ręczna agregacja wielu tras statycznych w jeden wpis.

Wykład 7: Trasa podsumowująca (Summary Static Route)

  • Problem: router w budynku A musi przekazywać ruch do czterech podsieci w budynku B: 10.1.0.0/24, 10.1.1.0/24, 10.1.2.0/24 oraz 10.1.3.0/24.
  • Rozwiązanie nieefektywne: wprowadzanie czterech osobnych poleceń `ip route`.
  • Zastosowanie trasy podsumowującej: wyznaczenie wspólnego prefiksu bitowego i utworzenie jednego wpisu: `ip route 10.1.0.0 255.255.252.0 192.168.1.2` (maska /22 obejmuje wszystkie cztery podsieci /24).
  • Korzyści: mniejsza tablica routingu, prostsza konfiguracja, szybsze przeszukiwanie pamięci.
Trasa podsumowująca (Summary Static Route) pozwala na zastąpienie grupy sąsiadujących podsieci jednym zintegrowanym wpisem nadrzędnym (agregacja CIDR), co redukuje rozmiar tablicy RIB i stabilizuje procesy trasowania.
Ilustracja techniczna do slajdu 20: Trasa podsumowująca (Summary Static Route)

Trasa statyczna podsumowująca (Summary Static Route) łączy wiele mniejszych, sąsiadujących podsieci w pojedynczy, nadrzędny prefiks logiczny za pomocą reguł bezklasowej agregacji CIDR (np. połączenie czterech sieci /24 w jeden blok /22).

Wdrożenie tras podsumowujących zmniejsza liczbę wpisów w tablicy RIB, redukuje zużycie pamięci TCAM na przełącznikach dystrybucyjnych oraz przyspiesza proces przeszukiwania bazy FIB przy jednoczesnym ukryciu wewnętrznej struktury budynku przed resztą kampusu.

Prawidłowe wyznaczenie trasy podsumowującej wymaga precyzyjnego doboru granic adresowych (CIDR Boundary). Aby zagregować cztery ciągłe podsieci /24 (np. 10.10.0.0/24, 10.10.1.0/24, 10.10.2.0/24 oraz 10.10.3.0/24) w jeden prefiks 10.10.0.0/22, zmienne bity trzeciego oktetu muszą idealnie wypełniać zakres dwóch bitów od wartości 00 do 11. Błędem projektowym jest agregacja nieciągłych przestrzeni adresowych, co prowadzi do anonsowania obcych podsieci i przechwytywania cudzego ruchu sieciowego, destabilizując komunikację międzywydziałową.

Skróty użyte w tym slajdzie:
Route Aggregation (Route Aggregation / Summarization) - Łączenie wielu sąsiadujących tras składowych w jeden syntetyczny prefiks nadrzędny.

21/52

Pływająca trasa statyczna (Floating Static Route)

Prosty i skuteczny mechanizm tworzenia łącza zapasowego.

Wykład 7: Pływająca trasa statyczna (Floating Static Route)

  • Idea trasy pływającej (Floating Static Route): trasa statyczna skonfigurowana z celowo podwyższonym dystansem administracyjnym (AD większym niż 1).
  • Mechanizm działania:
  • Trasa podstawowa ma standardowy AD = 1 (lub pochodzi z OSPF z AD = 110) i jest aktywnie zainstalowana w tablicy routingu.
  • Trasa pływająca zostaje skonfigurowana z parametrem AD = 200 (np. `ip route 0.0.0.0 0.0.0.0 198.51.100.1 200`).
  • Dopóki łącze główne działa, trasa pływająca pozostaje ukryta i nie przetwarza ruchu.
  • W momencie fizycznej awarii łącza głównego trasa z AD = 1 znika z tablicy, a trasa pływająca natychmiast 'wypływa' i przejmuje transmisję.
Pływająca trasa statyczna (Floating Static Route) to trasa rezerwowa skonfigurowana ze sztucznie zawyżonym dystansem administracyjnym (np. AD=10 lub AD=200), która pozostaje poza tablicą RIB do momentu awarii trasy podstawowej.
Ilustracja techniczna do slajdu 21: Pływająca trasa statyczna (Floating Static Route)

Pływająca trasa statyczna (Floating Static Route) to zaawansowana technika zapewnienia redundancji dla łączy tranzytowych. Jest to zwykła trasa statyczna skonfigurowana ze sztucznie zawyżonym dystansem administracyjnym (np. AD=10 lub AD=200).

Dopóki łącze podstawowe funkcjonuje prawidłowo (trasa z protokołu dynamicznego z AD=110 lub trasa statyczna główna z AD=1), trasa pływająca pozostaje ukryta i nie jest instalowana w tablicy RIB. Aktywuje się automatycznie w ułamku sekundy po awarii ścieżki głównej.

Mechanizm trasy pływającej jest podstawowym narzędziem budowy ekonomicznej redundancji w instalacjach kampusowych, gdzie koszt dzierżawy łącza zapasowego o pełnej przepustowości byłby nieuzasadniony. Przykładowo, administrator konfiguruje symetryczne łącze światłowodowe jako ścieżkę podstawową z domyślnym dystansem AD=1 oraz rezerwowy modem komórkowy LTE/5G lub radiolinię z dystansem AD=200. W normalnych warunkach cały ruch prowadzony jest szybkim łączem przewodowym, a łącze bezprzewodowe nie generuje opłat za transmisję danych aż do chwili fizycznego przerwania światłowodu.

Skróty użyte w tym slajdzie:
Floating Static (Floating Static Route) - Trasa statyczna skonfigurowana z podwyższonym dystansem administracyjnym stanowiąca łącze zapasowe.

22/52

Konfiguracja pływającej trasy statycznej do łącza zapasowego

Scenariusz redundancji dostępu do Internetu w kampusie.

Wykład 7: Konfiguracja pływającej trasy statycznej do łącza zapasowego

  • Topologia: podstawowe łącze światłowodowe do Operatora A (szybkie 10 Gb/s) oraz łącze zapasowe do Operatora B (wolniejsze 1 Gb/s).
  • Reguły konfiguracyjne na routerze brzegowym:
  • Łącze podstawowe: `ip route 0.0.0.0 0.0.0.0 198.51.100.1` (domyślny AD = 1).
  • Łącze zapasowe: `ip route 0.0.0.0 0.0.0.0 203.0.113.1 10` (podwyższony AD = 10).
  • Weryfikacja: polecenie `show ip route` wyświetla tylko trasę przez Operatora A.
  • Symulacja awarii: odłączenie kabla Operatora A powoduje natychmiastowe pojawienie się w tablicy trasy przez Operatora B.
Implementacja pływającej trasy statycznej zapewnia ekonomiczną i niezawodną redundancję dostępu do operatora telekomunikacyjnego (ISP), automatycznie przełączając ruch na łącze zapasowe po wyłączeniu interfejsu głównego.
Ilustracja techniczna do slajdu 22: Konfiguracja pływającej trasy statycznej do łącza zapasowego

Konfiguracja pływającej trasy statycznej jest powszechnie stosowana na stykach z Internetem, gdzie instytucja ma łącze podstawowe o wysokiej przepustowości oraz tańsze łącze zapasowe (Backup Link). Podstawowa trasa domyślna ma AD=1, a zapasowa np. AD=10.

Pływająca trasa statyczna jest jednak nieskuteczna w sytuacji, gdy awaria nie następuje na fizycznym porcie routera, lecz w głębi infrastruktury operatora telekomunikacyjnego.

Przy wdrażaniu pływających tras statycznych szczególną uwagę należy zwrócić na asymetrię routingu (Asymmetric Routing) oraz działanie stanowych zapór ogniowych (Stateful Firewalls). W przypadku przełączenia ruchu na łącze zapasowe pakiety powrotne z Internetu muszą powracać tym samym torem transmisyjnym, w przeciwnym razie zapora ogniowa odrzuci pakiety powrotne z powodu braku powiązanego wpisu w tablicy stanu połączeń. Wymaga to odpowiedniej konfiguracji translacji adresów NAT (Network Address Translation) na obu łączach brzegowych kampusu.

Skróty użyte w tym slajdzie:
Backup Link (Backup Link) - Nadmiarowe łącze transmisyjne aktywowane automatycznie w przypadku awarii łącza głównego.

23/52

Ograniczenie routingu statycznego: problem martwego łącza pośredniego

Główna wada tradycyjnych tras statycznych w sieciach z przełącznikami L2.

Wykład 7: Ograniczenie routingu statycznego: problem martwego łącza pośredniego

  • Problem Black Hole (czarna dziura pakietowa): router jest połączony z modemem operatora kablem Ethernet, który pozostaje w stanie Up/Up.
  • Awaria występuje dalej: koparka przerywa światłowód operatora 2 kilometry od kampusu.
  • Reakcja routera: ponieważ lokalny port Ethernet routera nadal ma zasilanie elektryczne (jest Up), router nie ma pojęcia o awarii odległego łącza i w sposób ciągły wysyła pakiety w nicość.
  • Trasa pływająca nie aktywuje się, ponieważ trasa podstawowa formalnie nie zniknęła z tablicy.
  • Konieczność powiązania trasy statycznej z aktywnym badaniem stanu ścieżki.
Zjawisko cichej awarii łącza tranzytowego (Silent Failure) występuje, gdy uszkodzenie powstaje za urządzeniem dostępowym operatora; port lokalny routera pozostaje w stanie UP, co powoduje powstanie czarnej dziury (Black Hole) dla pakietów.
Ilustracja techniczna do slajdu 23: Ograniczenie routingu statycznego: problem martwego łącza pośredniego

Głównym ograniczeniem klasycznego routingu statycznego jest podatność na ciche awarie łączy pośrednich (Silent Failure / Black Hole). Router uznaje trasę statyczną za aktywną, dopóki interfejs wyjściowy znajduje się w stanie up/up.

Jeśli przełącznik podłączony jest kablem miedzianym do konwertera mediów lub modemu światłowodowego, uszkodzenie traktu optycznego w odległości 2 km nie powoduje wyłączenia portu lokalnego. Router nadal wysyła pakiety w stronę niedziałającego łącza, a trasa zapasowa nigdy się nie aktywuje.

Zjawisko cichej awarii (Silent Failure) stanowi największe zagrożenie dla dostępności usług w sieciach opartych na prostych trasach statycznych. W infrastrukturze miejskiej trakt światłowodowy często przechodzi przez aktywne urządzenia transmisyjne operatora (np. przełączniki dostawcy lub konwertery mediów), które utrzymują nośną L1/L2 na porcie lokalnym routera uczelnianego nawet po całkowitej utracie sygnału w głębi sieci miejskiej. Bez dodatkowych mechanizmów weryfikacji na wyższych warstwach modelu OSI router nie ma technicznej możliwości wykrycia przerwy w dostępie do Internetu.

Skróty użyte w tym slajdzie:
Black Hole (Routing Black Hole) - Zjawisko bezpowrotnego gubienia pakietów kierowanych na nieaktywny węzeł przez statyczną trasę.
Silent Failure (Silent Link Failure) - Awaria łącza pośredniego, która nie powoduje przejścia interfejsu lokalnego w stan down.

24/52

Zaawansowany routing statyczny: mechanizm IP SLA i Object Tracking

Uodpornienie tras statycznych na awarie w głębi sieci operatora.

Wykład 7: Zaawansowany routing statyczny: mechanizm IP SLA i Object Tracking

  • Mechanizm IP SLA (Service Level Agreement): router w tle okresowo wysyła pakiety sondujące (np. ICMP Echo Request - ping) na publiczny adres w Internecie (np. 8.8.8.8) przez łącze podstawowe.
  • Mechanizm Object Tracking (śledzenie obiektu): tworzenie obiektu logicznego powiązanego ze statusem sondy IP SLA.
  • Powiązanie z trasą statyczną: `ip route 0.0.0.0 0.0.0.0 198.51.100.1 track 1`.
  • Działanie automatyczne: jeśli trzy kolejne pingi nie powrócą, sonda IP SLA zgłasza błąd -> obiekt Track 1 przechodzi w stan Down -> trasa podstawowa zostaje natychmiast usunięta z tablicy routingu -> aktywuje się trasa pływająca.
  • Pełna automatyzacja przełączania bez udziału administratora.
  • Składnia integracji IP SLA i Object Tracking: utworzenie sondy ICMP (`ip sla 1`), zdefiniowanie obiektu śledzącego (`track 1 ip sla 1 reachability`) oraz powiązanie z trasą główną i pływającą trasą zapasową z AD=10.
  • Integracja z protokołem BFD (RFC 5880): detekcja awarii łącza w czasie poniżej 50 ms.
Mechanizm integracji IP SLA i Object Tracking eliminuje problem czarnych dziur poprzez aktywne sondowanie dostępności węzłów w chmurze operatora (np. testy ICMP Echo) i natychmiastowe usuwanie tras z RIB po wykryciu awarii.
Ilustracja techniczna do slajdu 24: Zaawansowany routing statyczny: mechanizm IP SLA i Object Tracking

Rozwiązaniem problemu martwych łączy jest integracja tras statycznych z mechanizmem IP SLA (Service Level Agreement) oraz funkcją śledzenia obiektów (Object Tracking). Router uruchamia cykliczną sondę (np. wysyłanie pakietów ICMP Echo do bramy operatora co 5 sekund).

Obiekt śledzący (Track) monitoruje odpowiedź sondy. W przypadku utraty łączności (brak odpowiedzi na ping) mechanizm natychmiast usuwa powiązaną trasę statyczną z tablicy RIB, umożliwiając bezproblemową aktywację pływającej trasy zapasowej.

Konfiguracja mechanizmu IP SLA opiera się na wygenerowaniu sztucznego ruchu testowego o określonym profilu (ICMP Echo, UDP Jitter lub HTTP GET) oraz zdefiniowaniu rygorystycznych progów akceptowalności opóźnień i utraty pakietów. Polecenie track <id> ip sla <numer> reachability wiąże stan logiczny obiektu z wynikami sondy, a wpis trasy statycznej uzupełniany jest o parametr track <id>. Jeżeli sonda nie otrzyma odpowiedzi na zadaną liczbę zapytań (Frequency i Timeout), obiekt przechodzi w stan Down, co wymusza natychmiastowe usunięcie trasy podstawowej z tablicy FIB i bezprzerwowe przełączenie na ścieżkę zapasową.

Skróty użyte w tym slajdzie:
IP SLA (IP Service Level Agreement) - Narzędzie aktywnego monitorowania parametrów sieciowych (opóźnienia, straty, jitter) za pomocą syntetycznych sond.
Object Tracking (Object Tracking Architecture) - Mechanizm śledzenia stanu obiektów (np. wyników sond IP SLA) powiązany z trasami statycznymi.

25/52

Analiza porównawcza routingu statycznego: zalety

Kiedy routing statyczny jest bezkonkurencyjny.

Wykład 7: Analiza porównawcza routingu statycznego: zalety

  • Zerowy narzut procesora (CPU): przełączniki i routery nie wykonują żadnych obliczeń algorytmicznych.
  • Zerowy narzut pasma: brak przesyłania jakichkolwiek pakietów anonsujących (Hello, aktualizacje topologii) przez łącza.
  • Maksymalny determinizm i przewidywalność: administrator ma 100% pewności, którą ścieżką fizyczną podróżują pakiety.
  • Wysokie bezpieczeństwo: brak możliwości wstrzyknięcia fałszywych tras przez intruza w sieci (brak protokołu podatnego na ataki zatruwania tras).
Kluczowe zalety routingu statycznego obejmują całkowitą przewidywalność przepływu ruchu, zerowy narzut pasma na pakiety kontrolne oraz brak obciążenia pamięci RAM i procesora algorytmami wyznaczania tras.
Ilustracja techniczna do slajdu 25: Analiza porównawcza routingu statycznego: zalety

Podsumowując zalety routingu statycznego: gwarantuje on stuprocentową przewidywalność ścieżek, nie generuje żadnego narzutu transmisyjnego na łączach (brak komunikatów Hello i anonsów aktualizacyjnych) oraz nie obciąża pamięci RAM ani procesora routera skomplikowanymi algorytmami.

Dodatkowo cechuje się wysokim bezpieczeństwem - administrator ma całkowitą kontrolę nad przepływem pakietów, eliminując ryzyko wstrzyknięcia fałszywych tras przez nieautoryzowane routery w sieci.

Brak jakichkolwiek procesów obliczeniowych w routingu statycznym sprawia, że jest on niewrażliwy na błędy implementacji oprogramowania protokołów dynamicznych oraz ataki zmierzające do wysycenia zasobów jednostki sterującej. Ponadto deterministyczny charakter ścieżek eliminuje problem przejściowych pętli routingu (Microloops), które mogą pojawiać się w protokołach dynamicznych w trakcie propagacji zmian topologicznych. W kampusowych centrach przetwarzania danych trasy statyczne bywają celowo stosowane do spinania newralgicznych klastrów bazodanowych z dedykowanymi macierzami dyskowymi SAN/NAS.

Skróty użyte w tym slajdzie:
Determinism (Deterministic Forwarding) - Przewidywalność zachowania sieci statycznej wynikająca z precyzyjnie określonych przez inżyniera ścieżek.

26/52

Analiza porównawcza routingu statycznego: wady

Dlaczego nie da się zbudować całego kampusu wyłącznie na trasach statycznych.

Wykład 7: Analiza porównawcza routingu statycznego: wady

  • Brak skalowalności: dodanie nowej sieci VLAN na jednym wydziale wymaga ręcznej rekonfiguracji dziesiątek przełączników w całym kampusie.
  • Wysokie ryzyko błędu ludzkiego: pomyłka w jednej masce podsieci prowadzi do powstawania pętli routingu lub odcięcia całego skrzydła budynku.
  • Brak automatycznej adaptacji: w przypadku skomplikowanych topologii z wieloma trasami alternatywnymi trasy statyczne nie potrafią dynamicznie omijać uszkodzonych węzłów.
  • Wniosek inżynierski: routing statyczny stosujemy wyłącznie na brzegu sieci (trasa domyślna do ISP) oraz na łączach dedykowanych; wewnątrz kampusu bezwzględnie wymagany jest routing dynamiczny.
Głównymi wadami trasowania statycznego są brak automatycznej adaptacji do awarii topologii, wysoki nakład pracy administracyjnej oraz ryzyko błędów ludzkich rosnące wykładniczo wraz ze skalą kampusu.
Ilustracja techniczna do slajdu 26: Analiza porównawcza routingu statycznego: wady

Wadami routingu statycznego są: brak jakiejkolwiek skalowalności (konfiguracja dziesiątek podsieci na setkach przełączników w kampusie jest niewykonalna), wysokie ryzyko błędów ludzkich oraz całkowity brak automatycznej adaptacji do dynamicznych zmian topologii.

Każde dodanie nowej sieci VLAN, zmiana okablowania czy planowa konserwacja urządzenia wymaga ręcznej rekonfiguracji wielu routerów w kampusie, co dyskwalifikuje czysty routing statyczny w sieciach szkieletowych.

W miarę rozbudowy infrastruktury uczelnianej liczba powiązań pomiędzy węzłami rośnie wykładniczo, co przy podejściu statycznym wymusza wprowadzenie setek nowych komend przy każdej instalacji nowego budynku lub wydziału. Złożoność zarządzania (Operational Complexity) prowadzi nieuchronnie do powstawania niespójności konfiguracyjnych, w których poszczególne routery posiadają sprzeczne informacje o topologii sieci. W sytuacji awarii kabla magistralnego brak mechanizmów automatycznego omijania przeszkód paraliżuje pracę tysięcy użytkowników, wymagając natychmiastowej interwencji administratora.

Skróty użyte w tym slajdzie:
Scalability (Routing Scalability Limit) - Ograniczenie skalowalności trasowania statycznego wymagającego ręcznych zmian na każdym węźle przy rozbudowie.

27/52

Wprowadzenie do routingu dynamicznego

Automatyzacja zarządzania ścieżkami w sieci teleinformatycznej.

Wykład 7: Wprowadzenie do routingu dynamicznego

  • Definicja routingu dynamicznego: proces, w którym routery uruchamiają wspólne oprogramowanie (protokół routingu), za pośrednictwem którego samoczynnie wymieniają się informacjami o znanych podsieciach.
  • Samodzielne budowanie mapy sieci: każdy router uczy się topologii od swoich sąsiadów.
  • Automatyczna reakcja na awarie: w momencie uszkodzenia kabla routery natychmiast uzgadniają nową, optymalną ścieżkę omijającą uszkodzony segment bez jakiejkolwiek ingerencji człowieka.
  • Dynamiczny bilans obciążenia: możliwość równoległego wykorzystania wielu ścieżek o jednakowym koszcie (ECMP).
Routing dynamiczny to samoadaptujący się mechanizm sieciowy, w którym routery automatycznie wymieniają informacje o dostępnych podsieciach i awariach za pomocą standaryzowanych protokołów komunikacyjnych.
Ilustracja techniczna do slajdu 27: Wprowadzenie do routingu dynamicznego

Routing dynamiczny rozwiązuje ograniczenia trasowania statycznego poprzez automatyzację wymiany informacji o osiągalności sieci za pośrednictwem wyspecjalizowanych protokołów routingu (Routing Protocols). Urządzenia sieciowe samodzielnie uczą się topologii.

W przypadku awarii kabla światłowodowego lub wyłączenia przełącznika dystrybucyjnego routery automatycznie wykrywają usterkę, rozsyłają zaktualizowane pakiety i wyliczają nowe, bezpętlowe trasy obejściowe bez konieczności jakiejkolwiek ingerencji inżyniera.

Wdrożenie routingu dynamicznego wiąże się z koniecznością alokacji zasobów procesora i pamięci operacyjnej przełączników na potrzeby utrzymywania procesów trasowania i baz sąsiedztwa. Nowoczesne systemy operacyjne stosują separację wątków, dzięki czemu nagłe przeliczenia tras nie wpływają negatywnie na przełączanie pakietów w płaszczyźnie danych. Ponadto dynamiczne protokoły wykorzystują adresy grupowe IP (multicast) do rozsyłania komunikatów sterujących (np. 224.0.0.5 dla OSPF), co eliminuje obciążenie stacji końcowych nieuczestniczących w wymianie informacji o topologii.

Skróty użyte w tym slajdzie:
Dynamic Routing (Dynamic Routing Protocol) - Oprogramowanie routera automatycznie wymieniające informacje o dostępnych podsieciach i awariach.

28/52

Rola protokołów dynamicznych w sieci kampusowej

Utrzymanie ciągłości działania w rozległej strukturze wielobudynkowej.

Wykład 7: Rola protokołów dynamicznych w sieci kampusowej

  • Obsługa setek sieci VLAN i podsieci bez konieczności ręcznego wprowadzania tras.
  • Błyskawiczne wykrywanie awarii przełączników dystrybucyjnych i traktów światłowodowych.
  • Bezpieczna integracja z protokołami redundancji warstwy 2 (Spanning Tree, LACP).
  • Umożliwienie dynamicznej rozbudowy kampusu: podłączenie nowego budynku i uruchomienie na nim protokołu powoduje, że cały kampus natychmiast uczy się nowych tras w ułamku sekundy.
W rozległych kampusach akademickich protokoły dynamiczne zapewniają natychmiastową rekonfigurację ścieżek transmisyjnych po awarii światłowodu, optymalne wykorzystanie łączy nadmiarowych oraz automatyczną dystrybucję nowych segmentów VLAN.
Ilustracja techniczna do slajdu 28: Rola protokołów dynamicznych w sieci kampusowej

Rola protokołów dynamicznych w sieci kampusowej polega na zapewnieniu wysokiej dostępności (HA), deterministycznej zbieżności oraz optymalnego wykorzystania redundantnych traktów światłowodowych łączących budynki wydziałowe z serwerowniami centralnymi.

Protokoły te realizują również równoważenie obciążenia na ścieżkach o jednakowym koszcie (ECMP - Equal-Cost Multi-Path), co pozwala na zwielokrotnienie sumarycznej przepustowości rdzenia sieci bez powstawania pętli w warstwie 3.

Kluczową zaletą dynamicznego trasowania w kampusie jest deterministyczna obsługa asymetrii obciążenia i awarii częściowych. Gdy jeden ze światłowodów w ringu szkieletowym wykazuje błędy CRC lub wysokie tłumienie, dynamiczne protokoły sprzężone z mechanizmami telemetrii potrafią płynnie zdeprymować metrykę wadliwego łącza, kierując strumienie danych na ścieżki alternatywne. Pozwala to na uniknięcie degradacji parametrów jakościowych QoS (Jitter, Packet Loss) dla krytycznych usług akademickich, takich jak wideokonferencje, telefonia VoIP czy transmisje z laboratoriów badawczych.

Skróty użyte w tym slajdzie:
Convergence (Network Convergence) - Stan sieci, w którym wszystkie routery mają spójną i aktualną wiedzę o pełnej topologii połączeń.

29/52

Cechy dojrzałego protokołu routingu

Kryteria inżynierskie oceny protokołów dynamicznych.

Wykład 7: Cechy dojrzałego protokołu routingu

  • Czas zbieżności (Convergence Time): czas, jaki upływa od momentu wystąpienia awarii łącza do momentu, gdy WSZYSTKIE routery w sieci uzgodnią spójną, poprawną tablicę routingu (dążenie do czasów subsekundowych).
  • Skalowalność: zdolność do stabilnej pracy w sieciach liczących setki routerów i tysiące prefiksów.
  • Bezklasowość (Classless): pełna obsługa masek o zmiennej długości (VLSM) oraz agregacji tras CIDR.
  • Efektywność wykorzystania zasobów: minimalne zużycie pamięci RAM, procesora oraz pasma transmisyjnego (unikanie ciągłego rozgłaszania całych tablic).
  • Wsparcie dla kryptograficznego uwierzytelniania sąsiedztwa.
Dojrzały protokół routingu dynamicznego musi cechować się błyskawiczną zbieżnością (Convergence), gwarancją braku pętli L3 (Loop-free), minimalnym narzutem transmisyjnym oraz wsparciem dla szybkiej detekcji BFD (RFC 5880).
Ilustracja techniczna do slajdu 29: Cechy dojrzałego protokołu routingu

Dojrzały protokół routingu dynamicznego musi cechować się trzema kluczowymi właściwościami: minimalnym czasem zbieżności (Fast Convergence), całkowitą odpornością na powstawanie pętli (Loop-Free Architecture) oraz skalowalnością umożliwiającą obsługę setek węzłów.

Współczesnym wymogiem dla sieci kampusowej jest wsparcie dla protokołu szybkiej detekcji uszkodzeń BFD (Bidirectional Forwarding Detection, RFC 5880), który skraca czas wykrycia awarii fizycznej magistrali poniżej 50 milisekund.

Czas zbieżności (Convergence Time) we współczesnej sieci kampusowej mierzony jest w setkach lub dziesiątkach milisekund. Osiąga się to poprzez eliminację tradycyjnych timerów okresowych na rzecz natychmiastowych aktualizacji wyzwalanych zdarzeniami (Triggered Updates) oraz wdrożenie technologii LFA (Loop-Free Alternate) i IP Fast Reroute (IP-FRR). Mechanizm LFA pozwala przełącznikowi obliczyć zapasowy następny skok (Backup Next-Hop) jeszcze przed wystąpieniem awarii, dzięki czemu w momencie wykrycia zaniku sygnału przełączenie ruchu w tablicy FIB następuje sprzętowo w czasie poniżej 50 ms.

Skróty użyte w tym slajdzie:
Loop-free (Loop-Free Topology) - Właściwość protokołu gwarantująca brak powstawania pętli trasowania pakietów w warstwie 3.
Overhead (Protocol Overhead) - Narzut pasma transmisyjnego i zasobów CPU generowany przez pakiety kontrolne protokołu.

30/52

Pojęcie systemu autonomicznego (Autonomous System - AS)

Podział globalnego Internetu i dużych sieci na domeny administracyjne.

Wykład 7: Pojęcie systemu autonomicznego (Autonomous System - AS)

  • Standard IETF RFC 1930: definicja Autonomous System.
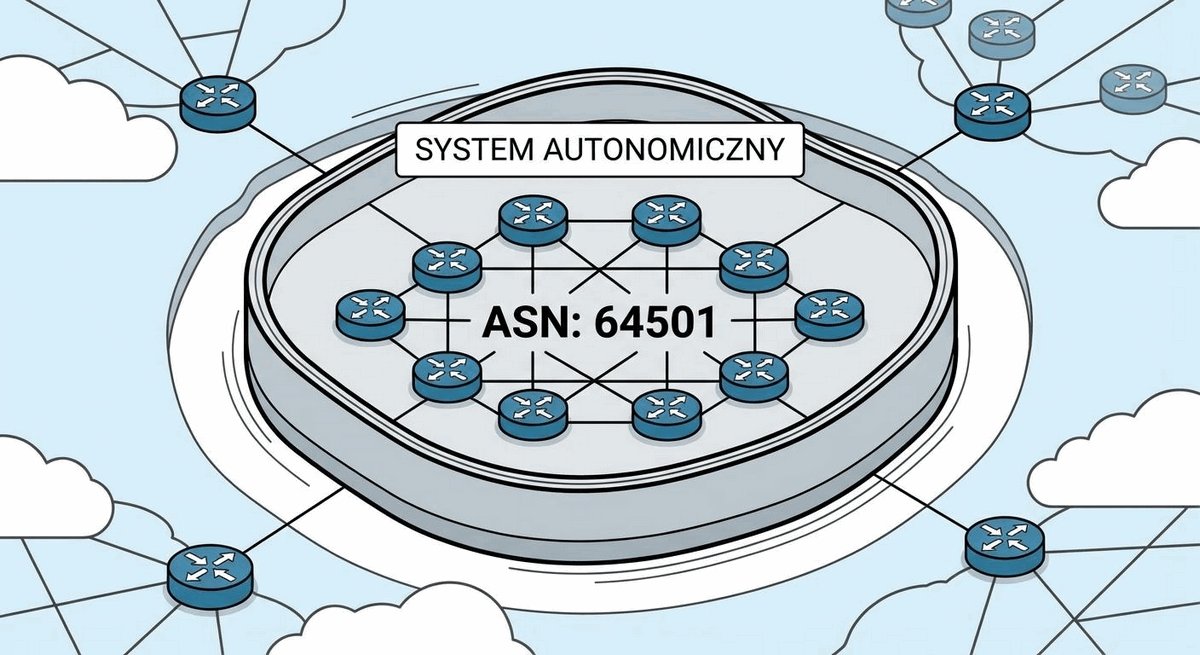
  • Definicja: zbiór sieci IP i routerów zarządzanych przez jedną instytucję lub organizację, mających wspólną, spójną politykę routingu.
  • Przykłady systemów autonomicznych: sieć dużej uczelni (np. Politechnika, Uniwersytet), sieć korporacji, sieć operatora telekomunikacyjnego (ISP).
  • Identyfikacja: każdy publiczny system autonomiczny w Internecie ma unikalny numer ASN (Autonomous System Number) przydzielany przez rejestry regionalne (np. RIPE NCC).
System autonomiczny (Autonomous System, AS) to zbiór sieci IP i urządzeń trasujących, zarządzanych przez pojedynczą instytucję (np. uniwersytet) i podlegających jednolitej polityce routingu i administracji.
Ilustracja techniczna do slajdu 30: Pojęcie systemu autonomicznego (Autonomous System - AS)

Termin system autonomiczny (AS - Autonomous System, RFC 1930) określa zbiór sieci IP oraz urządzeń trasujących zarządzanych przez pojedynczą instytucję (np. uniwersytet) w ramach jednolitej i spójnej polityki administracyjnej i bezpieczeństwa.

Wewnątrz własnego systemu autonomicznego uczelnia wdraża protokoły klasy IGP (np. OSPF), natomiast na styku ze światem zewnętrznym i operatorami nadrzędnymi komunikuje się za pośrednictwem protokołu BGP.

W strukturze organizacyjnej Internetu system autonomiczny musi posiadać spójną, ściśle zdefiniowaną politykę tranzytu. Oznacza to, że z perspektywy zewnętrznych węzłów sieci globalnej cały obszar AS jest postrzegany jako jednolity obiekt administracyjny o określonym zbiorze prefiksów IP. W przypadku uczelni posiadającej kampus rozproszony po całym mieście, poszczególne budynki i wydziały łączone są łączami miejskimi (np. siecią MAN) i włączane do wspólnego uniwersyteckiego systemu autonomicznego, co upraszcza relacje rozliczeniowe (Peering) z operatorami nadrzędnymi.

Skróty użyte w tym slajdzie:
AS Boundary (Autonomous System Boundary) - Granica administracyjna i techniczna oddzielająca domenę autonomicznej sieci od innych organizacji.

31/52

Pule numerów ASN: formaty i zakresy

Ewolucja przestrzeni numeracyjnej systemów autonomicznych.

Wykład 7: Pule numerów ASN: formaty i zakresy

  • Format tradycyjny (2-Byte ASN): 16-bitowe numery od 1 do 65 535 (pula wyczerpana globalnie).
  • Format nowoczesny (4-Byte ASN): 32-bitowe numery od 65 536 do 4 294 967 295 (standard RFC 6793).
  • Zakresy prywatne według RFC 6996 (odpowiednik RFC 1918 dla numerów AS):
  • 16-bitowe prywatne ASN: od 64 512 do 65 534.
  • 32-bitowe prywatne ASN: od 4 200 000 000 do 4 294 967 294.
  • Zastosowanie prywatnych numerów ASN: wewnętrzna organizacja routingu BGP w bardzo dużych kampusach i centrach danych bez konieczności rejestracji w RIPE NCC.
Numery ASN przydzielane są globalnie przez IANA i rejestry RIR w formacie 16-bitowym (1-65535) oraz nowoczesnym 32-bitowym (do 4,29 mld zgodnie z RFC 6793), z wydzieleniem puli do użytku prywatnego.
Ilustracja techniczna do slajdu 31: Pule numerów ASN: formaty i zakresy

Każdy system autonomiczny zarejestrowany w globalnym Internecie identyfikowany jest unikalnym numerem ASN (Autonomous System Number). Historycznie stosowano numery 2-bajtowe (16 bitów, zakres 1-65535, gdzie pula 64512-65534 to numery prywatne).

W obliczu wyczerpania puli standard RFC 6793 wprowadził numery 4-bajtowe (32 bity, do 4,29 mld numerów ASN, pule prywatne 4200000000-4294967294). Duże polskie uczelnie mają własne publiczne numery ASN zarejestrowane w RIPE NCC; przykładem jest AS 8267 (CYFRONET-AS) dla AGH.

Przejście z 16-bitowych numerów ASN na notację 32-bitową wymagało aktualizacji protokołu BGP w celu zapewnienia wstecznej kompatybilności. Standard RFC 6793 zdefiniował specjalny, 16-bitowy numer przejściowy AS 23456 (znany jako AS_TRANS), który jest anonsowany starszym routerom nieobsługującym rozszerzonych formatów. W dokumentacji technicznej i konfiguracjach systemów sieciowych 4-bajtowe numery ASN zapisuje się w formacie dziesiętnym (asplain, np. 4200000000) lub w notacji z kropką (asdot, składającej się z dwóch liczb 16-bitowych oddzielonych kropką: high.low).

Skróty użyte w tym slajdzie:
16-bit ASN (2-Byte Autonomous System Number) - Klasyczny format numeru AS z zakresu 1-65535 zdefiniowany w dokumencie RFC 1930.
32-bit ASN (4-Byte Autonomous System Number) - Rozszerzony format numeru AS z zakresu 65536-4294967295 wprowadzony w dokumencie RFC 6793.
Private ASN (Private AS Number) - Zakres numerów AS zarezerwowanych do użytku prywatnego (np. 64512-65534).

32/52

Klasyfikacja protokołów routingu: IGP vs EGP

Podział protokołów ze względu na granice systemu autonomicznego.

Wykład 7: Klasyfikacja protokołów routingu: IGP vs EGP

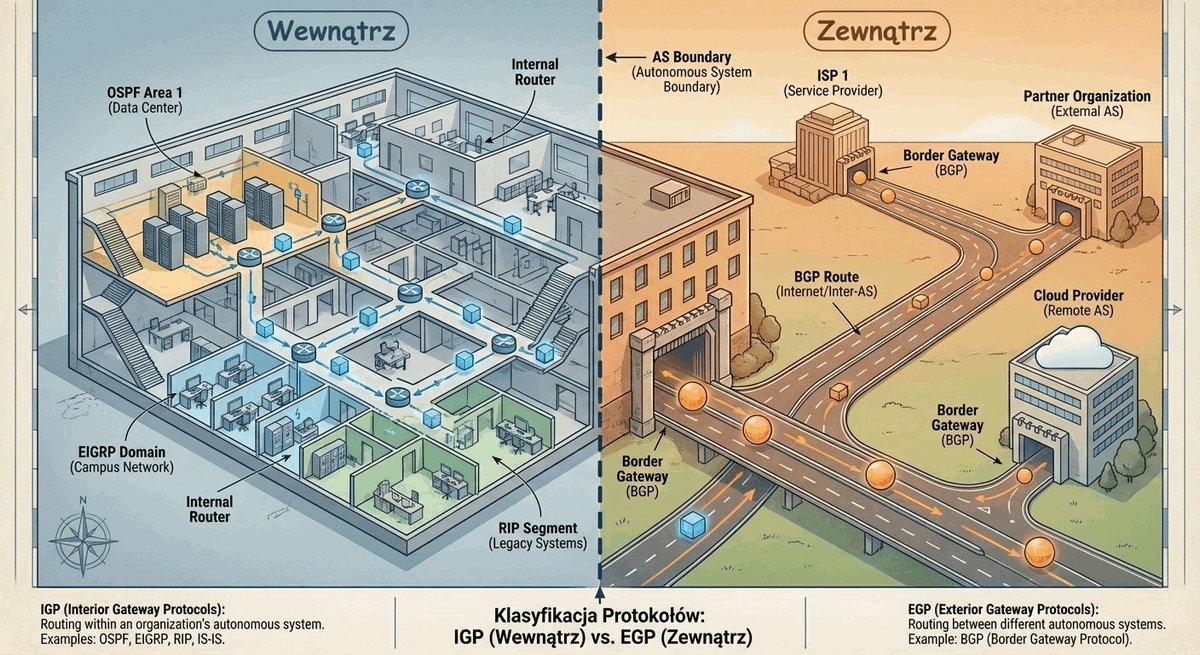
  • Wewnętrzne protokoły bramy (Interior Gateway Protocols - IGP):
  • Zastosowanie: wewnątrz pojedynczego systemu autonomicznego (wewnątrz sieci kampusowej).
  • Cel: maksymalna szybkość zbieżności, wysoka wydajność, szczegółowa znajomość topologii.
  • Przykłady: OSPF, IS-IS, EIGRP, RIP.
  • Zewnętrzne protokoły bramy (Exterior Gateway Protocols - EGP):
  • Zastosowanie: do wymiany informacji o trasach MIĘDZY różnymi systemami autonomicznymi w skali Internetu.
  • Cel: egzekwowanie polityk biznesowych i bezpieczeństwa, skalowalność do miliona tras.
  • Jedyny współczesny standard EGP: protokół BGP-4 (Border Gateway Protocol).
Protokół routingu wewnętrznego (IGP) działa wewnątrz pojedynczego systemu autonomicznego, optymalizując wykorzystanie przepustowości i czas zbieżności, natomiast protokół zewnętrzny (EGP / BGP) zarządza wymianą tras pomiędzy niezależnymi domenami AS.
Ilustracja techniczna do slajdu 32: Klasyfikacja protokołów routingu: IGP vs EGP

Klasyfikacja protokołów routingu opiera się na podziale na protokoły wewnętrzne - IGP (Interior Gateway Protocols) oraz protokoły zewnętrzne - EGP (Exterior Gateway Protocols). Protokoły IGP służą do wyznaczania optymalnych tras WEWNĄTRZ pojedynczego systemu autonomicznego.

Z kolei protokoły EGP odpowiadają za wymianę informacji o prefiksach POMIĘDZY niezależnymi systemami autonomicznymi w skali całego globu. Jedynym funkcjonującym współcześnie standardem EGP jest protokół BGP-4.

Fundamentalna różnica pomiędzy IGP a EGP tkwi w celach algorytmicznych obu rodzin protokołów. Protokoły wewnętrzne skupiają się na szybkości działania, odnajdywaniu najkrótszej ścieżki fizycznej na podstawie czystych parametrów technicznych (szerokość pasma, opóźnienie) oraz natychmiastowej reakcji na zmiany stanu portów. Z kolei protokół zewnętrzny EGP (BGP-4) zaprojektowano do egzekwowania skomplikowanych polityk biznesowych i geopolitycznych, gdzie najkrótsza fizycznie droga może być celowo odrzucana na rzecz trasy tańszej kontraktowo lub bezpieczniejszej jurysdykcyjnie.

Skróty użyte w tym slajdzie:
EGP (Exterior Gateway Protocol) - Klasa protokołów routingu służąca do wymiany tras pomiędzy niezależnymi systemami autonomicznymi (BGP).

33/52

Rola protokołu Border Gateway Protocol (BGP) w kampusie

Zastosowanie protokołu BGP na styku uczelni z Internetem.

Wykład 7: Rola protokołu Border Gateway Protocol (BGP) w kampusie

  • Typowa architektura brzegowa: duża uczelnia ma własny publiczny numer ASN oraz własną pulę publicznych adresów IP (np. blok /16).
  • Scenariusz wielodomowości (Multihoming): kampus jest połączony z dwoma różnymi operatorami ISP (np. sieć PIONIER oraz operator komercyjny Orange/Exatel).
  • Rola protokołu BGP: rozgłaszanie uczelnianej klasy adresowej do obu operatorów jednocześnie.
  • Automatyczna redundancja: w razie awarii łącza do jednego ISP protokół BGP automatycznie kieruje cały ruch przychodzący z Internetu i wychodzący do Internetu przez drugiego operatora.
Protokół Border Gateway Protocol (BGP-4 - RFC 4271) jest standardem de facto na styku sieci kampusowej z operatorami tranzytowymi (eBGP) oraz wewnątrz zaawansowanych rdzeni sieciowych i centrów danych (iBGP).
Ilustracja techniczna do slajdu 33: Rola protokołu Border Gateway Protocol (BGP) w kampusie

Protokół Border Gateway Protocol (BGP-4, RFC 4271) jest protokołem wektora ścieżki (Path Vector). Nie bazuje na prostej metryce technicznej, lecz na bogatym zestawie atrybutów polityki (AS_Path, Local_Preference, MED), umożliwiając sterowanie ruchem tranzytowym.

W sieci kampusowej BGP wdraża się na routerach brzegowych (Edge Routers) podłączonych do co najmniej dwóch niezależnych dostawców Internetu (Multihoming), co zapewnia nieprzerwaną łączność uczelni ze światem w razie awarii jednego z operatorów.

Do zrealizowania pełnego wielodostępu (Multihoming) z wykorzystaniem protokołu BGP kampus akademicki musi dysponować własnym numerem ASN oraz niezależną od operatorów pulą publicznych adresów IP (Provider Independent - PI), przydzieloną przez regionalny rejestr RIPE NCC. Minimalny rozmiar prefiksu IPv4 akceptowany w globalnej tablicy routingu (Global DFZ) wynosi /24, natomiast dla IPv6 jest to blok /48. Wdrożenie BGP w kampusie pozwala administratorom na precyzyjną regulację pasma wejściowego poprzez wydłużanie ścieżki AS_Path (AS-Path Prepending) oraz sterowanie ruchem wychodzącym za pomocą atrybutu Local_Preference.

Skróty użyte w tym slajdzie:
eBGP (External Border Gateway Protocol) - Sesja protokołu BGP nawiązywana pomiędzy dwoma routerami z różnych systemów autonomicznych.
iBGP (Internal Border Gateway Protocol) - Sesja protokołu BGP nawiązywana pomiędzy routerami wewnątrz tego samego systemu autonomicznego.

34/52

Rodziny wewnętrznych protokołów routingu (IGP)

Dwa fundamentalne paradygmaty matematyczne w wyznaczaniu tras.

Wykład 7: Rodziny wewnętrznych protokołów routingu (IGP)

  • Podział protokołów IGP na dwie główne rodziny algorytmiczne:
  • 1. Protokoły wektora odległości (Distance Vector):
  • Algorytm Bellmana-Forda.
  • Przedstawiciele: RIPv1, RIPv2, RIPng, IGRP (oraz zaawansowany wektor odległości: EIGRP).
  • 2. Protokoły stanu łącza (Link-State):
  • Algorytm Dijkstry (Shortest Path First - SPF).
  • Przedstawiciele: OSPFv2, OSPFv3, IS-IS.
  • Fundamentalne różnice w wiedzy o topologii sieci, czasie zbieżności i zapotrzebowaniu na moc obliczeniową.
Wewnętrzne protokoły routingu dzielą się na dwie fundamentalne rodziny algorytmiczne: protokoły wektora odległości (Distance Vector) bazujące na wiedzy od sąsiadów oraz protokoły stanu łącza (Link-State) operujące na pełnym grafie topologii.
Ilustracja techniczna do slajdu 34: Rodziny wewnętrznych protokołów routingu (IGP)

Rodzina wewnętrznych protokołów routingu (IGP) dzieli się na dwie diametralnie różne grupy algorytmiczne: historyczne protokoły wektora odległości (Distance Vector) oraz nowoczesne protokoły stanu łącza (Link-State).

Do grupy wektora odległości zalicza się protokół RIP (Routing Information Protocol) oraz zaawansowany protokół wektora odległości EIGRP (stworzony przez Cisco). Do protokołów stanu łącza należą powszechnie stosowany w kampusach OSPF oraz operatorski IS-IS.

Wybór właściwej rodziny protokołów IGP w projekcie sieci kampusowej determinuje jej przyszłą podatność na rozbudowę. Protokoły wektora odległości, choć prostsze koncepcyjnie, charakteryzują się ograniczeniami matematycznymi uniemożliwiającymi ich skalowanie w nowoczesnych topologiach siatkowych (Mesh) i pierścieniowych. Z kolei protokoły stanu łącza wymagają większych zasobów pamięciowych na przechowywanie bazy LSDB, lecz w zamian oferują matematyczny dowód braku pętli w obrębie danego obszaru, co czyni je niekwestionowanym standardem współczesnej inżynierii kampusowej.

Skróty użyte w tym slajdzie:
Distance Vector (Distance Vector Routing Class) - Klasa protokołów routingu oparta na algorytmie Bellmana-Forda wyznaczająca kierunek i odległość.
Link-State (Link-State Routing Class) - Klasa protokołów routingu oparta na pełnej mapie topologii i algorytmie Dijkstry SPF.

35/52

Protokoły wektora odległości (Distance Vector): filozofia i działanie

Koncepcja kierunku i dystansu w wyznaczaniu ścieżek.

Wykład 7: Protokoły wektora odległości (Distance Vector): filozofia i działanie

  • Znaczenie pojęć:
  • Wektor (kierunek): adres IP sąsiada lub interfejs wyjściowy, przez który należy wysłać pakiet.
  • Odległość (dystans): wartość metryki określająca, jak daleko znajduje się cel (np. liczba routerów pośrednich).
  • Brak wiedzy o topologii: router w protokole Distance Vector nie zna pełnej mapy sieci; wie jedynie, że aby dotrzeć do sieci docelowej, musi wysłać pakiet do sąsiada X, a droga wynosi Y.
  • Filozofia 'Routing by Rumor' (routing przez plotki): router bezkrytycznie ufa informacjom otrzymanym od bezpośrednich sąsiadów.
Filozofia działania protokołów wektora odległości (Distance Vector) opiera się na algorytmie Bellmana-Forda, w którym każdy węzeł cyklicznie anonsuje sąsiadom wektor odległości (kierunek i koszt) do znanych podsieci.
Ilustracja techniczna do slajdu 35: Protokoły wektora odległości (Distance Vector): filozofia i działanie

Filozofia działania protokołów wektora odległości (Distance Vector) opiera się na algorytmie Bellmana-Forda. Router nie ma pełnej wiedzy o mapie sieci ani jej strukturze fizycznej. Wie jedynie, w jakim kierunku (wektor) i w jakiej odległości (dystans / metryka) znajduje się dana podsieć.

Zasada ta jest często określana w literaturze inżynierskiej jako trasowanie oparte na plotkach (Routing by Rumor) - router bezkrytycznie wierzy w informacje przekazywane mu przez bezpośrednio podłączonych sąsiadów.

W protokołach klasy Distance Vector żaden router nie dysponuje wiedzą o pełnym grafie sieci ani o położeniu węzłów pośrednich. Urządzenie zna jedynie własne bezpośrednie łącza oraz ufa wektorom odległości nadsyłanym przez sąsiadów w cyklicznych odstępach czasu. Jeżeli sąsiad zgłosi, że posiada ścieżkę do danej podsieci o metryce 3, router lokalny przyjmuje to za fakt, instaluje trasę ze swoim interfejsem jako wyjściowym i propaguje metrykę 4 do kolejnych urządzeń, bez jakiejkolwiek możliwości zweryfikowania, czy podana droga faktycznie istnieje.

Skróty użyte w tym slajdzie:
Bellman-Ford (Bellman-Ford Algorithm) - Algorytm matematyczny wyznaczania najkrótszych ścieżek w grafach ważonych zorientowany na wektory odległości.

36/52

Zasada Bellmana-Forda: routing przez plotki

Cykl wymiany informacji w tradycyjnych protokołach.

Wykład 7: Zasada Bellmana-Forda: routing przez plotki

  • Mechanizm okresowych aktualizacji (Periodic Updates): router co określony interwał czasu (np. co 30 sekund w RIP) generuje kopię całej swojej tablicy routingu.
  • Rozgłaszanie: tablica routingu jest wysyłana na adres rozgłoszeniowy lub multicast do wszystkich bezpośrednio podłączonych sąsiadów.
  • Działanie sąsiada: odbiera tablicę, dodaje do każdej trasy swój koszt (np. +1 przeskok) i aktualizuje własną tablicę.
  • Wady inżynierskie: ciągłe marnowanie pasma okresowymi rozgłoszeniami, powolna reakcja na zmiany topologii.
Protokół Routing Information Protocol (RIPv2 - RFC 2453) jest klasycznym przedstawicielem protokołów wektora odległości, stosującym liczbę przeskoków (Hop Count) jako jedyną metrykę z ograniczeniem do maksymalnie 15 routerów.
Ilustracja techniczna do slajdu 36: Zasada Bellmana-Forda: routing przez plotki

W klasycznym algorytmie Bellmana-Forda każdy router w sieci cyklicznie (np. co 30 sekund w RIPv2) kopiuje całą swoją tablicę routingu i wysyła ją w postaci anonsu do wszystkich sąsiadów. Sąsiedzi dodają własny koszt do odebranych wpisów i przekazują je dalej.

Brak weryfikacji źródłowej topologii sprawia, że w przypadku awarii łącza w sieci dochodzi do powolnego rozchodzenia się informacji o niedostępności podsieci, co prowadzi do powstawania pętli routingu.

Klasyczna implementacja algorytmu Bellmana-Forda w protokole RIP opiera się na okresowych rozgłoszeniach (Periodic Timers). Co 30 sekund router nadaje cały swój wektor tras na adres rozgłoszeniowy lub grupowy (multicast). Jeżeli przez 180 sekund (Invalid Timer) od danego sąsiada nie nadejdzie potwierdzenie osiągalności trasy, zostaje ona oznaczona jako martwa (metryka 16), a po kolejnych 60 sekundach (Flush Timer) bezpowrotnie usunięta z tablicy. Taki model działania powoduje olbrzymią bezwładność transmisyjną, a czas zbieżności w przypadku rozległej awarii sięga kilku minut.

Skróty użyte w tym slajdzie:
Routing by Rumor (Routing by Rumor) - Określenie działania protokołów Distance Vector, które polegają na niezweryfikowanych anonsach sąsiadów.

37/52

Charakterystyka protokołów wektora odległości

Zalety i ograniczenia architektury Distance Vector.

Wykład 7: Charakterystyka protokołów wektora odległości

  • Zalety: skrajnie prosta implementacja, minimalne wymagania dotyczące pamięci RAM i mocy procesora routera.
  • Główna wada: zjawisko powolnej zbieżności (Slow Convergence).
  • Gdy w odległej części sieci nastąpi awaria, informacja o tym przemieszcza się krok po kroku od sąsiada do sąsiada w kolejnych cyklach aktualizacji.
  • W sieci liczącej kilkanaście routerów czas uzyskania spójności może wynosić kilka minut.
Zjawisko liczenia do nieskończoności (Count to Infinity) to krytyczna podatność algorytmu Bellmana-Forda, prowadząca do powstawania pętli trasowania i stopniowego zwiększania metryki po awarii niedostępnej podsieci.
Ilustracja techniczna do slajdu 37: Charakterystyka protokołów wektora odległości

Głównymi cechami protokołów Distance Vector są: prostota konfiguracyjna, niskie zużycie pamięci RAM na starych routerach oraz długi czas zbieżności (Slow Convergence). Metryką protokołu RIP jest wyłącznie liczba przeskoków (Hop Count), z sztywnym limitem do 15 routerów.

Wartość 16 w protokole RIP oznacza sieć nieosiągalną (Unreachable). Z tego względu protokoły te są całkowicie nieprzydatne w nowoczesnych, rozległych sieciach kampusowych.

Sztywny limit 15 przeskoków (Hop Count) w protokole RIP został wprowadzony celowo jako prymitywny mechanizm ograniczający czas trwania pętli routingu, jednak w realiach współczesnego kampusu obejmującego wiele budynków dyskwalifikuje ten protokół z użycia. Ponadto metryka oparta wyłącznie na liczbie węzłów pośrednich całkowicie ignoruje przepustowość łączy: szybkie łącze światłowodowe 10 Gb/s przechodzące przez dwa przełączniki zostanie ocenione gorzej niż archaiczne łącze miedziane 100 Mb/s realizujące bezpośredni przeskok. W rezultacie ruch kierowany jest ścieżkami o znacznie gorszych parametrach transmisyjnych.

Skróty użyte w tym slajdzie:
Periodic Update (Periodic Full Table Update) - Cykliczne wysyłanie całej tablicy routingu przez interfejsy routera (co 30 s w RIP).

38/52

Problem pętli routingu w Distance Vector: Count to Infinity

Mechanizm powstawania nieskończonej pętli trasowania.

Wykład 7: Problem pętli routingu w Distance Vector: Count to Infinity

  • Zjawisko Count to Infinity (zliczanie do nieskończoności):
  • Awaria sieci: sieć A ulega fizycznemu odłączeniu od Routera 1.
  • Błędna informacja: zanim Router 1 powiadomi o tym Router 2, Router 2 wysyła swoją okresową aktualizację informującą, że zna drogę do sieci A z kosztem 1.
  • Fałszywy wniosek: Router 1 uznaje, że Router 2 ma alternatywną drogę do sieci A, instaluje trasę przez Router 2 z kosztem 2 i odsyła aktualizację.
  • Pętla: Router 2 zwiększa koszt do 3, Router 1 do 4 itd.; pakiety krążą w pętli między routerami, a metryka rośnie w nieskończoność.
  • Konieczność sztucznego ograniczenia maksymalnej metryki (np. w RIP metryka 16 oznacza nieskończoność/sieć nieosiągalną).
Reguła podzielonego horyzontu (Split Horizon) to fundamentalny mechanizm zabezpieczający przed pętlami wektora odległości poprzez zakaz odsyłania informacji o danej trasie przez ten sam interfejs, przez który została ona wyuczona.
Ilustracja techniczna do slajdu 38: Problem pętli routingu w Distance Vector: Count to Infinity

Najgroźniejszym zjawiskiem w protokołach wektora odległości jest problem zliczania do nieskończoności (Count to Infinity). W przypadku odcięcia podsieci sąsiednie routery mogą przekazywać sobie nieaktualne informacje o trasie, stopniowo zwiększając metrykę.

Pakiety danych krążą pomiędzy dwoma routerami w nieskończoność aż do wyzerowania licznika TTL, wysycając pasmo łączy szkieletowych i blokując procesory urządzeń przez kilkadziesiąt sekund lub minut.

Zjawisko Count to Infinity zachodzi wówczas, gdy router po utracie bezpośredniego połączenia z podsiecią odbiera od sąsiada nieaktualny anons, że podsieć ta jest wciąż osiągalna przez niego z metryką o 1 większą. Router lokalny błędnie aktualizuje swoją tablicę, zwiększając metrykę o kolejny przeskok i anonsując ją z powrotem. Urządzenia naprzemiennie podbijają koszt trasy (2, 3, 4... aż do 16), przekazując pakiety użytkowników tam i z powrotem, dopóki licznik nie osiągnie wartości granicznej. W tym okresie łącza są wysycone bezużytecznym ruchem, a usługi sieciowe w danym segmencie całkowicie przestają funkcjonować.

Skróty użyte w tym slajdzie:
Count to Infinity (Count to Infinity Problem) - Anomalia protokołów Distance Vector polegająca na nieskończonym zwiększaniu metryki po awarii podsieci.

39/52

Mechanizmy zapobiegania pętlom: reguła Split Horizon

Podstawowa zasada logiczna w protokołach Distance Vector.

Wykład 7: Mechanizmy zapobiegania pętlom: reguła Split Horizon

  • Reguła podzielonego horyzontu (Split Horizon): router nigdy nie rozgłasza informacji o trasie przez ten sam interfejs fizyczny, z którego tę informację pierwotnie odebrał.
  • Uzasadnienie logiczne: po co mówić sąsiadowi, że potrafimy dotrzeć do danej podsieci, skoro to właśnie ten sąsiad jest dla nas jedyną drogą do niej?
  • Skuteczność: natychmiast eliminuje proste pętle dwuwęzłowe między bezpośrednimi partnerami.
  • Wada: reguła Split Horizon nie zapobiega pętlom trójkątnym obejmującym trzy lub więcej routerów.
Mechanizm zatruwania trasy (Route Poisoning / Poison Reverse) polega na natychmiastowym rozgłoszeniu nieskończonej metryki (np. 16 przeskoków w RIP) po wykryciu awarii łącza, co błyskawicznie unieważnia ścieżkę u sąsiadów.
Ilustracja techniczna do slajdu 39: Mechanizmy zapobiegania pętlom: reguła Split Horizon

W celu ograniczenia powstawania pętli w protokołach Distance Vector zaimplementowano regułę Split Horizon (podzielony horyzont). Głosi ona fundamentalną zasadę: router nigdy nie może rozgłaszać informacji o trasie przez ten sam interfejs, przez który tę trasę poznał.

Split Horizon zapobiega natychmiastowemu odbijaniu nieaktualnych informacji pomiędzy dwoma sąsiednimi routerami, lecz okazuje się niewystarczający w topologiach z pętlami trójkątnymi i pierścieniowymi.

Chociaż reguła Split Horizon skutecznie eliminuje pętle bezpośrednio pomiędzy dwoma węzłami (Ping-Pong Loops), staje się bezradna w obecności pętli o strukturze trójkąta (Triangle Loops). Jeżeli trzy routery połączone są w trójkąt, router A może przesłać trasę do routera B, router B przekaże ją do routera C, a router C z powrotem do routera A przez inny interfejs fizyczny. Ponieważ żaden pakiet nie wraca przez ten sam port, reguła podzielonego horyzontu nie zadziała, a zliczanie do nieskończoności nadal wystąpi, paraliżując transmisję danych w całym pierścieniu.

Skróty użyte w tym slajdzie:
Split Horizon (Split Horizon Rule) - Zasada zabraniająca wysyłania informacji o danej trasie przez ten sam interfejs, przez który została ona wyuczona.

40/52

Mechanizmy zapobiegania pętlom: Poison Reverse i Holddown Timers

Zaawansowane bezpieczniki w protokołach wektora odległości.

Wykład 7: Mechanizmy zapobiegania pętlom: Poison Reverse i Holddown Timers

  • Poison Reverse (zatruwanie trasy): modyfikacja reguły Split Horizon; router odsyła informację przez interfejs wejściowy, ale jawnie ustawia metrykę na nieskończoność (np. 16 w RIP).
  • Gwarancja: natychmiastowe zablokowanie błędnych założeń sąsiada.
  • Holddown Timers (czasy wstrzymania): po odebraniu informacji o awarii router blokuje możliwość przyjęcia jakiejkolwiek nowej ścieżki do tej podsieci na określony czas (np. 180 sekund).
  • Cel Holddown: danie sieci czasu na wygaszenie wszystkich nieaktualnych 'plotek' krążących między węzłami.
  • Wada: drastyczne wydłużenie czasu przywrócenia łączności przy przełączeniu na realną trasę zapasową.
Liczniki wstrzymania (Holddown Timers) blokują przyjmowanie nowych anonsów o wyższej metryce dotyczących trasy oznaczonej jako niedostępna przez określony czas, zapobiegając instalacji przedawnionych informacji w okresie zbieżności.
Ilustracja techniczna do slajdu 40: Mechanizmy zapobiegania pętlom: Poison Reverse i Holddown Timers

Uzupełnieniem reguły Split Horizon są mechanizmy Poison Reverse oraz liczniki czasu wstrzymania (Holddown Timers). Mechanizm Poison Reverse polega na aktywnym odesłaniu informacji o uszkodzonej trasie z metryką nieskończoności (np. Hop=16 w RIP), natychmiast zatruwając ścieżkę.

Z kolei Holddown Timers nakazują routerowi ignorowanie jakichkolwiek nowych anonsów o uszkodzonej podsieci przez określony czas (np. 180 sekund), dając sieci czas na usunięcie starych pakietów z buforów transmisyjnych.

Chociaż Poison Reverse w połączeniu z licznikami Holddown zapobiega powstawaniu pętli w prostych topologiach, wprowadza zjawisko sztucznego opóźnienia w przywracaniu sprawności sieci. Jeżeli uszkodzone łącze powróci do stanu stabilnego po kilku sekundach, router objęty okresem Holddown odrzuci korzystne anonse aż do upłynięcia zadanego czasu. Skutkuje to bezcelowym blokowaniem transmisji danych w sytuacji, gdy infrastruktura fizyczna jest już w pełni operacyjna, co w sieciach o dużym natężeniu ruchu generuje nieakceptowalne straty wydajnościowe.

Skróty użyte w tym slajdzie:
Poison Reverse (Split Horizon with Poison Reverse) - Modyfikacja reguły Split Horizon nakazująca odsyłanie trasy z metryką nieskończoności (16).
Holddown (Holddown Timer) - Mechanizm ignorowania anonsów o gorszej metryce przez określony czas po wystąpieniu podejrzenia awarii.

41/52

Dlaczego protokoły Distance Vector nie nadają się do kampusu

Krytyczna ocena inżynierska technologii wektora odległości.

Wykład 7: Dlaczego protokoły Distance Vector nie nadają się do kampusu

  • Protokół RIPv1 / RIPv2: metryka oparta wyłącznie na liczbie przeskoków ignoruje przepustowość łączy (traktuje łącze 10 Mb/s tak samo jak światłowód 100 Gb/s).
  • Maksymalny limit 15 przeskoków uniemożliwia zastosowanie w rozległych kampusach.
  • Czas zbieżności liczony w dziesiątkach sekund lub minutach jest niedopuszczalny dla współczesnych aplikacji.
  • EIGRP: zaawansowany protokół Cisco, wysoce wydajny, ale przez lata o charakterze własnościowym, co ograniczało interoperacyjność w heterogenicznych środowiskach akademickich.
  • Współczesny standard sieci kampusowej: bezwzględna dominacja protokołów stanu łącza (Link-State).
Enhanced Interior Gateway Routing Protocol (EIGRP) to zaawansowany protokół wektora odległości (hybrydowy) wykorzystujący algorytm DUAL, oferujący błyskawiczną zbieżność dzięki wyznaczaniu ścieżek zapasowych (Feasible Successor).
Ilustracja techniczna do slajdu 41: Dlaczego protokoły Distance Vector nie nadają się do kampusu

Wszystkie te protezy inżynierskie (Split Horizon, Poison Reverse, Holddown) sprawiają, że czas osiągnięcia zbieżności po awarii w protokołach Distance Vector wynosi od kilkudziesięciu sekund do kilku minut. W środowisku uczelnianym oznacza to zerwanie połączeń VoIP, sesji wideokonferencyjnych i połączeń z bazami danych.

Z tego względu klasyczne protokoły wektora odległości (takie jak RIPv1/RIPv2) zostały uznane za przestarzałe i nie są stosowane w projektowaniu współczesnych szkieletów kampusowych.

Współczesne sieci kampusowe charakteryzują się dynamicznym ruchem wirtualnych maszyn, transmisjami wideo w rozdzielczości 4K/8K oraz obecnością setek punktów dostępowych Wi-Fi 6/7. W takich warunkach zbieżność mierzona w minutach prowadzi do masowego zrywania sesji TCP i załamania usług uwierzytelniania RADIUS/802.1X. Z tego względu protokoły Distance Vector zachowują obecnie znaczenie jedynie historyczne i edukacyjne, służąc studentom jako model poglądowy do zrozumienia ewolucji algorytmów trasowania.

Skróty użyte w tym slajdzie:
RIP (Routing Information Protocol) - Historyczny protokół wektora odległości zdefiniowany w normach RFC 1058 (v1) oraz RFC 2453 (v2).

42/52

Protokoły stanu łącza (Link-State): rewolucja w trasowaniu

Przejście od plotek do pełnej cyfrowej mapy sieci.

Wykład 7: Protokoły stanu łącza (Link-State): rewolucja w trasowaniu

  • Filozofia stanu łącza: zamiast ufać wyliczonym trasom sąsiada, każdy router zbiera informacje o bezpośrednim stanie swoich łączy i rozgłasza je w niezmienionej formie do WSZYSTKICH routerów w domenie.
  • Wspólna baza wiedzy: każdy router w obszarze ma w pamięci IDENTYCZNĄ bazę danych o topologii sieci.
  • Zdolność do samodzielnego myślenia: każdy router samodzielnie oblicza najlepszą ścieżkę do każdego celu, analizując kompletną mapę powiązań.
  • Główny przedstawiciel standardu otwartego: protokół OSPF (Open Shortest Path First).
Protokoły stanu łącza (Link-State) opierają się na niezależnej rekonstrukcji pełnej topologii sieci przez każdy węzeł, co gwarantuje natychmiastową zbieżność, brak pętli L3 oraz wysoką skalowalność w dużych kampusach.
Ilustracja techniczna do slajdu 42: Protokoły stanu łącza (Link-State): rewolucja w trasowaniu

Protokoły stanu łącza (Link-State Protocols) dokonały prawdziwej rewolucji w inżynierii sieciowej. Zamiast wymieniać całe tablice routingu i wierzyć sąsiadom na słowo, routery Link-State anonsują wyłącznie stan swoich bezpośrednio połączonych interfejsów (Link States).

Każdy router wysyła małe pakiety anonsów LSA (Link-State Advertisements), które są zalewane w niezmienionej postaci (flooded) do wszystkich pozostałych węzłów w danym obszarze sieci, gwarantując pełną synchronizację wiedzy.

Fundamentalną innowacją wprowadzoną przez protokoły stanu łącza jest oddzielenie mechanizmu odkrywania topologii od procedury wyznaczania ścieżek. W odróżnieniu od podejścia wektora odległości, w którym router bezpośrednio instalował trasy sugerowane przez sąsiada, węzeł Link-State otrzymuje czyste dane o stanie fizycznym elementów infrastruktury. Pozwala to na zaimplementowanie zaawansowanych mechanizmów inżynierii ruchu (MPLS-TE, Segment Routing), w których ścieżki mogą być wyznaczane z uwzględnieniem dodatkowych ograniczeń pasmowych lub opóźnień transmisyjnych.

Skróty użyte w tym slajdzie:
LSDB (Link-State Database) - Zsynchronizowana baza danych wszystkich routerów zawierająca pełną topologię sieci i relacje sąsiedztwa.

43/52

Pakiety anonsów stanu łączy (LSA) i procedura zalewania

Mechanizm niezawodnej dystrybucji informacji topologicznej.

Wykład 7: Pakiety anonsów stanu łączy (LSA) i procedura zalewania

  • Pojęcie LSA (Link-State Advertisement): mały pakiet danych zawierający informacje o routerze, jego aktywnych interfejsach, podłączonych podsieciach oraz koszcie łączy.
  • Procedura zalewania (Flooding): router po wykryciu zmiany natychmiast wysyła pakiet LSA do wszystkich sąsiadów.
  • Każdy sąsiad zapisuje kopię LSA w swojej bazie i NATYCHMIAST przesyła go dalej przez wszystkie pozostałe interfejsy.
  • Brak modyfikacji treści: pakiety LSA docierają do najdalszego zakątka sieci w ciągu kilku milisekund w postaci nienaruszonej.
  • Potwierdzenia LSAck gwarantujące niezawodność dostarczenia.
Baza stanu łącza (LSDB - Link-State Database) jest synchronizowana pomiędzy routerami za pomocą pakietów LSA (Link-State Advertisement); identyczna zawartość bazy LSDB na wszystkich węzłach stanowi warunek spójności routingu.
Ilustracja techniczna do slajdu 43: Pakiety anonsów stanu łączy (LSA) i procedura zalewania

Pakiety anonsów stanu łączy (LSA / LSP) zawierają informacje o identyfikatorze routera, typie łącza, skonfigurowanej podsieci IP, stanie operacyjnym oraz koszcie przepustowości interfejsu.

Procedura zalewania (Reliable Flooding) gwarantuje, że każda zmiana topologii jest propagowana w ułamku sekundy do wszystkich węzłów, a mechanizm potwierdzeń i numeracji sekwencyjnej eliminuje ryzyko zagubienia lub przetworzenia przestarzałych pakietów.

Aby zapobiec powstawaniu pętli transmisyjnych w trakcie zalewania komunikatami LSA, każdy anons opatrzony jest unikalnym nagłówkiem zawierającym 32-bitowy numer sekwencyjny (Sequence Number), sumę kontrolną oraz pole wieku (LSA Age). Router odbierający anons porównuje jego numer sekwencyjny z zawartością własnej bazy; jeżeli rekord jest nowszy, baza zostaje zaktualizowana, a pakiet bezzwłocznie przesłany przez wszystkie pozostałe porty operacyjne. Jeżeli rekord jest identyczny lub starszy, pakiet jest natychmiast cicho odrzucany, co gwarantuje stabilność procesu zalewania.

Skróty użyte w tym slajdzie:
Flooding (LSA Flooding Process) - Niezawodna procedura rozsyłania pakietów stanu łącza do wszystkich węzłów w danym obszarze sieci.

44/52

Baza danych stanu łączy (LSDB) jako cyfrowa mapa kampusu

Struktura grafu sieciowego w pamięci routera.

Wykład 7: Baza danych stanu łączy (LSDB) jako cyfrowa mapa kampusu

  • Pojęcie LSDB (Link-State Database): uporządkowany zbiór wszystkich odebranych pakietów LSA.
  • Odpowiednik mapy drogowej: węzły grafu reprezentują routery, a krawędzie grafu reprezentują łącza sieciowe o określonym koszcie.
  • Identyczność baz: w prawidłowo działającym obszarze OSPF wszystkie routery mają w 100% zsynchronizowaną, identyczną bazę LSDB.
  • Wgląd w całą topologię: router widzi nie tylko bezpośrednich sąsiadów, ale każdy przełącznik i kabel w danej domenie.
Algorytm Dijkstry (SPF - Shortest Path First) przetwarza bazę danych topologii LSDB, budując drzewo najkrótszych ścieżek z bieżącego routera jako korzenia do każdego węzła docelowego w sieci.
Ilustracja techniczna do slajdu 44: Baza danych stanu łączy (LSDB) jako cyfrowa mapa kampusu

Wszystkie odebrane pakiety LSA są gromadzone w zintegrowanej bazie danych stanu łączy - LSDB (Link-State Database). Fundamentalną właściwością protokołów stanu łącza jest to, że każdy router w danym obszarze (Area) ma IDENTYCZNĄ bazę LSDB.

Baza LSDB stanowi dokładną, cyfrową mapę całej sieci kampusowej, zawierającą pełen graf wierzchołków (routerów) i krawędzi (łączy światłowodowych wraz z ich wagami metrycznymi).

Tożsamość bazy danych LSDB na wszystkich węzłach w ramach pojedynczego obszaru jest matematycznym warunkiem koniecznym do prawidłowego działania sieci. Gdyby jakikolwiek przełącznik dysponował niekompletną lub zniekształconą bazą, wyliczone przez niego drzewo ścieżek byłoby niespójne z decyzjami sąsiadów, co mogłoby doprowadzić do powstania pętli w warstwie 3. Weryfikację spójności bazy administrator może przeprowadzić w CLI za pomocą polecenia show ip ospf database, porównując sumy kontrolne bazy LSDB pomiędzy poszczególnymi urządzeniami.

Skróty użyte w tym slajdzie:
Topology Map (Network Topology Map) - Wewnętrzna reprezentacja grafu połączeń sieciowych tworzona na podstawie bazy LSDB.

45/52

Algorytm Dijkstry: obliczanie najkrótszej ścieżki (SPF)

Matematyczny fundament działania protokołów stanu łącza.

Wykład 7: Algorytm Dijkstry: obliczanie najkrótszej ścieżki (SPF)

  • Algorytm Shortest Path First (SPF) został opracowany przez Edsgera Dijkstrę w 1956 roku.
  • Zasada działania: router umieszcza samego siebie w korzeniu (Root) wirtualnego drzewa i analizuje bazę LSDB.
  • Iteracyjne wyznaczanie ścieżek: algorytm bada koszty dotarcia do kolejnych węzłów i wybiera ścieżki o najniższej sumarycznej metryce.
  • Budowa drzewa SPF (SPF Tree): logiczne drzewo niezawierające żadnych pętli, wskazujące najkrótszą drogę do każdej podsieci w kampusie.
Open Shortest Path First (OSPFv2 - RFC 2328) to otwarty standard protokołu stanu łącza, stanowiący fundament trasowania w kampusach korporacyjnych i akademickich dzięki hierarchicznemu podziałowi na obszary (Areas).
Ilustracja techniczna do slajdu 45: Algorytm Dijkstry: obliczanie najkrótszej ścieżki (SPF)

Posiadając kompletną mapę sieci w bazie LSDB, każdy router uruchamia niezależnie matematyczny algorytm Dijkstry - Shortest Path First (SPF). Algorytm ten analizuje graf topologii i wyznacza drzewo najkrótszych ścieżek bez pętli (SPF Tree), stawiając lokalny router w roli korzenia (Root).

Wyliczone w ten sposób optymalne ścieżki do każdej podsieci docelowej są natychmiast instalowane w tablicy routingu RIB oraz sprzętowej tablicy przekazywania FIB w pamięci TCAM.

Złożoność obliczeniowa klasycznego algorytmu Dijkstry wynosi O(V^2), gdzie V to liczba wierzchołków (routerów) w sieci, jednak nowoczesne implementacje z użyciem kolejek priorytetowych opartych na strukturze kopca (Fibonacci Heap) redukują ten czas do poziomu O(E + V log V), gdzie E oznacza liczbę krawędzi (łączy). Oznacza to, że nawet w topologiach liczących setki węzłów procesor przełącznika jest w stanie przeliczyć pełne drzewo SPF w czasie ułamka milisekundy, co stanowi fundament natychmiastowej reakcji na zmiany stanu środowiska transmisyjnego.

Skróty użyte w tym slajdzie:
Dijkstra (Dijkstra SPF Algorithm) - Algorytm matematyczny obliczający drzewo najkrótszych ścieżek z bieżącego węzła do wszystkich węzłów docelowych.

46/52

Niezależne obliczenia drzewa SPF przez każdy węzeł

Samodzielność i determinizm każdego routera w sieci.

Wykład 7: Niezależne obliczenia drzewa SPF przez każdy węzeł

  • Każdy router przetwarza tę samą bazę LSDB, ale tworzy ZUPEŁNIE INNE drzewo SPF.
  • Przyczyna: każdy router jest korzeniem z własnej, unikalnej perspektywy przestrzennej.
  • Wynik obliczeń: najlepsze wyliczone ścieżki z drzewa SPF są instalowane w tablicy routingu RIB/FIB z odpowiednim adresem next-hop i interfejsem wyjściowym.
  • Całkowity brak podatności na błędy logiczne sąsiada: router sam weryfikuje matematyczną poprawność ścieżki.
Intermediate System to Intermediate System (IS-IS) to standardowy protokół stanu łącza działający bezpośrednio w warstwie 2 (ISO/IEC 10589), powszechnie wdrażany w sieciach szkieletowych operatorów telekomunikacyjnych i centrach danych.
Ilustracja techniczna do slajdu 46: Niezależne obliczenia drzewa SPF przez każdy węzeł

Kluczową zaletą algorytmu Dijkstry jest jego całkowita odporność na pętle routingu. Ponieważ każdy router dysponuje pełnym obrazem topologii i samodzielnie oblicza bezpętlowe drzewo rozpinające w warstwie 3, zjawisko zliczania do nieskończoności (Count to Infinity) w Link-State po prostu nie istnieje.

Co więcej, wyliczenie drzewa SPF dla sieci kampusowej liczącej kilkadziesiąt węzłów zajmuje współczesnym procesorom sieciowym zaledwie kilka milisekund.

Niezależność obliczeń oznacza, że każdy router patrzy na sieć ze swojej własnej, unikalnej perspektywy geometrycznej. Choć baza wejściowa LSDB jest dla wszystkich wspólna, wynikowe drzewo SPF każdego urządzenia ma inny korzeń i inną topologię gałęzi. Taki model całkowicie eliminuje konieczność uzgadniania decyzji pomiędzy sąsiadami, co było głównym źródłem podatności protokołów wektora odległości. Każde urządzenie samodzielnie wyznacza swój fizyczny port wyjściowy dla danego prefiksu, eliminując błędy interpretacji tras.

Skróty użyte w tym slajdzie:
SPF Tree (Shortest Path First Tree) - Drzewo najkrótszych połączeń wygenerowane przez algorytm Dijkstry wolne od jakichkolwiek pętli.

47/52

Natychmiastowa zbieżność i odporność na pętle w stanie łącza

Przewaga inżynierska technologii Link-State.

Wykład 7: Natychmiastowa zbieżność i odporność na pętle w stanie łącza

  • Reakcja na awarię: w momencie przerwania kabla sąsiad generuje LSA, który w ułamku sekundy zalewa całą sieć.
  • Uruchomienie algorytmu SPF: routery w ciągu kilku milisekund przeliczają alternatywną gałąź drzewa i aktualizują tablice routingu.
  • Całkowity czas zbieżności w dobrze zaprojektowanym kampusie wynosi od 50 do 200 ms.
  • Odporność na pętle: dzięki pełnej wiedzy o topologii algorytm Dijkstry z definicji tworzy drzewo acykliczne; zjawisko Count to Infinity w protokołach stanu łącza NIE WYSTĘPUJE.
Podstawowymi zaletami protokołów stanu łącza są brak ograniczeń na liczbę przeskoków, bezwzględna odporność na pętle trasowania, błyskawiczna reakcja na zmiany topologii oraz precyzyjne odzwierciedlenie przepustowości łączy w metryce.
Ilustracja techniczna do slajdu 47: Natychmiastowa zbieżność i odporność na pętle w stanie łącza

Protokoły stanu łącza osiągają czas zbieżności (Convergence Time) na poziomie subsekundowym (poniżej 1 sekundy). W połączeniu z mechanizmem BFD (RFC 5880) przełączenie ruchu na łącze zapasowe po awarii światłowodu zachodzi w czasie poniżej 50 ms bez zauważalnej przerwy w transmisji.

Dodatkową zaletą jest wysoka efektywność wykorzystania pasma: po początkowej synchronizacji bazy LSDB pakiety LSA są przesyłane wyłącznie w przypadku rzeczywistej zmiany topologii (Triggered Updates).

W celu optymalizacji obciążenia procesora protokoły stanu łącza stosują zaawansowane mechanizmy tłumienia drgań topologii (SPF Throttling). Zamiast uruchamiać algorytm Dijkstry natychmiast po każdym pojedynczym pakiecie LSA, router odczekuje dynamicznie regulowany czas (SPF Delay/Holdtime). W przypadku serii szybkich awarii na niestabilnym łączu światłowodowym (tzw. Link Flapping) odstępy pomiędzy kolejnymi przeliczeniami SPF są wykładniczo wydłużane, co chroni procesor przełącznika przed przeciążeniem i zapewnia ciągłość transferu danych.

Skróty użyte w tym slajdzie:
Sub-second (Sub-second Convergence) - Zdolność protokołu sieciowego do wykrycia awarii i przełączenia ścieżek w czasie ułamka sekundy.

48/52

Zestawienie tabelaryczne: Distance Vector vs Link-State

Sformalizowane porównanie parametrów obu rodzin protokołów.

Wykład 7: Zestawienie tabelaryczne: Distance Vector vs Link-State

  • Kryterium znajomości topologii: DV (tylko sąsiedzi, routing z plotek) vs LS (pełna mapa całej domeny w LSDB).
  • Kryterium czasu zbieżności: DV (powolna, rzędu minut) vs LS (błyskawiczna, ułamki sekund).
  • Kryterium obciążenia łączy: DV (ciągłe, okresowe rozgłaszanie tablic) vs LS (aktualizacje wysyłane tylko w razie zmiany - Event-Triggered).
  • Kryterium zapotrzebowania na pamięć i CPU: DV (minimalne) vs LS (wyższe, zależne od wielkości bazy LSDB).
  • Kryterium odporności na pętle: DV (wymaga sztucznych mechanizmów) vs LS (wrodzona odporność algorytmu SPF).
Wyzwania eksploatacyjne protokołów stanu łącza obejmują zwiększone zapotrzebowanie na pamięć RAM dla baz LSDB, obciążenie procesora przeliczeniami algorytmu SPF oraz konieczność rygorystycznego zaprojektowania hierarchii obszarów.
Ilustracja techniczna do slajdu 48: Zestawienie tabelaryczne: Distance Vector vs Link-State

Zestawienie porównawcze jednoznacznie wykazuje przewagę technologii Link-State nad Distance Vector: zbieżność w milisekundach zamiast minut, brak pętli z definicji matematycznej algorytmu Dijkstry, pełna widoczność grafu sieci oraz znikomy narzut transmisyjny.

Jedynymi kosztami protokołów stanu łącza są większe zużycie pamięci RAM na utrzymanie bazy LSDB oraz konieczność przeliczania algorytmu SPF przez procesor, co przy nowoczesnych platformach sprzętowych nie stanowi żadnej bariery.

W kontekście zużycia zasobów sprzętowych należy pamiętać, że rozmiar tablicy RIB i sprzętowej bazy FIB na obu typach routerów jest porównywalny, ponieważ zależy od liczby prefiksów docelowych w kampusie. Różnica tkwi w strukturach pomocniczych: protokół Link-State wymaga dodatkowej pamięci RAM na przechowywanie pełnej bazy LSDB, zawierającej deskryptory wszystkich łączy i węzłów. Biorąc pod uwagę, że współczesne przełączniki dystrybucyjne wyposażone są w moduły pamięci RAM DDR4/DDR5 o pojemności wielu gigabajtów, narzut ten stanowi zaledwie ułamek procenta dostępnych zasobów.

Skróty użyte w tym slajdzie:
EIGRP (Enhanced Interior Gateway Routing Protocol) - Zaawansowany protokół routingu wektora odległości firmy Cisco oparty na algorytmie DUAL (RFC 7868).

49/52

Kryteria doboru protokołu routingu dla sieci klasy kampus

Wskazówki projektowe dla inżyniera sieciowego.

Wykład 7: Kryteria doboru protokołu routingu dla sieci klasy kampus

  • Sieć kampusowa charakteryzuje się rozległą strukturą, wieloma łączami nadmiarowymi i obecnością usług krytycznych (VoIP, monitoring wideo).
  • Wymóg bezwzględny: protokół musi być otwarty (multi-vendor), bezklasowy, wspierać IPv4 oraz IPv6 i zapewniać subsekundową zbieżność.
  • Protokół OSPF (Open Shortest Path First) jest de facto standardem inżynierskim spełniającym wszystkie wymagania współczesnych sieci kampusowych.
  • Możliwość podziału na obszary (Hierarchical Multi-Area) w celu skalowania do tysięcy podsieci.
Zestawienie Distance Vector vs Link-State wykazuje bezwzględną dominację protokołów stanu łącza w nowoczesnych sieciach kampusowych pod względem zbieżności, skalowalności i odporności na awarie.
Ilustracja techniczna do slajdu 49: Kryteria doboru protokołu routingu dla sieci klasy kampus

Kryteria doboru protokołu routingu dla sieci klasy kampus wskazują protokoły stanu łącza jako jedyny racjonalny wybór inżynierski. Bezwzględnym standardem branżowym w kampusach akademickich i korporacyjnych jest protokół OSPF (Open Shortest Path First).

Protokół OSPF jest otwartym standardem wieloproducentowym (IETF RFC 2328 / RFC 5340), co pozwala na bezproblemową integrację przełączników rdzeniowych i dystrybucyjnych pochodzących od różnych dostawców sprzętu.

W specyficznych wdrożeniach przemysłowych lub dostawczych spotyka się niekiedy protokół IS-IS, jednak w środowiskach kampusowych to OSPF jest bezdyskusyjnym liderem ze względu na powszechną znajomość jego architektury wśród kadry inżynierskiej, dojrzałe narzędzia diagnostyczne oraz natywne wsparcie w systemach zarządzania siecią (NMS). Zastosowanie OSPF ułatwia również automatyzację sieci kampusowej za pomocą platform programowalnych (SDN), które bezpośrednio integrują się z procesami stanu łącza.

Skróty użyte w tym slajdzie:
ECMP (Equal-Cost Multi-Path) - Zdolność routera do równoległego przesyłania pakietów przez wiele ścieżek o identycznym koszcie metryki.

50/52

Wymogi sprzętowe i przygotowanie infrastruktury pod routing dynamiczny

Kroki wdrożeniowe na przełącznikach warstwy dystrybucji i rdzenia.

Wykład 7: Wymogi sprzętowe i przygotowanie infrastruktury pod routing dynamiczny

  • Weryfikacja licencji: upewnienie się, że przełączniki dystrybucyjne mają oprogramowanie wspierające routing dynamiczny (np. pakiet IP Base / Network Advantage).
  • Konfiguracja łączy trasowanych (Routed Ports L3) lub dedykowanych VLAN-ów tranzytowych (/31) między przełącznikami.
  • Ujednolicenie wielkości jednostki transmisji MTU (standard 1500 bajtów lub spójne ramki Jumbo na wszystkich interfejsach).
  • Przygotowanie spójnego planu identyfikatorów Router ID i podziału na obszary OSPF.
Kryteria doboru protokołu trasowania dla kampusu uwzględniają wielkość organizacji, stopień redundancji łączy fizycznych, kompetencje zespołu inżynierskiego oraz konieczność integracji z protokołem BFD (RFC 5880).
Ilustracja techniczna do slajdu 50: Wymogi sprzętowe i przygotowanie infrastruktury pod routing dynamiczny

Wdrożenie routingu dynamicznego w kampusie wymaga odpowiedniego przygotowania infrastruktury fizycznej i logicznej: wydzielenia dedykowanych łączy Point-to-Point z maskami /31 na portach trasowanych (Routed Ports, polecenie no switchport), eliminacji STP ze szkieletu oraz aktywacji protokołu BFD.

Niezbędne jest również zaplanowanie hierarchicznego podziału na obszary (Hierarchical Areas) oraz wdrożenie mechanizmów uwierzytelniania kryptograficznego (HMAC-SHA256) na łączach tranzytowych w celu ochrony przed wstrzyknięciem fałszywych pakietów LSA.

Przygotowanie fizyczne polega na zestawieniu bezpośrednich połączeń światłowodowych pomiędzy szafami dystrybucyjnymi a węzłem centralnym z pominięciem jakichkolwiek pośrednich mostów warstwy 2. Skonfigurowanie portów w trybie no switchport wyłącza obsługę funkcji przełączania ramek Ethernet i protokołu Spanning Tree na poziomie portu, przekształcając łącze w czysty interfejs IP. Dodatkowo wdrożenie masek /31 zgodnie ze standardem RFC 3021 pozwala zaoszczędzić cenną przestrzeń adresową IPv4 na łączach dwupunktowych, eliminując straty na adres sieci i broadcast.

Skróty użyte w tym slajdzie:
RAM/TCAM (Routing Memory Architecture) - Pamięć operacyjna oraz asocjacyjna przechowująca tablice RIB, FIB oraz struktury baz danych LSDB.

51/52

Podsumowanie najważniejszych zagadnień wykładu

Kluczowe filary routingu w sieciach kampusowych.

Wykład 7: Podsumowanie najważniejszych zagadnień wykładu

  • Routing w warstwie 3 łączy odizolowane domeny VLAN i umożliwia sterowanie przepływem ruchu w kampusie.
  • Tablica routingu podejmuje decyzje na podstawie reguły najdłuższego dopasowania prefiksu (LPM), dystansu administracyjnego (AD) oraz metryki.
  • Routing statyczny zapewnia determinizm i brak narzutu, a zaawansowane mechanizmy (trasy pływające, IP SLA) uodparniają go na awarie na styku z Internetem.
  • Wewnątrz kampusu standardem jest routing dynamiczny, automatycznie adaptujący się do zmian topologii.
  • Systemy autonomiczne (AS) dzielą sieć na domeny zarządzania, w których stosuje się protokoły wewnętrzne IGP lub zewnętrzny BGP.
  • Protokoły stanu łącza (Link-State) deklasują protokoły wektora odległości pod względem szybkości zbieżności i braku pętli, opierając się na algorytmie Dijkstry.
  • Fundamentem routingu w nowoczesnym kampusie jest otwarty standard OSPF.
Podsumowanie wykładu systematyzuje regułę LPM jako nadrzędne kryterium wyboru trasy, rolę tras statycznych z mechanizmem IP SLA w redundancji brzegowej oraz bezwzględne zalety protokołów stanu łącza w szkielecie kampusu.
Ilustracja techniczna do slajdu 51: Podsumowanie najważniejszych zagadnień wykładu

Podsumowując wykład 7: routing w warstwie 3 stanowi fundament stabilności i skalowalności kampusu. Zrozumienie nadrzędności reguły Longest Prefix Match, anatomii tablicy RIB oraz mechanizmów wyznaczania ścieżek decyduje o sprawnym zarządzaniu ruchem.

Świadomy inżynier stosuje routing statyczny z sondami IP SLA i BFD wyłącznie na łączach brzegowych, opierając cały szkielet kampusowy na dynamicznych, bezpętlowych protokołach stanu łącza o subsekundowej zbieżności.

Wiedza zdobyta w ramach tego modułu stanowi punkt wyjścia do zaawansowanego projektowania sieci definiowanych programowo (SD-Access) oraz segmentacji z użyciem protokołu EVPN-VXLAN. Nowoczesne technologie wirtualizacji szkieletu kampusowego traktują routing warstwy 3 jako tzw. sieć bazową (Underlay), na której nakładane są programowalne tunele sieci wirtualnych. Stabilność, determinizm i wysoka dostępność warstwy fizycznej routingu decydują o bezawaryjnej pracy wszystkich warstw nadrzędnych kampusu.

Skróty użyte w tym slajdzie:
Campus Routing Summary (Campus Routing Design Summary) - Zbiór kluczowych zasad projektowania warstwy 3 w kampusie integrujący trasy statyczne z OSPF.

52/52

Zapowiedź kolejnego wykładu: kompleksowy protokół routingu OSPF

Przejście do szczegółowej inżynierii protokołu OSPF.

Wykład 7: Zapowiedź kolejnego wykładu: kompleksowy protokół routingu OSPF

  • Temat kolejnego spotkania: dynamiczny protokół routingu OSPF w sieci kampusowej (kompleksowy wykład łączący architekturę jedno- i wieloobszarową).
  • Kluczowe zagadnienia: sąsiedztwo OSPF, stany od Down do Full, wybór DR/BDR, metryka kosztu (reference-bandwidth), konfiguracja praktyczna.
  • Zaawansowana inżynieria: hierarchia Multi-Area OSPF, rola Area 0, typy pakietów LSA (1 do 5), agregacja tras na ABR/ASBR, obszary Stub/NSSA, interfejsy pasywne i OSPFv3 dla IPv6.
  • Zadanie do przemyślenia: dlaczego w sieci z łączami 10 Gb/s i 40 Gb/s domyślna metryka OSPF traktuje je jako równie szybkie jak stary kabel 100 Mb/s.
Kolejny moduł dydaktyczny (Wykład 8) przedstawi zaawansowaną architekturę, mechanizmy stanów sąsiedztwa i optymalizację metryk protokołu Open Shortest Path First (OSPFv2 i OSPFv3) w sieci kampusowej.
Ilustracja techniczna do slajdu 52: Zapowiedź kolejnego wykładu: kompleksowy protokół routingu OSPF

Wykład poświęcony podstawom routingu stanowi teoretyczny i pojęciowy wstęp do zaawansowanej inżynierii warstwy sieciowej. Kolejny moduł dydaktyczny w całości poświęcony będzie najpopularniejszemu protokołowi stanu łącza na świecie.

Wykład 8 szczegółowo przedstawi architekturę protokołu OSPF: budowę pakietów (Hello, DBD, LSR, LSU, LSAck), mechanizm wyboru routerów DR/BDR, typy obszarów (Standard, Stub, Totally Stub, NSSA) oraz zaawansowaną kalkulację metryki i agregację tras w kampusie.

Zgłębienie mechaniki OSPF pozwoli studentom zrozumieć, w jaki sposób rozległe sieci uniwersyteckie dzielone są na strefy autonomiczne w celu ograniczenia propagacji anonsów LSA i zmniejszenia rozmiaru tablic routingu na urządzeniach brzegowych. Kolejny wykład przedstawi również zaawansowane techniki optymalizacji, w tym obszary szczątkowe (Stub i Totally Stubby) oraz warianty NSSA umożliwiające bezpieczną integrację zewnętrznych systemów bezpieczeństwa.

Skróty użyte w tym slajdzie:
OSPF (Open Shortest Path First) - Otwarty, standardowy protokół routingu stanu łącza (RFC 2328) dedykowany do sieci korporacyjnych i kampusowych.

Podgląd okładki książki