Wykład 4: Projektowanie wysokiej dostępności i nadmiarowości w sieci kampusowej

1/54

Projektowanie wysokiej dostępności i nadmiarowości w sieci kampusowej

Slajd tytułowy definiujący zakres wykładu poświęconego niezawodności i ciągłości działania.

Wykład 4: Projektowanie wysokiej dostępności i nadmiarowości w sieci kampusowej

  • Tytuł wykładu i kontekst inżynierski: budowa odpornej na awarie infrastruktury sieciowej klasy kampus.
  • Zakres zagadnień: od miar niezawodności i eliminacji SPOF, przez protokoły drzewa rozpinającego i agregację multichassis, po protokoły FHRP i redundancję zasilania.
  • Praktyczny wymiar: zapewnienie ciągłości działania instytucji akademickiej w warunkach fizycznych uszkodzeń sprzętu i traktów kablowych.
  • Miejsce w programie: fundament stabilności wszystkich warstw sieci kampusowej.
Wysoka dostępność (High Availability, HA) to właściwość systemu teleinformatycznego gwarantująca ciągłość świadczenia usług sieciowych na zdefiniowanym poziomie jakości pomimo wystąpienia awarii pojedynczych komponentów sprzętowych lub programowych. Osiąga się ją poprzez celowe dublowanie zasobów oraz automatyzację procesów przełączania awaryjnego.
Ilustracja techniczna do slajdu 1: Projektowanie wysokiej dostępności i nadmiarowości w sieci kampusowej

Projektowanie wysokiej dostępności (High Availability - HA) w sieci kampusowej to kompleksowa dyscyplina inżynierska obejmująca wszystkie warstwy infrastruktury: od zasilania energetycznego i tras kablowych, przez protokoły przełączania warstwy 2, aż po routing i usługi aplikacyjne.

Niezawodność nie może być traktowana jako pojedyncza funkcja sprzętowa, lecz jako spójna strategia eliminacji pojedynczych punktów awarii (SPOF). Współczesne kampusy uniwersyteckie i korporacyjne wymagają ciągłości działania w trybie 24/7/365, co wymusza stosowanie deterministycznych czasów konwergencji mierzonych w milisekundach.

W analizie niezawodnościowej sieci kampusowej kluczowe znaczenie ma zrozumienie, że wysoka dostępność nie jest cechą pojedynczego urządzenia, lecz wypadkową odporności wszystkich współpracujących elementów systemu. Każda awaria przełącznika rdzeniowego, przecięcie traktu światłowodowego czy zanik zasilania w punkcie dystrybucyjnym wywołuje stan przejściowy, podczas którego protokoły sieciowe muszą wykryć uszkodzenie, zrekonfigurować tablice przekazywania i przywrócić transfer pakietów bez zakłócania pracy systemów uczelnianych.

Skróty użyte w tym slajdzie:
HA - High Availability, Architektura wysokiej dostępności gwarantująca ciągłość działania sieci przy awariach komponentów.
SPOF - Single Point of Failure, Pojedynczy punkt awarii, którego eliminacja stanowi cel inżynierii redundancji.
MTBF - Mean Time Between Failures, Średni czas bezawaryjnej pracy urządzeń sieciowych.
MTTR - Mean Time To Repair, Średni czas niezbędny do usunięcia awarii i przywrócenia sprawności systemu.
CAN - Campus Area Network, Sieć kampusowa wymagająca podwyższonych rygorów niezawodnościowych.

2/54

Cel i agenda wykładu

Przedstawienie harmonogramu wykładu i kluczowych zagadnień.

Wykład 4: Cel i agenda wykładu

  • Część 1: pojęcie wysokiej dostępności (HA), wskaźniki MTBF/MTTR i dziewiątki dostępności.
  • Część 2: identyfikacja i eliminacja pojedynczych punktów awarii (SPOF) w sieci.
  • Część 3: pętle w warstwie 2 i protokoły Spanning Tree (klasyczny STP, RSTP 802.1w, MSTP 802.1s).
  • Część 4: zaawansowane mechanizmy ochrony drzewa rozpinającego (BPDU Guard, Root Guard, Loop Guard).
  • Część 5: agregacja łączy LACP (IEEE 802.1AX) oraz technologie Multi-Chassis (Stacking, VSS, vPC, MLAG).
  • Część 6: protokoły redundancji pierwszej bramy (FHRP: HSRP, VRRPv3 RFC 5798, GLBP).
  • Część 7: nadmiarowość okablowania, dublowanie tras światłowodowych i topologie fizyczne.
  • Część 8: redundancja serwerów i usług (klastry HA, Load Balancing, NIC bonding).
  • Część 9: redundancja systemów zasilania (UPS, agregaty prądotwórcze z SZR, zasilanie AC i DC -48V).
  • Część 10: podsumowanie wykładu i wnioski inżynierskie.
Plan wykładu wyznacza logiczną ścieżkę analizy niezawodnościowej: od matematycznych wskaźników dostępności, poprzez fizyczne mechanizmy redundancji, aż po protokoły dynamicznego zarządzania topologią sieci. Pozwala studentom zrozumieć współzależności pomiędzy poszczególnymi mechanizmami warstwy 2 i 3.
Ilustracja techniczna do slajdu 2: Cel i agenda wykładu

Agenda wykładu odzwierciedla logiczną ścieżkę inżynierską: od matematycznych definicji i wskaźników niezawodnościowych, przez analizę przyczyn powstawania pętli w warstwie 2, ewolucję drzewa rozpinającego (STP/RSTP/MSTP) i agregację LACP, po protokoły pierwszej bramy (FHRP) oraz infrastrukturę zasilania gwarantowanego.

Szczególny nacisk położono na współczesne wzorce architektoniczne, w których tradycyjne blokowanie portów przez protokół STP zastępuje się wielościeżkowym ruchem LACP i routingiem w warstwie dystrybucji, co pozwala na pełne wykorzystanie zakupionego pasma transmisyjnego.

W ramach niniejszego wykładu studenci poznają ewolucję mechanizmów zabezpieczania warstwy łącza danych: od klasycznych algorytmów blokowania portów, przez zaawansowaną wirtualizację urządzeń sieciowych w postaci klastrów wielourządzeniowych, aż po wielopoziomową redundancję traktów kablowych i systemów zasilania gwarantowanego. Pozwala to ukształtować całościowe spojrzenie inżynierskie na problem projektowania odpornej infrastruktury teleinformatycznej.

Skróty użyte w tym slajdzie:
STP - Spanning Tree Protocol, Protokół drzewa rozpinającego zapobiegający pętlom w warstwie 2.
LACP - Link Aggregation Control Protocol, Standard łączenia traktów fizycznych w magistrale zagregowane.
FHRP - First Hop Redundancy Protocol, Rodzina protokołów redundancji bramy domyślnej dla stacji roboczych.
UPS - Uninterruptible Power Supply, System zasilania bezprzerwowego podtrzymujący węzły sieci.
SZR - Samoczynne Załączanie Rezerwy, Automatyka przełączania zasilania sieciowego na agregat prądotwórczy.

3/54

Normy techniczne i dokumenty odniesienia

Wskazanie międzynarodowych dokumentów normalizacyjnych dotyczących niezawodności.

Wykład 4: Normy techniczne i dokumenty odniesienia

  • Norma agregacji połączeń: IEEE 802.1AX-2020, Link Aggregation (dawniej IEEE 802.3ad).
  • Norma protokołów drzewa rozpinającego i mostkowania: IEEE 802.1Q-2022 (integrująca RSTP 802.1w i MSTP 802.1s).
  • Standard redundancji bramy: IETF RFC 5798, Virtual Router Redundancy Protocol (VRRP) Version 3 for IPv4 and IPv6.
  • Dyrektywa o ciągłości działania i cyberbezpieczeństwie: Dyrektywa NIS 2 (UE 2022/2555).
  • Normy instalacji zasilania awaryjnego i centrów przetwarzania danych: PN-EN 50600-2-2 (Infrastruktura i urządzenia centrów przetwarzania danych - Dystrybucja energii).
Zapewnienie wysokiej dostępności wymaga przestrzegania zharmonizowanych norm międzynarodowych IEEE (802.1D, 802.1w, 802.1Q, 802.1AX), specyfikacji IETF RFC 5798, RFC 5880 oraz europejskiej normy PN-EN 50600-2-2 dla infrastruktury zasilania centrów danych.
Ilustracja techniczna do slajdu 3: Normy techniczne i dokumenty odniesienia

Projektowanie niezawodnej infrastruktury sieciowej musi opierać się na zharmonizowanych normach europejskich i międzynarodowych standardach inżynierskich. W obszarze infrastruktury serwerowni i zasilania kluczowym dokumentem odniesienia jest norma europejska PN-EN 50600, definiująca klasy dostępności i odporności na awarie.

W warstwach logicznych fundament stanowią standardy IEEE 802.1w (RSTP), IEEE 802.1s (MSTP), IEEE 802.1AX (agregacja łączy) oraz specyfikacje IETF, takie jak RFC 5798 dla protokołu VRRPv3 i RFC 5880 dla protokołu szybkiej detekcji BFD.

Standardy normalizacyjne definiują nie tylko parametry elektryczne i protokołowe, lecz także procedury certyfikacji i testowania odporności infrastruktury. Zastosowanie wytycznych zawartych w normach PN-EN 50173-1 oraz EN 50600 pozwala na zachowanie spójności między projektem budowlanym serwerowni a konfiguracją urządzeń aktywnych, gwarantując, że nadmiarowe łącza światłowodowe nie zostaną poprowadzone przez wspólne, podatne na awarie trasy kablowe.

Skróty użyte w tym slajdzie:
PKN - Polski Komitet Normalizacyjny, Krajowa jednostka normalizacyjna zatwierdzająca normy serii PN-EN 50600.
IEEE - Institute of Electrical and Electronics Engineers, Instytut standaryzujący m.in. protokoły 802.1D, 802.1w oraz 802.1AX.
IETF - Internet Engineering Task Force, Międzynarodowa organizacja definiująca protokoły VRRP i BFD w dokumentach RFC.
KSC - Krajowy System Cyberbezpieczeństwa, System regulowany ustawą nakładającą obowiązki zapewnienia ciągłości działania na podmioty kluczowe.

4/54

Definicja i miary wysokiej dostępności (High Availability - HA)

Podstawy teoretyczne inżynierii niezawodności systemów teleinformatycznych.

Wykład 4: Definicja i miary wysokiej dostępności (High Availability - HA)

  • Pojęcie High Availability: zdolność systemu sieciowego do ciągłego, nieprzerwanego świadczenia usług na założonym poziomie jakości pomimo wystąpienia awarii komponentów.
  • Wzór na dostępność (Availability): A = Uptime / (Uptime + Downtime) * 100%.
  • Projektowanie proaktywne: zakładamy, że każdy element sieci (kabel, port, zasilacz, wentylator, układ scalony) ulegnie awarii w określonym czasie.
  • Cel inżyniera: zaprojektowanie sieci tak, aby awaria pojedynczego elementu pozostawała niewidoczna dla użytkowników.
Odporność na awarie (Fault Tolerance) to zdolność systemu sieciowego do bezprzerwowej pracy pomimo wystąpienia uszkodzenia jednego z komponentów. W odróżnieniu od zwykłego odzyskiwania po awarii, tolerancja na uszkodzenia nie dopuszcza do zerwania aktywnych sesji transmisyjnych użytkowników.
Ilustracja techniczna do slajdu 4: Definicja i miary wysokiej dostępności (High Availability - HA)

Wysoka dostępność definiowana jest jako zdolność systemu teleinformatycznego do utrzymania ciągłości świadczenia usług na założonym poziomie parametrów SLA mimo awarii pojedynczych komponentów sprzętowych lub programowych.

W inżynierii sieciowej dostępność wyrażana jest współczynnikiem gotowości A = MTBF / (MTBF + MTTR). Wzrost dostępności wymaga nie tylko dublowania urządzeń, lecz przede wszystkim automatyzacji procesu wykrywania uszkodzeń i natychmiastowego przełączania ruchu na tory zapasowe.

Matematyczny model dostępności wymusza na projektancie precyzyjne bilansowanie kosztów inwestycyjnych w relacji do akceptowalnego czasu przestoju. Podniesienie dostępności o jeden rząd wielkości (np. z 99,9% do 99,99%) wymaga nie tylko dublowania kluczowych przełączników, lecz także wdrożenia automatycznych protokołów detekcji uszkodzeń o czasach reakcji rzędu dziesiątek milisekund (np. BFD), co wiąże się ze znacznym wzrostem złożoności operacyjnej systemu.

Skróty użyte w tym slajdzie:
HA - High Availability, Cecha systemu teleinformatycznego oznaczająca zdolność do nieprzerwanej pracy pomimo uszkodzeń sprzętu.
SLA - Service Level Agreement, Umowa gwarantująca procentowy poziom dostępności usług telekomunikacyjnych.
Downtime - Czas przestoju, Całkowity czas niedostępności systemu w skali miesiąca lub roku.

5/54

Wskaźniki niezawodnościowe: MTBF, MTTR, RTO oraz RPO

Kluczowe wskaźniki parametryzujące niezawodność infrastruktury.

Wykład 4: Wskaźniki niezawodnościowe: MTBF, MTTR, RTO oraz RPO

  • MTBF (Mean Time Between Failures): średni czas bezawaryjnej pracy urządzenia deklarowany przez producenta w godzinach (np. 300 000 godzin).
  • MTTR (Mean Time To Repair / Recovery): średni czas potrzebny na zdiagnozowanie, wymianę uszkodzonego modułu i przywrócenie pełnej funkcjonalności.
  • RTO (Recovery Time Objective): maksymalny dopuszczalny czas przestoju usługi określony w polityce ciągłości działania organizacji.
  • RPO (Recovery Point Objective): maksymalny akceptowalny okres, z którego dane mogą zostać utracone na skutek awarii.
  • Zależność inżynierska: zwiększanie MTBF (lepszy sprzęt) oraz minimalizacja MTTR (redundancja automatyczna).
Wskaźniki niezawodnościowe (MTBF, MTTR) stanowią ilościową podstawę inżynierii HA; MTBF określa statystyczny czas poprawnej pracy sprzętu, MTTR czas przywrócenia sprawności, a parametry RTO i RPO wyznaczają dopuszczalny czas przestoju oraz dopuszczalną utratę danych.
Ilustracja techniczna do slajdu 5: Wskaźniki niezawodnościowe: MTBF, MTTR, RTO oraz RPO

Metryki niezawodnościowe stanowią podstawę wymiarowania umów serwisowych i planów ciągłości działania (BCP). Wskaźnik MTBF (Mean Time Between Failures) określa średni czas bezawaryjnej pracy podzespołu, natomiast MTTR (Mean Time To Repair) mierzy czas niezbędny do usunięcia usterki.

Z punktu widzenia aplikacji biznesowych kluczowe są parametry RTO (Recovery Time Objective - dopuszczalny czas niedostępności usługi) oraz RPO (Recovery Point Objective - maksymalny dopuszczalny okres utraty danych). Dla krytycznych sieci kampusowych parametr RTO dąży do zera.

W inżynierii sieciowej wskaźnik MTTR jest bezpośrednio powiązany z poziomem automatyzacji i telemetrii. Zastosowanie protokołów szybkiej konwergencji pozwala zredukować czas powrotu do sprawności w warstwie logicznej do ułamków sekund, podczas gdy wymiana uszkodzonego zasilacza czy modułu wentylatorów w trybie Hot-Swap eliminuje konieczność planowania okien serwisowych i przerw w pracy jednostek dydaktycznych.

Warto zauważyć, że relacja między wskaźnikami RTO i RPO wyznacza architekturę logiczną systemów kopii zapasowych i replikacji danych. Podczas gdy RTO określa, jak długo organizacja może funkcjonować bez dostępu do sieci lub bazy danych, wskaźnik RPO definiuje dopuszczalną ilość bezpowrotnie utraconych transakcji od ostatniego punktu synchronizacji. W kampusowych bazach danych dziekanatu i systemach rozliczeniowych dąży się do RPO bliskiego zeru poprzez synchroniczną replikację macierzy dyskowych w dwóch niezależnych serwerowniach MDF.

Skróty użyte w tym slajdzie:
MTBF - Mean Time Between Failures, Wskaźnik średniego czasu pracy pomiędzy kolejnymi usterkami sprzętu.
MTTR - Mean Time To Repair, Średni czas potrzebny zespołowi technicznemu na naprawę uszkodzenia.
RTO - Recovery Time Objective, Maksymalny dopuszczalny czas przywrócenia funkcjonalności po awarii.
RPO - Recovery Point Objective, Maksymalny dopuszczalny okres utraty danych z perspektywy kopii zapasowych.

6/54

Tablica dostępności i pojęcie dziewiątek dostępności

Przeliczenie procentowego wskaźnika dostępności na realny czas przestoju w skali roku.

Wykład 4: Tablica dostępności i pojęcie dziewiątek dostępności

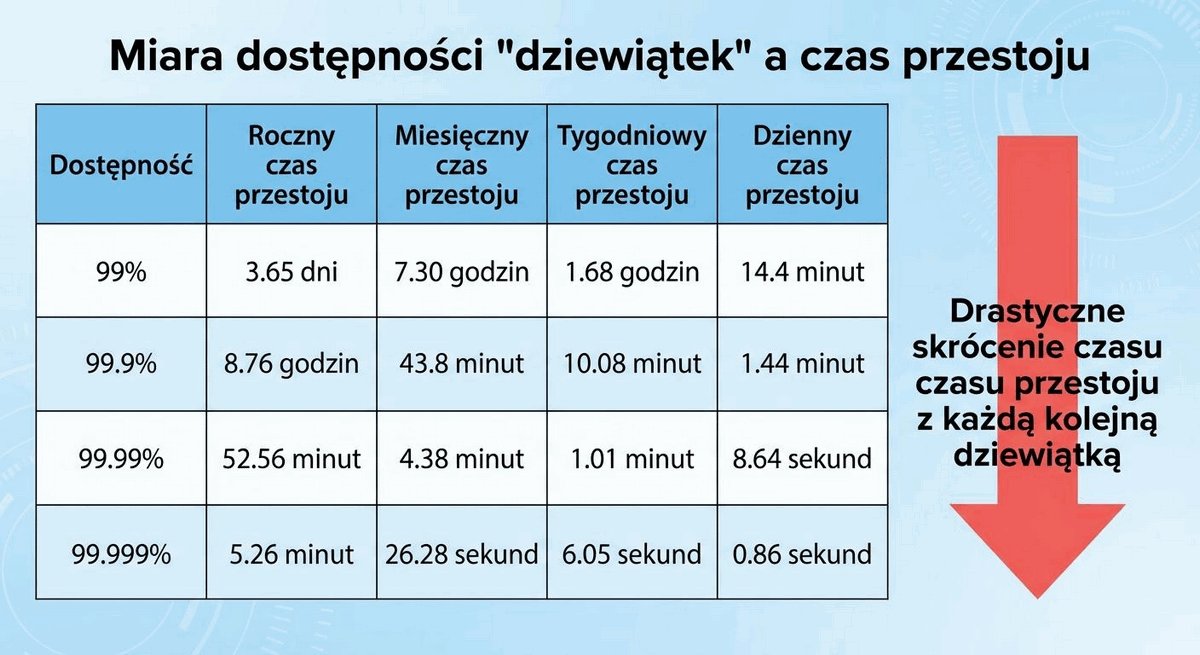
  • 99% (dwie dziewiątki): dopuszczalny przestój 3 dni 15 godzin 36 minut na rok (poziom niewystarczający dla infrastruktury krytycznej).
  • 99,9% (trzy dziewiątki): dopuszczalny przestój 8 godzin 45 minut 36 sekund na rok (typowy poziom dla małych sieci biurowych).
  • 99,99% (cztery dziewiątki): dopuszczalny przestój 52 minuty 36 sekund na rok (standard dla sieci kampusowych).
  • 99,999% (pięć dziewiątek): dopuszczalny przestój zaledwie 5 minut 15 sekund na rok (standard dla szkieletów telekomunikacyjnych i serwerowni krytycznych).
  • Koszt osiągnięcia kolejnych dziewiątek rośnie wykładniczo: przejście z 99,9% na 99,999% wymaga znacznie większych nakładów na redundancję i podniesienie niezawodności.
Współczynnik dostępności (Availability) wyrażany liczbą dziewiątek (np. 99,999% - Five Nines) definiuje dopuszczalny roczny czas niedostępności systemu teleinformatycznego (dla pięciu dziewiątek poniżej 5 minut i 15 sekund w skali roku).
Ilustracja techniczna do slajdu 6: Tablica dostępności i pojęcie dziewiątek dostępności

Pojęcie „dziewiątek dostępności” odnosi się do procentowego czasu poprawnego działania systemu w skali roku. Dostępność na poziomie 99% (dwie dziewiątki) oznacza dopuszczalny roczny przestój wynoszący aż 3,65 dnia, co jest niedopuszczalne w infrastrukturze korporacyjnej.

Poziom 99,999% (tzw. Five Nines) ogranicza łączny czas awarii do zaledwie 5 minut i 15 sekund w ciągu całego roku. Osiągnięcie takiego wskaźnika wymaga pełnej redundancji zasilania A+B, podwójnych procesorów Supervisor w przełącznikach oraz bezprzerwowej konwergencji protokołów sieciowych.

Zrozumienie skali dziewiątek dostępności jest fundamentem negocjacji umów o gwarantowanym poziomie świadczenia usług (SLA). W środowiskach akademickich, w których infrastruktura wspiera laboratoria badawcze i obliczenia dużej mocy (HPC), standardem staje się dążenie do poziomu Four Nines (99,99%), co oznacza dopuszczalny nieplanowany przestój nieprzekraczający około 52 minut w skali całego roku.

Skróty użyte w tym slajdzie:
99,9% - Trzy dziewiątki, Dopuszczalny roczny czas niedostępności wynoszący 8 godzin 45 minut i 36 sekund.
99,99% - Cztery dziewiątki, Dopuszczalny roczny czas przestoju wynoszący 52 minuty i 36 sekund.
99,999% - Pięć dziewiątek, Standard High Availability dopuszczający zaledwie 5 minut i 15 sekund przestoju w roku.

7/54

Analiza kosztów przestoju sieci

Uzasadnienie ekonomiczne nakładów na infrastrukturę nadmiarową.

Wykład 4: Analiza kosztów przestoju sieci

  • Koszty bezpośrednie: utracone przychody, koszty awaryjnej pracy serwisantów, kary umowne za naruszenie umów SLA.
  • Koszty pośrednie: paraliż pracy tysięcy pracowników i studentów, unieruchomienie laboratoriów badawczych, utrata danych z eksperymentów.
  • Koszty wizerunkowe: utrata reputacji uczelni, spadek zaufania partnerów biznesowych i grantodawców.
  • Wniosek inwestycyjny: nakłady na redundantne kable i drugie zasilacze są wielokrotnie niższe niż koszt kilkugodzinnego całkowitego paraliżu kampusu.
Koszty przestoju (Cost of Downtime) obejmują straty bezpośrednie (utracone przychody, koszty naprawy) oraz pośrednie (degradacja reputacji, kary umowne SLA), uzasadniając nakłady inwestycyjne na wielopoziomową redundancję sprzętową.
Ilustracja techniczna do slajdu 7: Analiza kosztów przestoju sieci

Koszty przestoju sieci kampusowej dzielą się na straty bezpośrednie i pośrednie. W środowisku uczelnianym awaria rdzenia w trakcie sesji egzaminacyjnej lub rekrutacji paraliżuje pracę tysięcy osób, generując ogromne straty organizacyjne i wizerunkowe.

W szpitalach klinicznych lub centrach obliczeniowych uczelni brak łączności z bazami danych czy aparaturą medyczną stwarza bezpośrednie zagrożenie zdrowia i życia. Nakłady inwestycyjne na redundancję (CAPEX) są zawsze nieporównywalnie niższe od kosztów pojedynczej poważnej awarii.

Wycena kosztów przestoju w warunkach uczelni wyższej obejmuje także ryzyko utraty reputacji oraz sankcje wynikające z niedotrzymania warunków grantów badawczych realizowanych we współpracy z przemysłem. Przerwanie wielotygodniowej symulacji numerycznej w centrum superkomputerowym na skutek awarii zasilania w punkcie MDF generuje straty finansowe wielokrotnie przewyższające koszt instalacji nadmiarowego modułu UPS.

Skróty użyte w tym slajdzie:
OPEX - Operational Expenditure, Bieżące koszty utrzymania i eksploatacji infrastruktury sieciowej.
TCO - Total Cost of Ownership, Całkowity koszt posiadania obejmujący zakup, eksploatację i straty wywołane awariami.
BCP - Business Continuity Plan, Plan ciągłości działania instytucji minimalizujący straty finansowe i wizerunkowe.

8/54

Identyfikacja pojedynczych punktów awarii (Single Point of Failure - SPOF)

Metodyka audytu podatności topologii sieciowej.

Wykład 4: Identyfikacja pojedynczych punktów awarii (Single Point of Failure - SPOF)

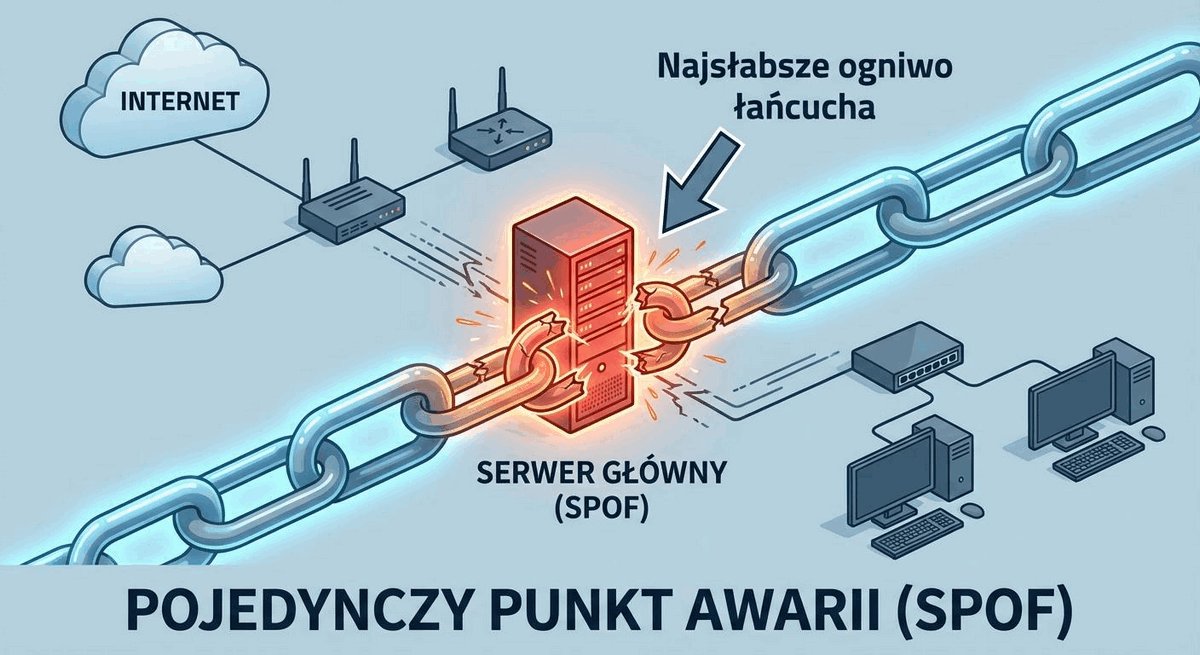
  • Definicja SPOF: element systemu, którego pojedyncze uszkodzenie doprowadza do paraliżu całego systemu lub jego znaczącej części.
  • Typowe punkty SPOF w sieci kampusowej:
  • Pojedynczy kabel światłowodowy wchodzący do budynku.
  • Pojedynczy przełącznik dystrybucyjny lub rdzeniowy.
  • Pojedyncza brama domyślna skonfigurowana na stacjach roboczych.
  • Pojedynczy serwer DHCP lub DNS.
  • Pojedyncza linia zasilająca z sieci energetycznej bez podtrzymania UPS.
  • Zasada projektowa: każda ścieżka krytyczna musi posiadać co najmniej jeden alternatywny, niezależny tor rezerwowy.
Pojedynczy punkt awarii (Single Point of Failure, SPOF) to dowolny element infrastruktury sprzętowej, logicznej lub zasilającej, którego uszkodzenie skutkuje przerwaniem świadczenia usług w całym systemie lub wyodrębnionym segmencie sieci. Eliminacja SPOF jest nadrzędnym celem inżynierii wysokiej dostępności.
Ilustracja techniczna do slajdu 8: Identyfikacja pojedynczych punktów awarii (Single Point of Failure - SPOF)

Pojedynczy punkt awarii (Single Point of Failure - SPOF) to dowolny element infrastruktury, którego jednostkowe uszkodzenie powoduje całkowitą utratę łączności dla części lub całości sieci. Identyfikacja SPOF wymaga wnikliwego audytu wszystkich warstw.

Typowe ukryte punkty awarii w kampusie to m.in.: pojedynczy zasilacz w przełączniku dystrybucyjnym, wspólny rów kablowy dla dwóch traktów światłowodowych, pojedynczy bezpiecznik w rozdzielnicy elektrycznej czy wspólny serwer DHCP obsługujący całą uczelnię.

Identyfikacja pojedynczych punktów awarii wymaga przeprowadzenia rygorystycznego audytu topologii fizycznej i logicznej. Bardzo częstym błędem jest projektowanie podwójnych przełączników dystrybucyjnych zasilanych z tego samego obwodu elektrycznego lub podłączonych do tego samego wieloparowego kabla światłowodowego, co w przypadku awarii zasilania lub uszkodzenia mechanicznego niweczy całą redundancję logiczną.

Skróty użyte w tym slajdzie:
SPOF - Single Point of Failure, Każdy element sieci (kabel, port, zasilacz, przełącznik), którego defekt unieruchamia system.
PDU - Power Distribution Unit, Listwa zasilająca, która przy braku redundancji może stanowić punkt SPOF.
Uplink - Łącze nadrzędne, Pojedynczy kabel dosyłowy stanowiący krytyczny punkt SPOF w szafach IDF.

9/54

Strategia eliminacji SPOF na każdym poziomie architektury

Podejście całościowe: od gniazdka użytkownika po zasilanie w stacji transformatorowej.

Wykład 4: Strategia eliminacji SPOF na każdym poziomie architektury

  • Warstwa fizyczna: zdublowane trasy kablowe prowadzone różnymi duktami ziemnymi.
  • Warstwa sprzętowa: redundantne przełączniki, podwójne zasilacze, wymienne moduły zarządzające (Dual Supervisor).
  • Warstwa 2 (przełączanie): protokoły Spanning Tree, agregacja łączy LACP i łączenie przełączników w stosy.
  • Warstwa 3 (routing): protokoły redundancji bramy FHRP oraz dynamiczny routing z wieloma ścieżkami (ECMP).
  • Warstwa zasilania: zasilanie z dwóch niezależnych stacji transformatorowych, podwójne tory UPS i agregat prądotwórczy z automatyką SZR.
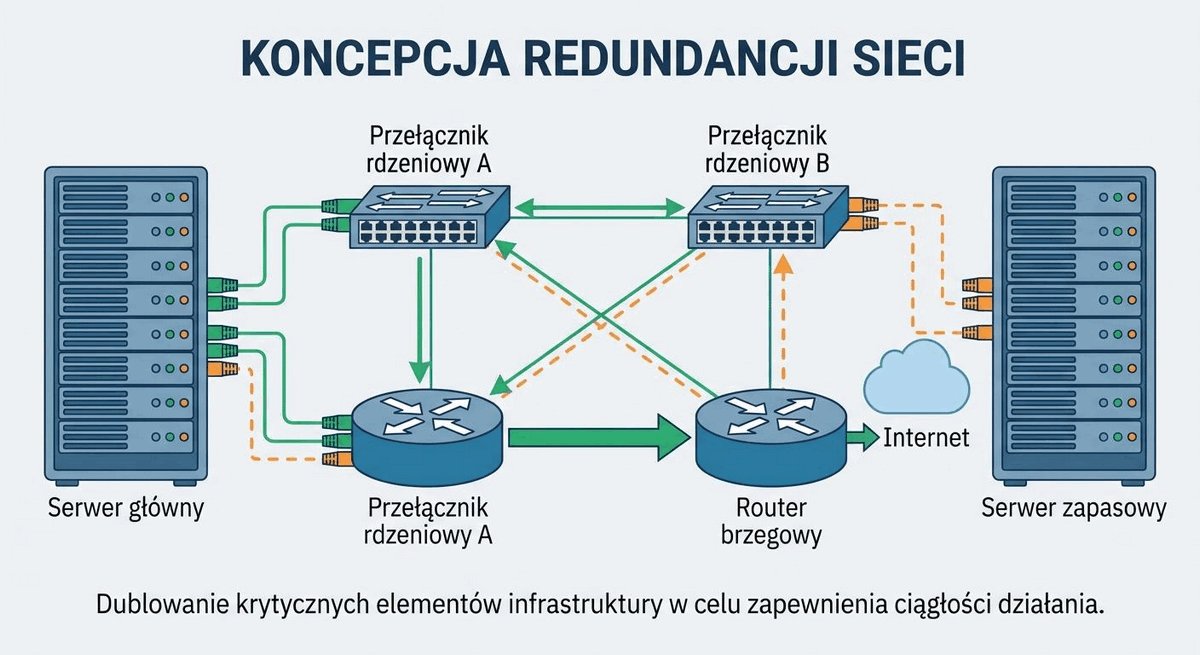
Systematyczna eliminacja SPOF wymaga wdrożenia podwójnych łączy fizycznych, redundantnych przełączników, zasilania dwutorowego (A+B) oraz protokołów automatycznego przełączania awaryjnego na każdym poziomie hierarchii sieci.
Ilustracja techniczna do slajdu 9: Strategia eliminacji SPOF na każdym poziomie architektury

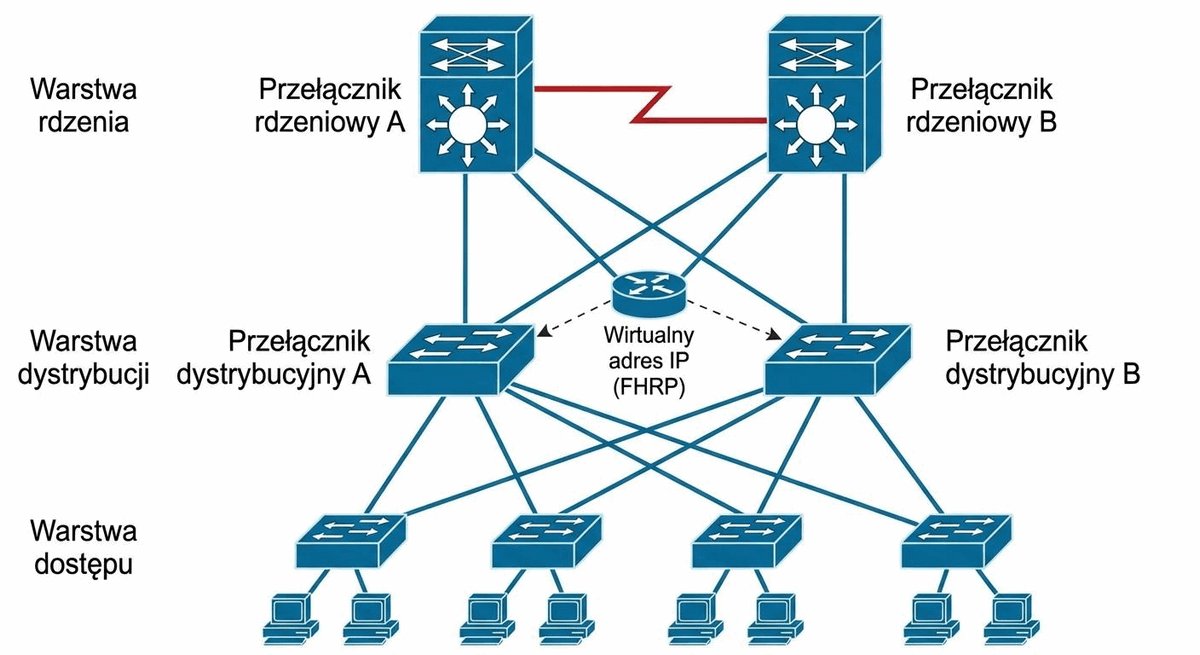
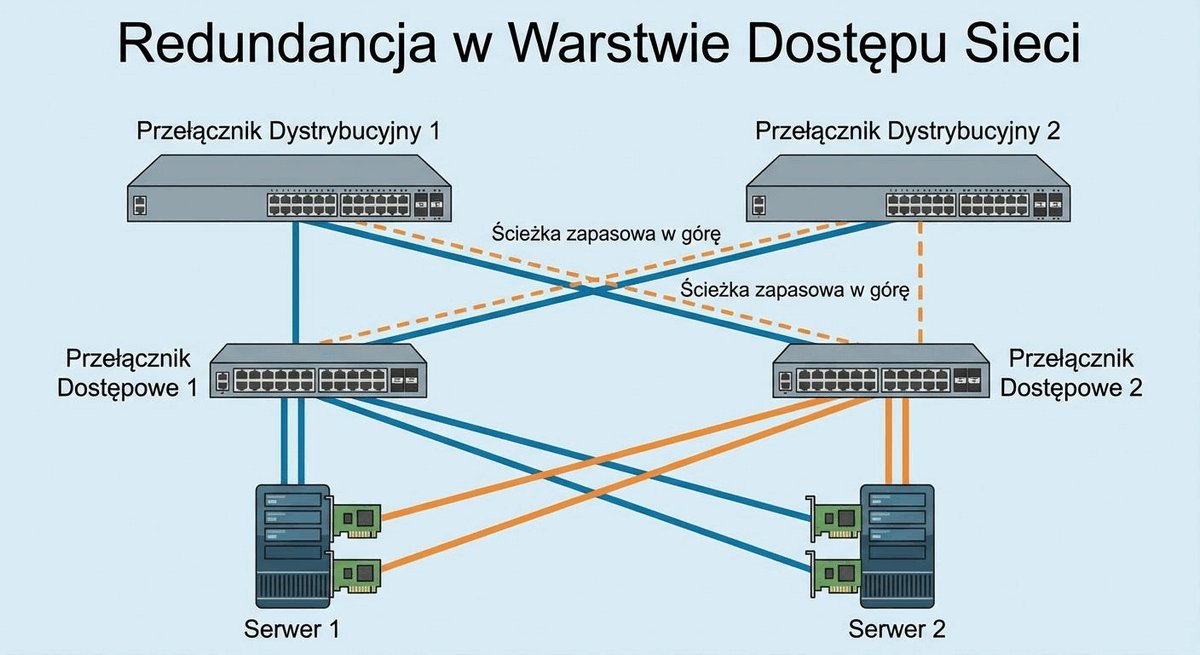
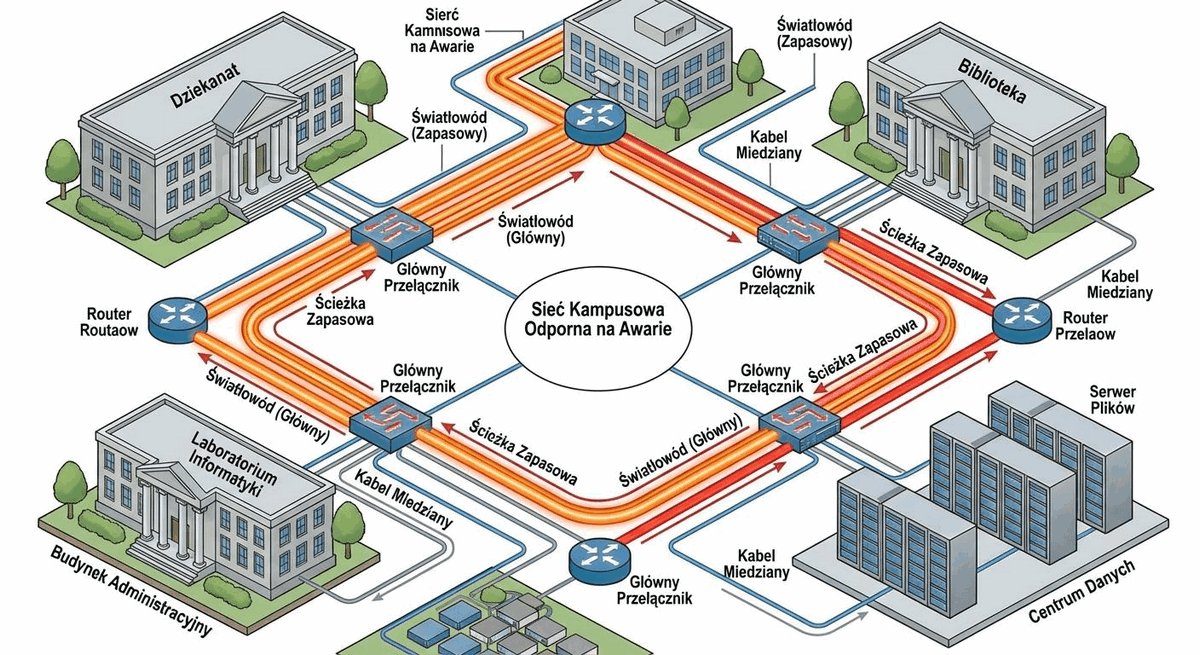
Strategia eliminacji punktów awarii polega na wdrożeniu pełnej nadmiarowości we wszystkich domenach: fizycznej, logicznej i zasilającej. Każdy przełącznik dystrybucyjny musi posiadać dwa niezależne łącza uplink do dwóch różnych przełączników rdzeniowych.

Równolegle eliminuje się SPOF na poziomie podzespołów wewnętrznych: stosuje się podwójne zasilacze hot-swap, modularne wentylatory oraz redundantne moduły sterujące (Supervisor Engines) z automatycznym przełączaniem stanowym SSO (Stateful Switchover).

Dojrzała strategia eliminacji SPOF zakłada zasadę N+1 lub 2N na każdym etapie przetwarzania danych. Oznacza to dublowanie modułów procesorów zarządzających (Supervisor Engines) w przełącznikach modułowych, wprowadzanie niezależnych szyn zasilających oraz stosowanie wielościeżkowego trasowania pakietów (ECMP) w warstwie sieciowej, co pozwala zachować pełną przepustowość sieci nawet podczas planowych prac konserwacyjnych.

Skróty użyte w tym slajdzie:
Dual-Homing - Podwójne przyłączenie, Podłączanie każdego przełącznika dostępowego dwoma niezależnymi traktami do dystrybucji.
RPS - Redundant Power Supply, Zewnętrzny zasilacz rezerwowy podłączany do urządzeń krawędziowych.
Diverse Path - Rozdzielność tras, Prowadzenie kabli światłowodowych fizycznie odrębnymi wykopami i traktami.

10/54

Koncepcja nadmiarowości (Redundancy): aktywna a pasywna

Sposoby wykorzystania zasobów zapasowych.

Wykład 4: Koncepcja nadmiarowości (Redundancy): aktywna a pasywna

  • Nadmiarowość pasywna (Active-Standby / Cold/Warm Standby): element zapasowy jest włączony i oczekuje w gotowości, ale nie przetwarza ruchu; w razie awarii następuje przełączenie.
  • Wada nadmiarowości pasywnej: 50% zakupionego pasma i sprzętu leży bezczynnie w normalnych warunkach pracy.
  • Nadmiarowość aktywna (Active-Active): oba elementy równolegle przetwarzają ruch i dzielą się obciążeniem (Load Balancing); w razie awarii jeden z nich przejmuje 100% ruchu.
  • Dążenie inżynierskie: projektowanie struktur Active-Active na wszystkich poziomach sieci kampusowej.
Redundancja sieciowa to celowe wprowadzenie nadmiarowych elementów sprzętowych, połączeń kablowych oraz instancji oprogramowania; dzieli się na pasywną (Cold/Warm Standby) oraz aktywną (Hot Standby / Active-Active), realizującą ciągłe dzielenie obciążenia.
Ilustracja techniczna do slajdu 10: Koncepcja nadmiarowości (Redundancy): aktywna a pasywna

Nadmiarowość w sieciach teleinformatycznych realizowana jest w modelu aktywno-pasywnym (Active/Standby) lub aktywno-aktywnym (Active/Active). W modelu aktywno-pasywnym element zapasowy pozostaje bezczynny do momentu wykrycia awarii węzła głównego.

Współczesna inżynieria preferuje model aktywno-aktywny, w którym oba nadmiarowe tory biorą aktywny udział w przesyłaniu pakietów (np. agregacja LACP, protokół GLBP, trasy ECMP). Zapewnia to podwojenie dostępnej przepustowości oraz natychmiastowe przejęcie ruchu bez stanów przejściowych.

W modelu aktywno-pasywnym zasoby rezerwowe pozostają bezczynne przez większość czasu eksploatacji, generując koszty zakupu i zasilania bez wnoszenia wkładu w bieżącą wydajność sieci. Przejście na architekturę aktywno-aktywną (np. za pomocą agregacji wielourządzeniowej) pozwala na pełne wykorzystanie sumarycznego pasma wszystkich zainstalowanych łączy oraz równomierne rozproszenie obciążenia cieplnego w szafach dystrybucyjnych.

Skróty użyte w tym slajdzie:
Active/Active - Nadmiarowość aktywna, Układ, w którym wszystkie redundantne komponenty jednocześnie przesyłają ruch sieciowy.
Active/Standby - Nadmiarowość pasywna, Układ z elementem rezerwowym, który podejmuje pracę dopiero po wykryciu awarii węzła głównego.
ECMP - Equal-Cost Multi-Path, Mechanizm routingu L3 realizujący aktywną nadmiarowość Active/Active.

11/54

Pętle w warstwie 2: mechanizm powstawania pętli przełączania

Konsekwencja wprowadzenia nadmiarowych połączeń kablowych między przełącznikami.

Wykład 4: Pętle w warstwie 2: mechanizm powstawania pętli przełączania

  • Potrzeba nadmiarowości: połączenie przełącznika dostępowego dwoma kablami do dwóch przełączników dystrybucyjnych tworzy fizyczny trójkąt (pętlę).
  • Brak mechanizmu TTL w ramce Ethernet: nagłówek ramki w warstwie 2 nie zawiera pola czasu życia (Time To Live), które występuje w pakiecie IP.
  • Brak możliwości samoczynnego wygaśnięcia ramki: ramka Ethernet wprowadzona w pętlę krąży w niej w nieskończoność, dopóki fizycznie nie wyłączy się zasilania.
  • Konieczność zastosowania protokołu logicznie blokującego nadmiarowe porty.
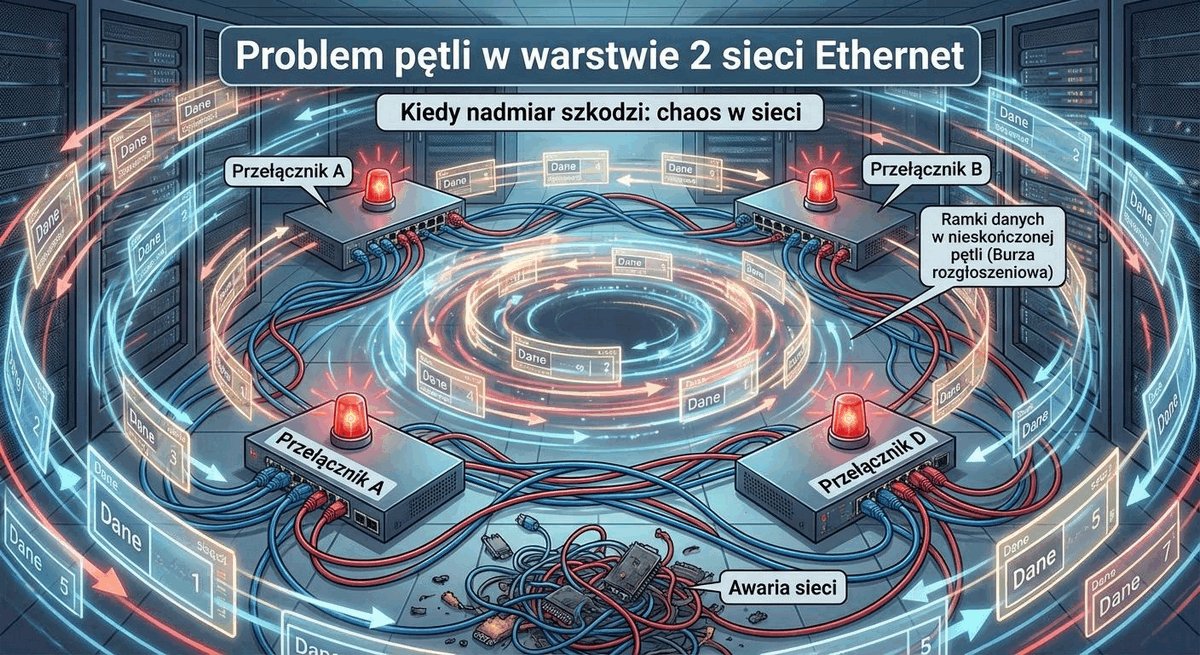
Pętla w warstwie 2 (Switching Loop) to sytuacja w sieci ethernetowej, w której pomiędzy przełącznikami istnieje więcej niż jedna aktywna ścieżka fizyczna. Z powodu braku mechanizmu TTL w nagłówkach Ethernet ramki krążą w pętli w nieskończoność.
Ilustracja techniczna do slajdu 11: Pętle w warstwie 2: mechanizm powstawania pętli przełączania

Wprowadzenie fizycznych połączeń nadmiarowych pomiędzy przełącznikami warstwy 2 stwarza poważne zagrożenie w postaci pętli przełączania. Ramka Ethernet w odróżnieniu od pakietu IP nie posiada w swoim nagłówku pola czasu życia TTL (Time to Live) ani licznika przeskoków.

W rezultacie ramka rozgłoszeniowa (Broadcast), transmisja grupowa (Multicast) lub nieznany pakiet unicast wprowadzony w pętlę fizyczną krąży w niej w nieskończoność, będąc powielanym przez każdy napotkany przełącznik, co prowadzi do lawinowej katastrofy transmisyjnej.

Fizyczna natura przełączania w warstwie 2 sprawia, że przełącznik Ethernet podejmuje decyzję o przekazaniu ramki wyłącznie na podstawie adresu docelowego MAC oraz zawartości lokalnej tablicy CAM. W przypadku braku wpisu dla danego adresu docelowego przełącznik wykonuje operację rozsyłania zalewowego (Flooding) na wszystkie aktywne porty w danym VLAN-ie, co w zamkniętej pętli fizycznej prowadzi do powielania ramki z prędkością łącza (Line Rate).

Skróty użyte w tym slajdzie:
L2 Loop - Pętla warstwy 2, Zamknięty fizyczny obwód połączeń pomiędzy przełącznikami Ethernet.
TTL - Time To Live, Brak pola TTL w nagłówku Ethernet powodujący krążenie ramek w nieskończoność.
Broadcast - Ramka rozgłoszeniowa, Ramka powielana przez przełącznik na wszystkie porty, stanowiąca źródło burzy broadcastowej.

12/54

Skutki pętli przełączania: burze rozgłoszeniowe (Broadcast Storms)

Destrukcyjny wpływ pętli warstwy 2 na medium i przełączniki.

Wykład 4: Skutki pętli przełączania: burze rozgłoszeniowe (Broadcast Storms)

  • Mechanizm zalewania (Flooding): przełącznik otrzymując ramkę rozgłoszeniową (np. zapytanie ARP) powiela ją na wszystkie porty z wyjątkiem portu wejściowego.
  • Eksplozja multiplikacji: w pętli zamkniętej z 3 przełączników jedna ramka jest natychmiast powielana na 2, 4, 8, 16... ramek.
  • Saturacja łączy: w ułamku sekundy łącza 1 Gb/s lub 10 Gb/s zostają w 100% zapełnione krążącymi pakietami broadcast.
  • Przepełnienie buforów i załamanie procesorów przełączników: diody portów świecą jednostajnym światłem, przełączniki przestają odpowiadać na polecenia zarządzania.
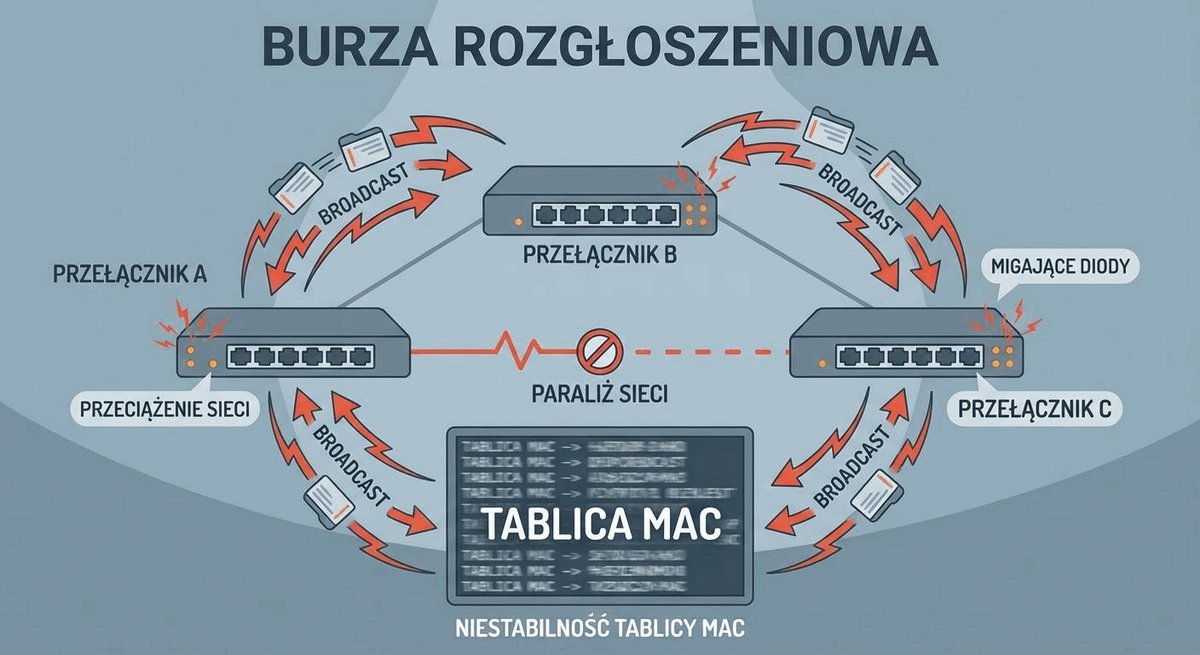
Burza rozgłoszeniowa (Broadcast Storm) to stan krytyczny sieci wywołany niekontrolowaną cyrkulacją i powielaniem ramek rozgłoszeniowych lub grupowych (Multicast) w pętli L2, prowadzący do stuprocentowego nasycenia łączy i zawieszenia pracy urządzeń sieciowych.
Ilustracja techniczna do slajdu 12: Skutki pętli przełączania: burze rozgłoszeniowe (Broadcast Storms)

Skutkiem zamknięcia pętli w warstwie 2 jest zjawisko burzy rozgłoszeniowej (Broadcast Storm). W ułamku sekundy miliony powielanych ramek nasycają w 100% pasmo wszystkich łącz fizycznych w obrębie danego segmentu VLAN.

Wszystkie interfejsy przełączników zostają zablokowane, bufory pamięci ulegają przepełnieniu, a procesory urządzeń zostają sparaliżowane obsługą setek tysięcy przerwań sieciowych. Komunikacja w sieci zamiera całkowicie, a jedynym ratunkiem staje się fizyczne odpięcie kabli.

Burza rozgłoszeniowa w ciągu kilkunastu milisekund doprowadza do wysycenia buforów portów przełącznika oraz przeciążenia głównego procesora (CPU) urządzenia, który musi przetwarzać zalewowe ramki ARP i pakiety kontrolne. W takim stanie przełącznik przestaje odpowiadać na zapytania protokołów sterujących, co uniemożliwia zdalne zalogowanie się administratora i wymusza fizyczne odłączanie kabli krosowych w szafie teletechnicznej.

Skróty użyte w tym slajdzie:
Broadcast Storm - Burza rozgłoszeniowa, Zjawisko lawinowego narastania liczby powielanych ramek paraliżujące pasmo sieci.
CPU - Central Processing Unit, Procesor przełącznika wysycany w 100% podczas trwania burzy rozgłoszeniowej.
ASIC - Application-Specific Integrated Circuit, Sprzętowa matryca przełączająca blokowana przez przepełnienie buforów pakietowych.

13/54

Skutki pętli przełączania: niestabilność tablic MAC i duplikacja ramek

Destabilizacja mechanizmów przełączania w warstwie 2.

Wykład 4: Skutki pętli przełączania: niestabilność tablic MAC i duplikacja ramek

  • Zjawisko MAC Address Flapping: ta sama ramka krążąca w pętli trafia do przełącznika na przemian przez port A i port B; przełącznik w sposób ciągły przepisuje tablicę CAM.
  • Wypłukiwanie zasobów: procesor przełącznika zużywa 100% mocy na nieustanną aktualizację wpisów w tablicy adresów fizycznych.
  • Wielokrotne dostarczanie ramek (Multiple Frame Transmission): urządzenie docelowe otrzymuje dziesiątki kopii tej samej ramki unicast, co destabilizuje stosy sieciowe systemów operacyjnych.
  • Natychmiastowy paraliż wszystkich stacji roboczych podłączonych do danego segmentu L2.
Niestabilność tablicy MAC (MAC Table Flapping) występuje, gdy przełącznik odbiera kopie tej samej ramki na różnych portach, co powoduje ciągłe nadpisywanie powiązań adresów i drastyczny wzrost obciążenia procesora przełącznika.
Ilustracja techniczna do slajdu 13: Skutki pętli przełączania: niestabilność tablic MAC i duplikacja ramek

Drugim destrukcyjnym skutkiem pętli L2 jest niestabilność tablic adresów fizycznych, określana mianem trzepotania tablicy MAC (MAC Flapping). Gdy ta sama ramka krąży w pętli, trafia do przełącznika naprzemiennie przez różne porty.

Przełącznik nieustannie nadpisuje powiązanie adresu MAC nadawcy z numerem portu, tracąc zdolność do poprawnego przekazywania ruchu unicast. Równocześnie stacje odbiorcze otrzymują tysiące zduplikowanych kopii tego samego pakietu, co powoduje zawieszanie stosów sieciowych w systemach operacyjnych.

Równoległym skutkiem pętli przełączania jest zjawisko trzepotania tablicy MAC (MAC Table Flapping). Ramka krążąca w pętli dociera do przełącznika na przemian przez różne porty z tym samym adresem źródłowym, co wymusza ciągłe przepisywanie tablicy CAM. Prowadzi to do całkowitej dezorganizacji mechanizmu przełączania, zrywania sesji TCP oraz masowej duplikacji pakietów odbieranych przez stacje robocze.

Skróty użyte w tym slajdzie:
CAM - Content-Addressable Memory, Tablica przełącznika ulegająca zjawisku MAC Flapping (ciągłego przepisywania portów skojarzonych z adresem MAC).
MAC Flapping - Przepisywanie adresów MAC, Ciągła zmiana portu źródłowego dla tego samego adresu MAC wywołana pętlą L2.
Duplication - Duplikacja pakietów, Wielokrotne odbieranie tej samej kopii ramki przez stację docelową destabilizujące stos TCP.

14/54

Protokół drzewa rozpinającego: idea i działanie klasycznego STP

Koncepcja logicznego łamania pętli fizycznych opracowana przez Radia Perlman.

Wykład 4: Protokół drzewa rozpinającego: idea i działanie klasycznego STP

  • Standard IEEE 802.1D: protokół Spanning Tree Protocol (STP).
  • Zasada działania: protokół monitoruje topologię sieci, identyfikuje fizyczne pętle i logicznie blokuje wybrane porty przełączników.
  • Transformacja topologii z pętlami w logiczne drzewo acykliczne (bez pętli).
  • Samoczynna rekonfiguracja: w momencie wykrycia fizycznej awarii aktywnego kabla port zablokowany zostaje automatycznie odblokowany.
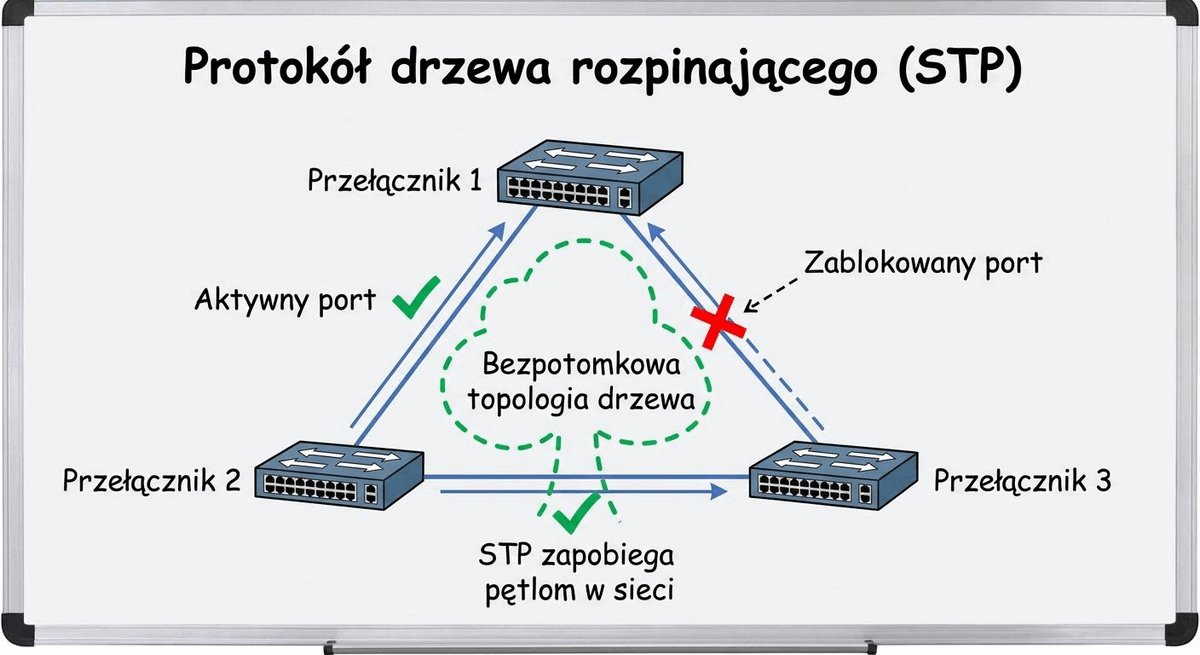
Spanning Tree Protocol (STP, IEEE 802.1D) to protokół warstwy łącza danych, który zapobiega powstawaniu pętli w sieciach Ethernet poprzez dynamiczne blokowanie wybranych portów przełączników przy zachowaniu fizycznej redundancji połączeń.
Ilustracja techniczna do slajdu 14: Protokół drzewa rozpinającego: idea i działanie klasycznego STP

W celu pogodzenia fizycznej nadmiarowości z eliminacją pętli opracowano protokół drzewa rozpinającego STP (Spanning Tree Protocol, zdefiniowany w normie IEEE 802.1D). Twórczynią matematycznych podstaw protokołu była Radia Perlman.

Działanie protokołu polega na dynamicznym wykrywaniu wszystkich fizycznych cykli w grafie sieci i logicznym zablokowaniu wybranych portów nadmiarowych. W ten sposób powstaje acykliczne drzewo rozpinające, a zablokowane porty przechodzą w stan czuwania na wypadek awarii łącza głównego.

Klasyczny protokół Spanning Tree Protocol (IEEE 802.1D) rozwiązuje problem pętli poprzez logiczne blokowanie wybranych portów w sieci, tworząc jednotorową strukturę drzewa rozpinającego. Węzłem centralnym całego środowiska staje się most główny (Root Bridge), a wszystkie pozostałe przełączniki wyznaczają najkrótsze ścieżki do niego na podstawie skumulowanego kosztu portów (Root Path Cost).

W mechanizmie działania protokołu STP kluczową rolę odgrywa wymiana ramek BPDU typu Configuration BPDU, które są generowane wyłącznie przez Root Bridge co 2 sekundy (timer Hello Time) i propagowane przez pozostałe mosty wzdłuż aktywnego drzewa. Zmiana topologii, na przykład awaria łącza, wyzwala transmisję specjalnych ramek TCN (Topology Change Notification), które powodują drastyczne skrócenie czasu wygasania wpisów w tablicy CAM przełączników z 300 sekund do 15 sekund, wymuszając szybkie odświeżenie ścieżek transmisyjnych.

Skróty użyte w tym slajdzie:
STP - Spanning Tree Protocol, Protokół IEEE 802.1D logicznie blokujący nadmiarowe połączenia w celu stworzenia bezpętlowego drzewa.
BPDU - Bridge Protocol Data Unit, Specjalna ramka sterująca przesyłana przez mosty w celu wyznaczenia topologii drzewa.
IEEE 802.1D - Standard STP, Pierwotny standard protokołu drzewa rozpinającego opracowany przez Radia Perlman.

15/54

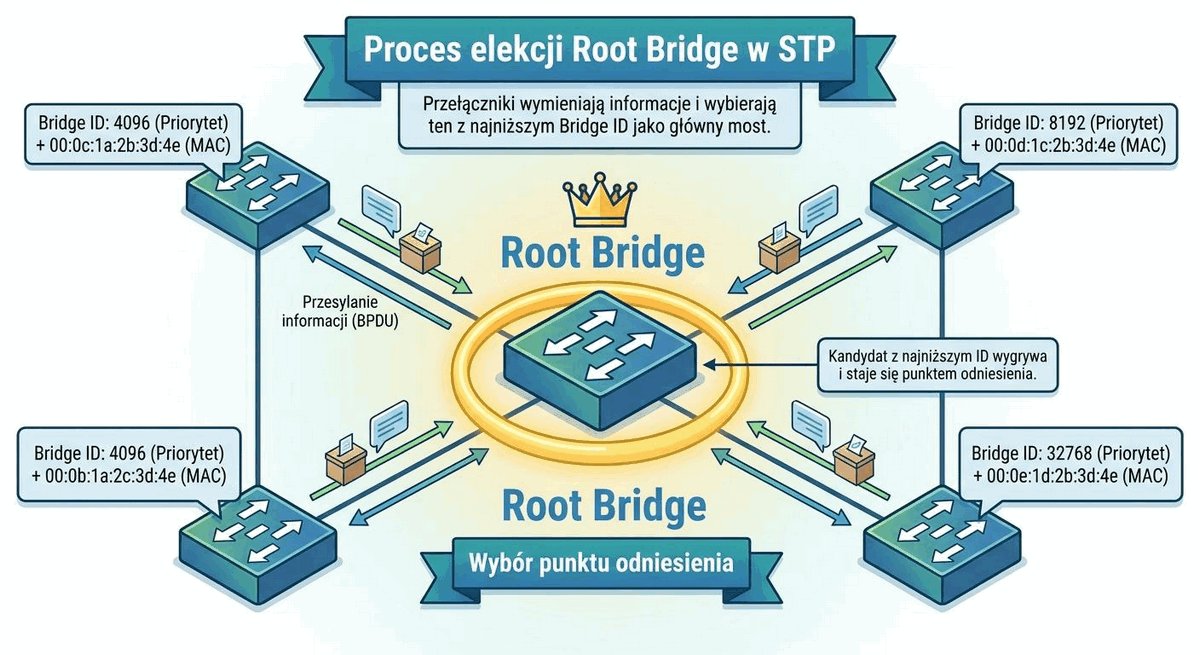
Algorytm Spanning Tree: proces elekcji mostu głównego (Root Bridge)

Deterministyczny wybór punktu odniesienia dla całego drzewa.

Wykład 4: Algorytm Spanning Tree: proces elekcji mostu głównego (Root Bridge)

  • Pakiety BPDU (Bridge Protocol Data Unit): specjalne ramki wymieniane przez przełączniki co 2 sekundy w celu uzgodnienia topologii.
  • Identyfikator mostu Bridge ID (BID): składa się z priorytetu (wielokrotność 4096, domyślnie 32768) oraz adresu MAC przełącznika.
  • Elekcja mostu głównego: przełącznik o najniższej wartości Bridge ID staje się korzeniem drzewa (Root Bridge).
  • Krytyczna zasada inżynierska: Root Bridge nie może być wybierany przypadkowo; inżynier musi celowo skonfigurować priorytet (np. 4096) na przełączniku dystrybucji lub rdzenia.
Root Bridge (Most Główny) to centralny przełącznik w topologii STP stanowiący punkt odniesienia dla wszystkich obliczeń bezpętlowych ścieżek; wybierany jest deterministycznie na podstawie najniższego identyfikatora mostu (Bridge ID: priorytet + adres MAC).
Ilustracja techniczna do slajdu 15: Algorytm Spanning Tree: proces elekcji mostu głównego (Root Bridge)

Algorytm STP rozpoczyna pracę od wyboru mostu głównego (Root Bridge), który staje się korzeniem całego drzewa. Mostem głównym zostaje przełącznik o najniższej wartości identyfikatora Bridge ID (składającego się z 2-bajtowego priorytetu oraz 6-bajtowego adresu MAC).

Dobra praktyka inżynierska bezwzględnie nakazuje ręczne wymuszenie roli Root Bridge na przełącznikach rdzeniowych poprzez obniżenie ich priorytetu (np. poleceniem spanning-tree vlan X root primary / priority 4096). Pozostawienie wartości domyślnej (32768) grozi przypadkowym wyborem przełącznika dostępowego jako mostu głównego.

Proces elekcji mostu głównego opiera się na porównaniu identyfikatorów Bridge ID (złożonych z priorytetu i adresu MAC przełącznika). W środowisku kampusowym niedopuszczalne jest pozostawienie domyślnych priorytetów (32768), gdyż przypadkowe podłączenie starego przełącznika o najniższym adresie MAC mogłoby spowodować mianowanie go mostem głównym. Inżynier musi jawnie skonfigurować najniższy priorytet na głównym przełączniku rdzeniowym.

Skróty użyte w tym slajdzie:
Root Bridge - Most główny, Centralny przełącznik sieci stanowiący korzeń drzewa rozpinającego dla całej domeny.
Bridge ID - Identyfikator mostu, 8-bajtowa wartość składająca się z priorytetu mostu (2 bajty) oraz adresu MAC przełącznika (6 bajtów).
Priority - Priorytet mostu, Wartość konfigurowalna w krokach co 4096 decydująca o wyborze Root Bridge (domyślnie 32768).

16/54

Role i stany portów w protokole STP

Struktura logiczna połączeń w drzewie rozpinającym.

Wykład 4: Role i stany portów w protokole STP

  • Role portów w klasycznym STP:
  • Root Port (RP): port na przełączniku niebędącym korzeniem o najniższym koszcie ścieżki do mostu głównego (jeden na przełącznik).
  • Designated Port (DP): port wyznaczony w danym segmencie kablowym, przesyłający ruch w stronę mostu głównego.
  • Non-Designated / Blocking Port (BP): port logicznie zablokowany, odrzucający ramki danych użytkowników, nasłuchujący jedynie BPDU.
  • Sekwencja stanów portu: Blocking -> Listening (15s) -> Learning (15s) -> Forwarding.
Rola portu w STP (Root, Designated, Alternate/Blocking) określa jego funkcję w drzewie, natomiast stan portu (Blocking, Listening, Learning, Forwarding) reguluje uprawnienia do przetwarzania ramek BPDU, uczenia się adresów MAC oraz przekazywania ruchu użytkowników.
Ilustracja techniczna do slajdu 16: Role i stany portów w protokole STP

W klasycznym protokole STP każdy port przełącznika przyjmuje określoną rolę: Root Port (port o najniższym koszcie dotarcia do mostu głównego), Designated Port (port wyznaczony w danym segmencie) lub Blocking/Alternate Port (port zablokowany eliminujący pętlę).

Przejście portu do stanu przekazywania (Forwarding) odbywa się przez sekwencję stanów przejściowych: Blocking, Listening oraz Learning. W stanach tych przełącznik analizuje ramki BPDU i uczy się adresów MAC, nie przekazując jednak pakietów użytkowników, co zapobiega powstawaniu pętli przejściowych.

Klasyczny stan blokowania (Blocking) w protokole 802.1D zapobiega pętlom, lecz wiąże się ze statycznym marnowaniem przepustowości portu rezerwowego. Dodatkowo przejście portu ze stanu blokowania do stanu przekazywania (Forwarding) wymaga przejścia przez stany pośrednie Listening i Learning, z których każdy trwa domyślnie po 15 sekund (wartość timera Forward Delay), co paraliżuje szybkie przywracanie łączności.

Skróty użyte w tym slajdzie:
Root Port - Port główny, Port na przełączniku podrzędnym oferujący najniższy koszt dotarcia do mostu głównego.
Designated Port - Port wyznaczony, Port odpowiedzialny za przesyłanie ruchu z danego segmentu sieci w kierunku Root Bridge.
Blocking - Stan blokowania, Stan portu, w którym odrzuca on ramki danych użytkowników, nasłuchując jedynie ramek BPDU.

17/54

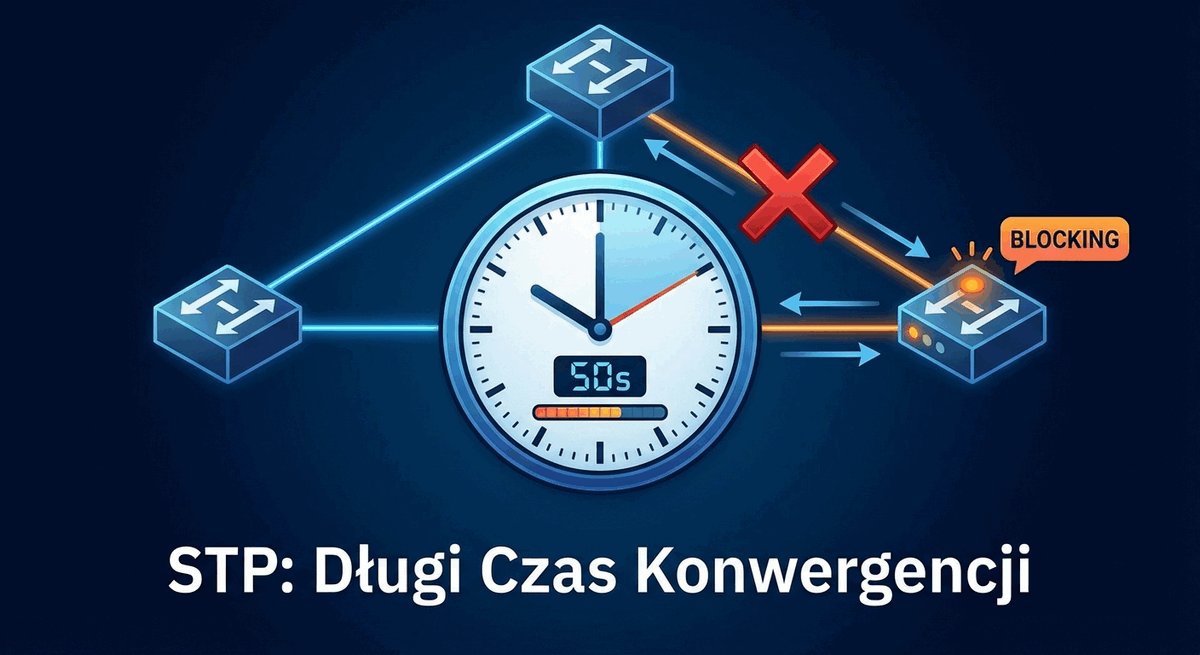
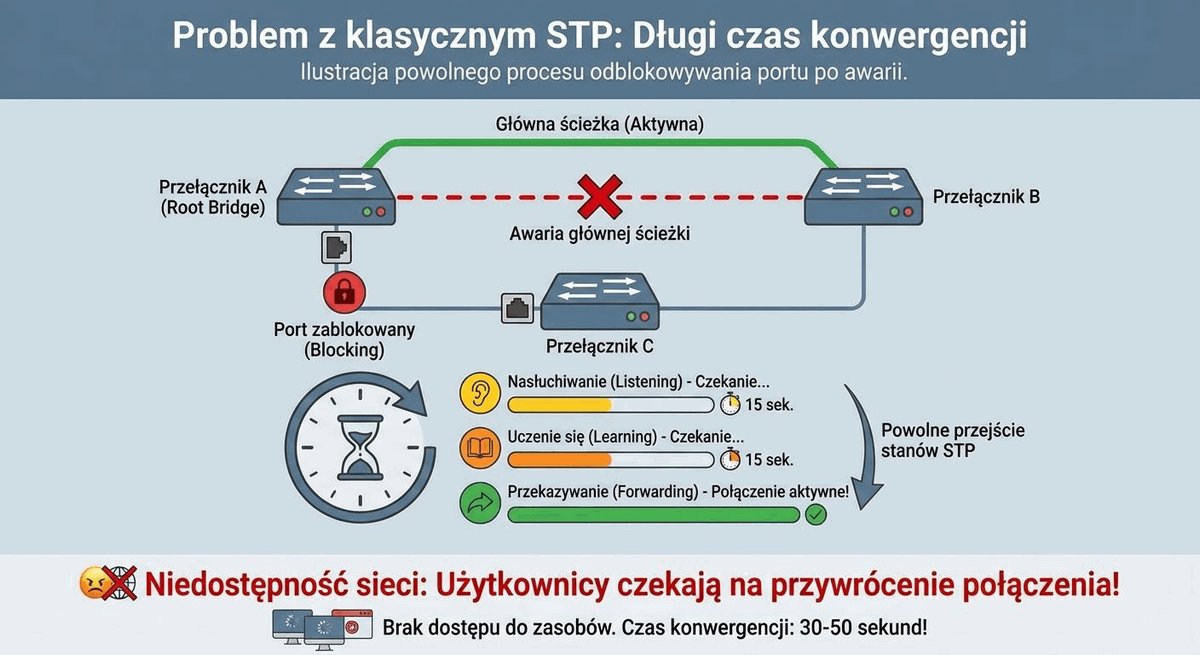
Ograniczenia klasycznego STP: długi czas konwergencji

Niedopuszczalne czasy przestoju w nowoczesnych sieciach kampusowych.

Wykład 4: Ograniczenia klasycznego STP: długi czas konwergencji

  • Czas przejścia ze stanu blokowania do przekazywania w IEEE 802.1D:
  • Czas starzenia informacji Max Age: 20 sekund.
  • Stan nasłuchiwania Listening: 15 sekund (Forward Delay).
  • Stan uczenia się adresów Learning: 15 sekund (Forward Delay).
  • Całkowity czas przełączenia na łącze zapasowe wynosi od 30 do 50 sekund.
  • Dla współczesnych aplikacji VoIP, wideokonferencji i baz danych 50 sekund przerwy oznacza zerwanie wszystkich sesji.
  • Wniosek: klasyczny protokół IEEE 802.1D jest przestarzały i nie może być stosowany w nowych instalacjach.
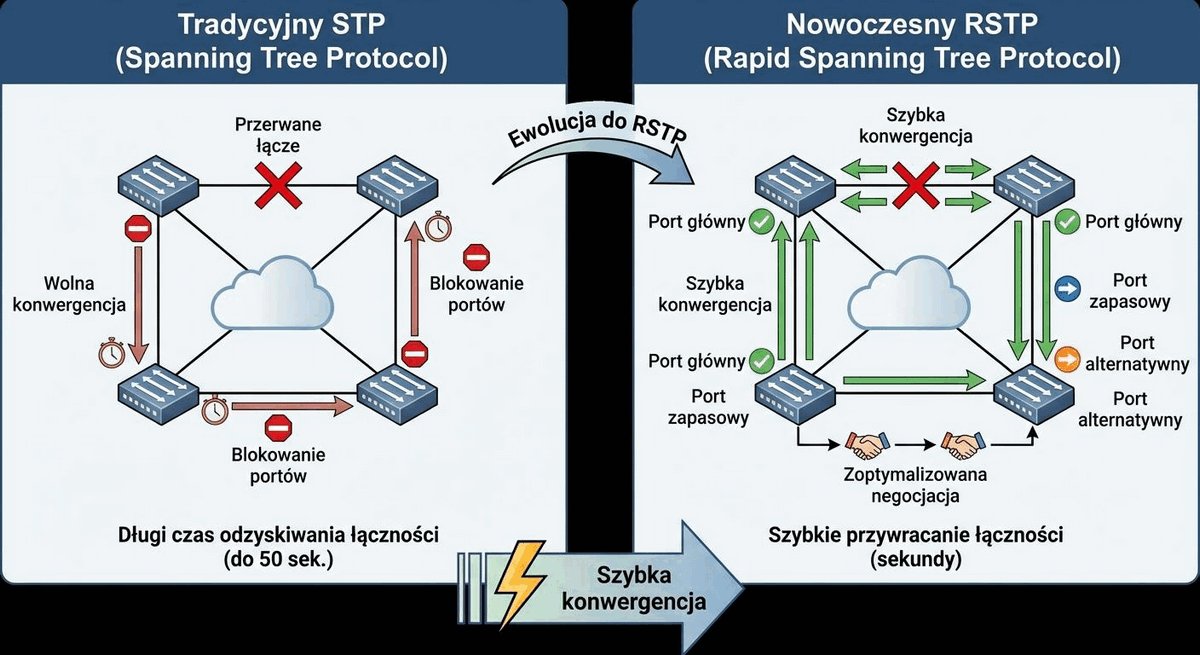
Czas zbieżności (Convergence Time) w klasycznym protokole IEEE 802.1D wynosi od 30 do 50 sekund z powodu sztywnych timerów (Forward Delay, Max Age), co we współczesnych sieciach kampusowych powoduje niedopuszczalne zerwanie sesji aplikacji multimedialnych.
Ilustracja techniczna do slajdu 17: Ograniczenia klasycznego STP: długi czas konwergencji

Głównym ograniczeniem klasycznego protokołu IEEE 802.1D jest bardzo powolna konwergencja. Czas potrzebny na przejście zablokowanego portu do stanu Forwarding po awarii łącza wynosi od 30 do nawet 50 sekund (czas Max Age 20 s + 2 x Forward Delay po 15 s).

Taka przerwa w transmisji jest współcześnie całkowicie niedopuszczalna: powoduje zerwanie wszystkich połączeń telefonicznych VoIP, restart sesji bazodanowych oraz awarie systemów wirtualizacji. Z tego względu klasyczny standard 802.1D został oficjalnie wycofany i zastąpiony przez standard RSTP.

Podstawową wadą protokołu 802.1D w nowoczesnym kampusie są sztywne timery (Max Age równe 20 sekund oraz dwa razy Forward Delay po 15 sekund). Oznacza to, że po fizycznym uszkodzeniu łącza głównego przełącznik rezerwowy czeka aż 50 sekund przed podjęciem transmisji pakietów, co z punktu widzenia współczesnych aplikacji multimedialnych i transmisji głosu VoIP oznacza całkowite zerwanie sesji użytkowników.

Skróty użyte w tym slajdzie:
Convergence - Czas zbieżności, Czas potrzebny na rekonfigurację topologii; w klasycznym STP wynosił od 30 do 50 sekund.
Listening - Stan nasłuchiwania, 15-sekundowy stan przejściowy STP, w którym przełącznik nasłuchuje BPDU bez uczenia się adresów MAC.
Learning - Stan uczenia się, 15-sekundowy stan przejściowy, w którym przełącznik uczy się adresów MAC bez przesyłania danych.

18/54

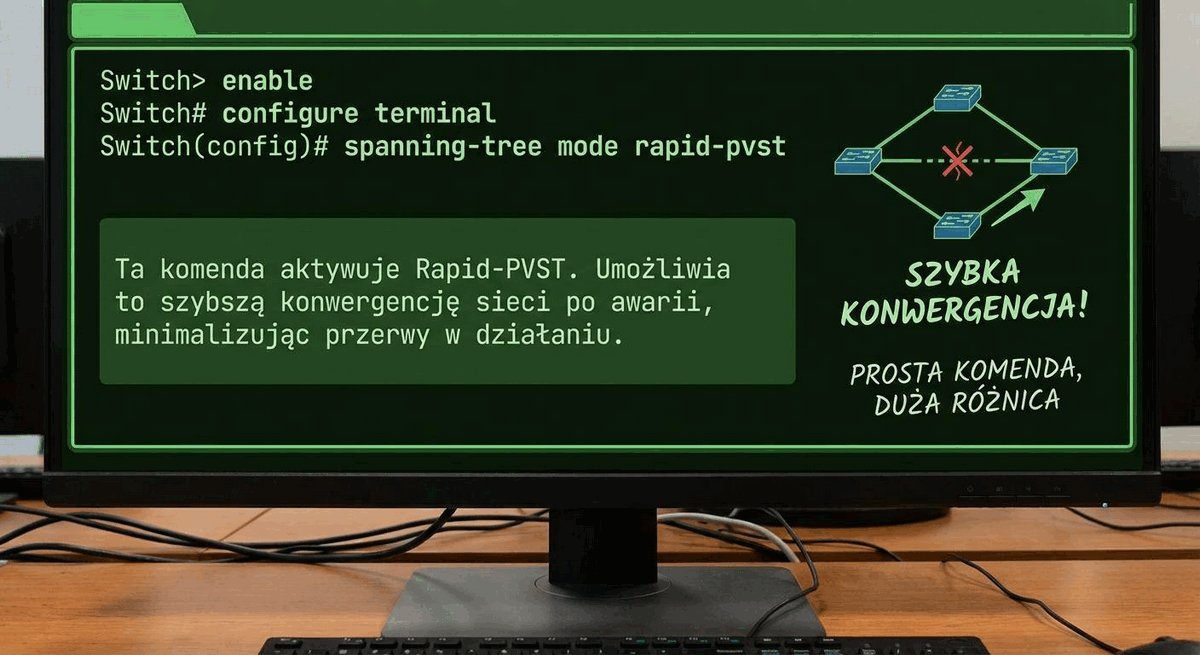
Protokół Rapid Spanning Tree Protocol (RSTP - IEEE 802.1w)

Skokowa redukcja czasu zbieżności drzewa rozpinającego.

Wykład 4: Protokół Rapid Spanning Tree Protocol (RSTP - IEEE 802.1w)

  • Standard IEEE 802.1w (obecnie włączony do IEEE 802.1Q-2022).
  • Redukcja stanów portów do trzech: Discarding, Learning, Forwarding.
  • Wprowadzenie nowych ról portów zapasowych:
  • Alternate Port: natychmiastowa rezerwa dla portu Root Port (jeśli padnie RP, Alternate natychmiast staje się nowym RP).
  • Backup Port: rezerwa dla portu Designated Port w tym samym segmencie współdzielonym.
  • Czasy konwergencji: skrócenie czasu reakcji na awarię z 50 sekund do 1-2 sekund (a w połączeniach punkt-punkt do kilkudziesięciu milisekund).
Rapid Spanning Tree Protocol (RSTP, standard IEEE 802.1w włączony do IEEE 802.1Q) skraca czas konwergencji po awarii do kilkudziesięciu milisekund dzięki bezpośredniej procedurze uzgadniania stanów portów pomiędzy sąsiednimi przełącznikami.
Ilustracja techniczna do slajdu 18: Protokół Rapid Spanning Tree Protocol (RSTP - IEEE 802.1w)

Standard IEEE 802.1w wprowadził protokół Rapid Spanning Tree Protocol (RSTP), który zredukował czas konwergencji sieci do wartości poniżej 1 sekundy (zazwyczaj od kilkudziesięciu do kilkuset milisekund).

RSTP zredukował liczbę stanów portu do trzech (Discarding, Learning, Forwarding) oraz zdefiniował nową rolę portu Alternate (natychmiastowy zapasowy port dla Root Portu) i Backup (zapas dla Designated Portu). Porty podłączone do stacji końcowych konfigurowane są jako Edge Ports (PortFast) i przechodzą w stan Forwarding natychmiastowo.

Protokół RSTP (IEEE 802.1w) zredukował liczbę stanów portu do trzech (Discarding, Learning, Forwarding) oraz wprowadził nowe role: port alternatywny (Alternate Port) stanowiący natychmiastową kopię zapasową dla portu Root Port, oraz port zapasowy (Backup Port) zabezpieczający port desygnowany. Dzięki temu w przypadku awarii przełącznik może natychmiast odblokować port alternatywny bez czekania na upłynięcie timerów.

Skróty użyte w tym slajdzie:
RSTP - Rapid Spanning Tree Protocol, Standard IEEE 802.1w skracający czas zbieżności drzewa rozpinającego do kilkudziesięciu milisekund.
Alternate Port - Port alternatywny, Zapasowy port oferujący alternatywną ścieżkę do mostu głównego natychmiast przejmujący ruch po awarii Root Portu.
Backup Port - Port zapasowy, Port rezerwowy dla segmentu współdzielonego chroniący przed awarią Designated Portu.

19/54

Mechanizm szybkiej negocjacji Proposal/Agreement w RSTP

Zasada działania synchronizacji uzgadniania stanów (handshake) między przełącznikami.

Wykład 4: Mechanizm szybkiej negocjacji Proposal/Agreement w RSTP

  • Zastąpienie biernego odliczania timerów bezpośrednią negocjacją między sąsiadami.
  • Wymóg: połączenie musi pracować w trybie pełnego dupleksu (Point-to-Point link).
  • Przebieg negocjacji: przełącznik nadrzędny wysyła ramkę Proposal; przełącznik podrzędny natychmiast blokuje swoje porty nieszkieletowe (Sync) i odsyła ramkę Agreement.
  • Port przechodzi w stan Forwarding w ciągu ułamków milisekund bez czekania na Forward Delay.
  • Koncepcja Edge Ports: porty podłączone do stacji roboczych przechodzą w stan Forwarding natychmiast (odpowiednik Cisco PortFast).
Negocjacja Proposal/Agreement to synchroniczny mechanizm wymiany ramek BPDU typu handshake na łączach Point-to-Point, umożliwiający natychmiastowe przejście nowego portu w stan Forwarding z pominięciem opóźnień timerów nasłuchiwania i uczenia się.
Ilustracja techniczna do slajdu 19: Mechanizm szybkiej negocjacji Proposal/Agreement w RSTP

Kluczem do ultraszybkiej zbieżności protokołu RSTP jest mechanizm aktywnej negocjacji Proposal/Agreement na łączach dwupunktowych (Point-to-Point). W przypadku zmiany topologii przełączniki nie czekają na wygaśnięcie sztywnych timerów, lecz natychmiast wymieniają uścisk dłoni.

Przełącznik nadrzędny wysyła ramkę Proposal, sąsiad na ułamek sekundy synchronizuje swoje porty (Sync) i odsyła ramkę Agreement. Cały proces trwa kilkanaście milisekund, nie generując żadnych zakłóceń w transmisji ruchu pakietowego.

Mechanizm uzgadniania Proposal/Agreement w RSTP opiera się na bezpośredniej wymianie ramek BPDU między sąsiednimi przełącznikami na łączach typu punkt-punkt (Point-to-Point). Przełącznik nadrzędny wysyła propozycję przejęcia roli desygnowanej, a sąsiad po chwilowej synchronizacji portów natychmiast odsyła potwierdzenie, co pozwala na przejście portu w stan przekazywania w czasie poniżej kilkudziesięciu milisekund.

W procedurze uzgadniania Proposal/Agreement w RSTP port przełącznika przechodzący w stan wyznaczony (Designated) natychmiast wysyła ramkę BPDU z ustawioną flagą Proposal. Sąsiedni przełącznik, aby zaakceptować tę propozycję i odesłać ramkę z flagą Agreement, musi wcześniej tymczasowo zablokować wszystkie swoje porty nieskrajne (operacja Sync). Chroni to sieć przed powstaniem chwilowej pętli transmisyjnej w trakcie gwałtownej rekonfiguracji ról portów, umożliwiając osiągnięcie pełnej zbieżności w czasie poniżej 50 milisekund.

Skróty użyte w tym slajdzie:
Proposal/Agreement - Uścisk dłoni RSTP, Mechanizm bezpośredniej negocjacji ról pomiędzy sąsiednimi przełącznikami na łączach Point-to-Point.
Sync - Synchronizacja stanów, Błyskawiczne zablokowanie portów nietrwających w celu bezpiecznego odblokowania nowego portu głównego.
Edge Port - Port brzegowy, Port podłączony do stacji końcowej przechodzący natychmiast w stan Forwarding bez udziału procesu negocjacji.

20/54

Problem braku równoważenia obciążenia w pojedynczym drzewie STP/RSTP

Marnowanie pasma w architekturze Single Spanning Tree.

Wykład 4: Problem braku równoważenia obciążenia w pojedynczym drzewie STP/RSTP

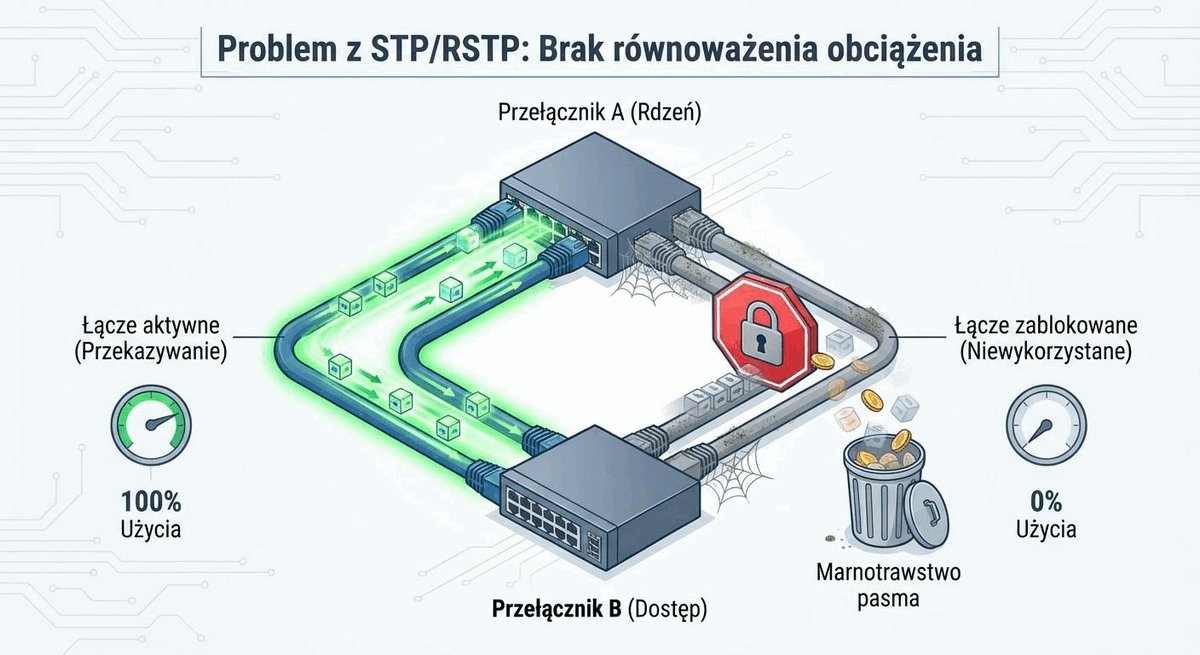
  • W klasycznym STP/RSTP (CST - Common Spanning Tree) istnieje tylko jedno wspólne drzewo dla wszystkich sieci VLAN.
  • Konsekwencja: łącze zablokowane przez protokół jest zablokowane dla WSZYSTKICH VLAN-ów w sieci.
  • Połowa zakupionych światłowodów i przepustowości szkieletu leży bezużytecznie jako zimna rezerwa.
  • Rozwiązanie alternatywne Cisco: PVST+ (Per-VLAN Spanning Tree) - osobna instancja STP dla każdego VLAN-u (ogromne obciążenie procesora przełącznika przy 200 VLAN-ach).
W klasycznym pojedynczym drzewie rozpinającym (CST) łącza zapasowe pozostają całkowicie zablokowane dla całego ruchu sieciowego, co powoduje marnotrawstwo pasma transmisyjnego i uniemożliwia zbalansowanie obciążenia pomiędzy alternatywnymi trasami.
Ilustracja techniczna do slajdu 20: Problem braku równoważenia obciążenia w pojedynczym drzewie STP/RSTP

Poważną wadą implementacji Single Spanning Tree (wspólnego drzewa CST dla wszystkich VLAN-ów) jest całkowity brak możliwości równoważenia obciążenia. Zablokowany port fizyczny blokuje ruch dla wszystkich sieci wirtualnych bez wyjątku.

W efekcie kosztowne łącza światłowodowe w kampusie pozostają niewykorzystane w 50%. Co więcej, cały ruch ze wszystkich VLAN-ów musi podróżować tą samą ścieżką drzewa, co może prowadzić do zatorów transmisyjnych w rejonie mostu głównego.

Architektura o pojedynczym drzewie rozpinającym (CST) wymusza, aby ta sama topologia bezpętlowa obowiązywała dla wszystkich sieci wirtualnych VLAN w kampusie. W efekcie dla każdego VLAN-u ruch jest blokowany na tych samych łączach fizycznych, co uniemożliwia równomierne wykorzystanie dostępnego pasma i prowadzi do powstawania wąskich gardeł na aktywnych traktach przy jednoczesnym braku obciążenia łączy rezerwowych.

Skróty użyte w tym slajdzie:
CST - Common Spanning Tree, Pojedyncza instancja drzewa STP dla wszystkich sieci VLAN blokująca te same łącza fizyczne.
PVST+ - Per-VLAN Spanning Tree Plus, Własnościowe rozwiązanie Cisco utrzymujące niezależną instancję drzewa STP dla każdego VLAN-u.
CPU Overhead - Narzut na procesor, Przeciążenie procesora przełącznika przy setkach instancji PVST+ wyeliminowane przez standard MSTP.

21/54

Protokół Multiple Spanning Tree Protocol (MSTP - IEEE 802.1s)

Optymalny, otwarty standard zarządzania wieloma drzewami rozpinającymi.

Wykład 4: Protokół Multiple Spanning Tree Protocol (MSTP - IEEE 802.1s)

  • Standard IEEE 802.1s (włączony do IEEE 802.1Q).
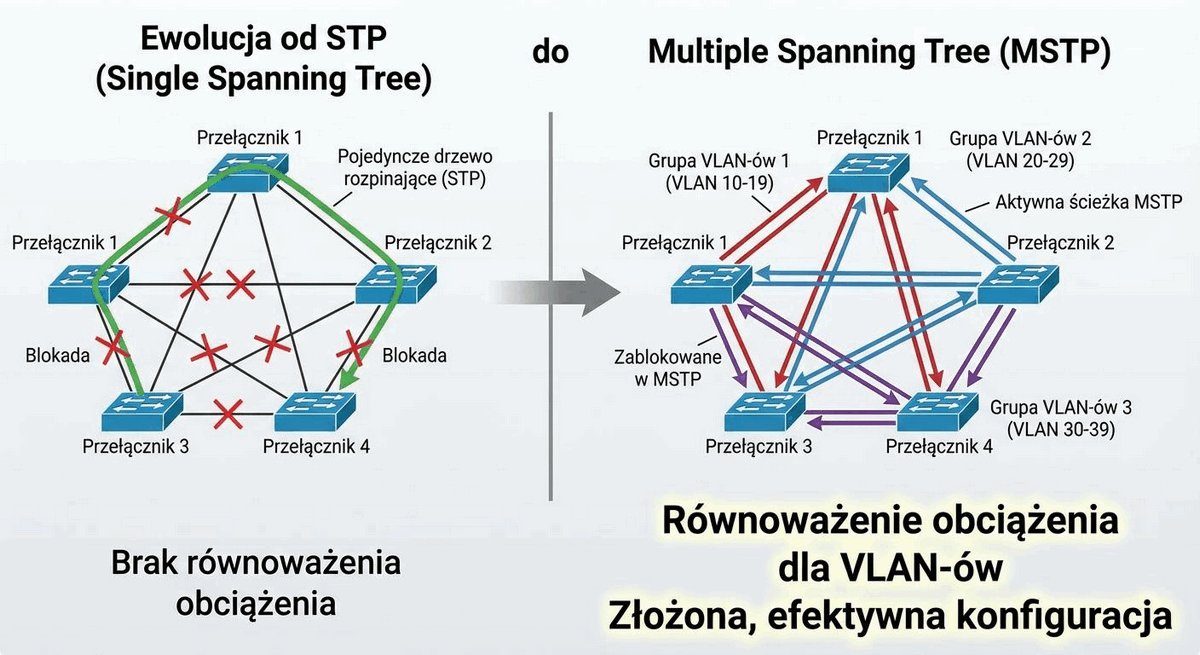
  • Koncepcja instancji MSTI (Multiple Spanning Tree Instances): mapowanie wielu sieci VLAN na ograniczoną liczbę logicznych drzew (np. 2 lub 3 instancje).
  • Przykład inżynierski:
  • Instancja 1 obsługuje VLAN-y nieparzyste (Root Bridge na przełączniku dystrybucyjnym A).
  • Instancja 2 obsługuje VLAN-y parzyste (Root Bridge na przełączniku dystrybucyjnym B).
  • Osiągnięcie pełnego równoważenia obciążenia (Load Balancing): oba łącza nadmiarowe aktywnie transmitują ruch, żadne nie leży bezczynnie.
  • Minimalne obciążenie CPU: przełącznik przetwarza tylko 2 instancje zamiast setek instancji PVST.
Multiple Spanning Tree Protocol (MSTP, norma IEEE 802.1s wchłonięta do IEEE 802.1Q) umożliwia przypisanie wielu sieci VLAN do zdefiniowanej liczby niezależnych instancji logicznych drzewa (MSTI), zapewniając optymalne równoważenie obciążenia przy minimalnym narzucie procesora.
Ilustracja techniczna do slajdu 21: Protokół Multiple Spanning Tree Protocol (MSTP - IEEE 802.1s)

Odpowiedzią na problem równoważenia ruchu w warstwie 2 jest protokół Multiple Spanning Tree Protocol (MSTP), zdefiniowany w standardzie IEEE 802.1s (włączonym obecnie do normy IEEE 802.1Q). MSTP stanowi otwarty kompromis pomiędzy CST a Cisco PVST+.

Własnościowy protokół Cisco PVST+ uruchamia osobną instancję STP dla każdego VLAN-u. W kampusie z 500 sieciami VLAN oznacza to generowanie 500 procesów STP, co prowadzi do przeciążenia procesora CPU przełączników. MSTP całkowicie rozwiązuje ten problem.

Wdrożenie standardu MSTP (IEEE 802.1s) w rozległym kampusie pozwala na osiągnięcie optymalnego kompromisu między efektywnością wykorzystania łączy a zużyciem zasobów procesora przełączników. Grupowanie setek logicznych sieci VLAN w dwie lub trzy instancje drzewa rozpinającego (MSTI) radykalnie zmniejsza liczbę generowanych i przetwarzanych ramek BPDU, zapobiegając przeciążeniu jednostek kontrolnych infrastruktury.

Z punktu widzenia studenta informatyki kluczową cechą protokołu MSTP jest kompatybilność wsteczna z klasycznymi standardami 802.1D i 802.1w. Cały region MSTP na zewnątrz prezentuje się jako pojedynczy, wirtualny most w nadrzędnym drzewie CST (Common Spanning Tree), a interakcje z sąsiednimi przełącznikami starszego typu reguluje instancja bazowa IST (Internal Spanning Tree). Umożliwia to stopniową, bezpieczną migrację sieci kampusowej bez konieczności jednoczesnego przestrajania całej floty urządzeń.

Skróty użyte w tym slajdzie:
MSTP - Multiple Spanning Tree Protocol, Standard IEEE 802.1s mapujący wiele sieci VLAN na niewielką liczbę instancji drzewa MSTI.
MST Region - Region MST, Grupa przełączników o identycznej nazwie regionu, numerze rewizji i mapowaniu VLAN-ów.
IST - Internal Spanning Tree, Podstawowa instancja drzewa działająca wewnątrz każdego regionu MSTP.

22/54

Grupowanie sieci VLAN w instancje MSTI w MSTP

Zasady konfiguracji regionu MST w kampusie.

Wykład 4: Grupowanie sieci VLAN w instancje MSTI w MSTP

  • Pojęcie regionu MST: zbiór przełączników posiadających identyczną konfigurację (ta sama nazwa regionu, ten sam numer rewizji i identyczna tablica mapowania VLAN do instancji).
  • Współpraca z tradycyjnym STP na granicy regionu: protokół CIST (Common and Internal Spanning Tree) reprezentujący cały region MST jako pojedynczy przełącznik wirtualny.
  • Determinizm projektowy: równomierne rozłożenie ruchu użytkowników, telefonów VoIP i kamer na różne instancje MST.
  • Zapewnienie pełnej redundancji z automatycznym przejęciem ruchu całego budynku przez jedno łącze w razie awarii.
Instancja MSTI (Multiple Spanning Tree Instance) grupuje wybrane sieci VLAN w jeden logiczny proces drzewa rozpinającego; dzięki temu w sieci z setkami VLAN-ów utrzymuje się zaledwie 2-3 instancje STP, optymalizując zużycie pamięci i procesora przełączników.
Ilustracja techniczna do slajdu 22: Grupowanie sieci VLAN w instancje MSTI w MSTP

Architektura MSTP opiera się na grupowaniu wielu sieci VLAN w niewielką liczbę logicznych instancji drzewa rozpinającego (MSTI - Multiple Spanning Tree Instances). W typowym kampusie definiuje się zazwyczaj dwie lub trzy instancje MSTI.

Przykładowo: MSTI 1 obsługuje parzyste sieci VLAN i posiada most główny na przełączniku Rdzeń-A, natomiast MSTI 2 obsługuje nieparzyste sieci VLAN z mostem głównym na przełączniku Rdzeń-B. Zapewnia to pełne równoważenie obciążenia łączy przy znikomym zużyciu zasobów procesora.

Projektowanie regionów MSTP wymaga bezwzględnej spójności parametrów konfiguracyjnych na wszystkich uczestniczących przełącznikach. Nazwa regionu, numer rewizji oraz tablica przypisania sieci VLAN do instancji MSTI muszą być identyczne, gdyż w przeciwnym razie przełączniki uznają się za należące do odrębnych regionów i zredukują komunikację do pojedynczego, nieefektywnego drzewa nadrzędnego (Common Spanning Tree).

Skróty użyte w tym slajdzie:
MSTI - Multiple Spanning Tree Instance, Instancja drzewa rozpinającego, do której przypisana jest określona grupa VLAN-ów w celu równoważenia obciążenia.
Load Balancing - Równoważenie obciążenia, Wyznaczenie różnych mostów głównych dla różnych instancji MSTI w celu utylizacji wszystkich łączy.
CIST - Common and Internal Spanning Tree, Ogólne drzewo rozpinające koordynujące współpracę regionów MST z tradycyjnymi mostami STP/RSTP.

23/54

Zaawansowane mechanizmy ochrony drzewa STP: BPDU Guard

Ochrona krawędzi sieci przed nieautoryzowaną ingerencją w topologię.

Wykład 4: Zaawansowane mechanizmy ochrony drzewa STP: BPDU Guard

  • Zastosowanie: na wszystkich portach dostępowych (Edge Ports), do których podłączone są komputery użytkowników, telefony czy drukarki.
  • Zagrożenie: student przynosi z domu prywatny przełącznik i wpina go do gniazdka w sali; przełącznik wysyła BPDU z priorytetem 0 i staje się Root Bridge całego kampusu, przekierowując ruch przez swój port 100 Mb/s.
  • Działanie BPDU Guard: odebranie choćby jednej ramki BPDU na porcie krawędziowym powoduje natychmiastowe wyłączenie portu (stan err-disable).
  • Reguła bezpieczeństwa: bezwzględny nakaz globalnego włączenia BPDU Guard na przełącznikach dostępowych.
BPDU Guard to zaawansowany mechanizm bezpieczeństwa warstwy 2, który natychmiast wprowadza port w stan err-disable po wykryciu nieautoryzowanej ramki BPDU na porcie brzegowym (Edge Port), chroniąc rdzeń sieci przed ingerencją z zewnątrz.
Ilustracja techniczna do slajdu 23: Zaawansowane mechanizmy ochrony drzewa STP: BPDU Guard

W celu ochrony integralności drzewa rozpinającego przed błędami użytkowników i atakami stosuje się mechanizm BPDU Guard. Funkcję tę włącza się bezwzględnie na wszystkich portach dostępowych skonfigurowanych w trybie PortFast/Edge.

Jeżeli do gniazdka abonenckiego ktoś podłączy nieautoryzowany przełącznik biurkowy lub złośliwy komputer generujący ramki BPDU, funkcja BPDU Guard natychmiast wyłącza port fizyczny i wprowadza go w stan err-disable, chroniąc całą sieć przed utratą stabilności.

Mechanizm BPDU Guard jest krytycznym elementem ochrony brzegu sieci kampusowej. W połączeniu z funkcją PortFast na portach dostępowych podłączonych do stacji roboczych i punktów AP, funkcja ta natychmiast wyłącza port (stan err-disable) w momencie odebrania jakiejkolwiek ramki BPDU. Chroni to szkielet przed podłączeniem przez użytkowników nieautoryzowanych przełączników biurowych mogących zaburzyć hierarchię drzewa rozpinającego.

Skróty użyte w tym slajdzie:
BPDU Guard - Ochrona portu brzegowego, Mechanizm wyłączający port dostępowy (stan err-disable) natychmiast po odebraniu ramki BPDU.
Err-disable - Stan błędu interfejsu, Bezpieczny stan zablokowania portu przez przełącznik w celu ochrony przed pętlą.
PortFast - Funkcja szybkiego przejścia, Konfiguracja portu brzegowego wymagająca bezwzględnej ochrony przez BPDU Guard.

24/54

Mechanizmy Root Guard i Loop Guard

Ochrona integralności pozycji mostu głównego i wykrywanie jednokierunkowych awarii łączy.

Wykład 4: Mechanizmy Root Guard i Loop Guard

  • Root Guard: konfigurowany na portach przełączników dystrybucyjnych skierowanych w dół (do dostępu); jeśli przełącznik na tym porcie zacznie rozgłaszać nadrzędne BPDU, port przechodzi w stan Root-Inconsistent i blokuje ruch, uniemożliwiając przejęcie roli korzenia.
  • Loop Guard: ochrona przed awarią jednokierunkową światłowodu (gdy uszkodzone jest jedno włókno Rx/Tx i przełącznik przestaje odbierać BPDU, błędnie uznając port za wolny od pętli).
  • Działanie Loop Guard: port zamiast przejść w stan Forwarding przechodzi w stan Loop-Inconsistent, zapobiegając katastrofalnej pętli.
  • Współpraca z protokołem detekcji jednokierunkowej UDLD (Unidirectional Link Detection).
Mechanizm Root Guard wymusza rolę portu Designated i zapobiega przejęciu funkcji Root Bridge przez nieautoryzowany przełącznik, natomiast Loop Guard chroni przed powstaniem pętli w wyniku jednokierunkowej awarii łącza (Unidirectional Link Failure).
Ilustracja techniczna do slajdu 24: Mechanizmy Root Guard i Loop Guard

Mechanizm Root Guard chroni wyznaczony most główny przed utratą prymatu na rzecz obcego przełącznika o niższym priorytecie. Włącza się go na portach downlink przełączników rdzeniowych i dystrybucyjnych.

Z kolei funkcja Loop Guard zabezpiecza sieć przed pętlami wywołanymi awariami jednokierunkowymi (Unidirectional Link Failure na światłowodach). W przypadku nagłego zaniku odbioru ramek BPDU na porcie blokowanym, Loop Guard wprowadza port w stan Loop-Inconsistent zamiast w stan Forwarding, zapobiegając katastrofie.

Funkcja Root Guard zabezpiecza wyznaczoną pozycję mostu głównego, uniemożliwiając sąsiednim urządzeniom narzucenie nowego Root Bridge poprzez emisję ramek BPDU o sztucznie zaniżonym priorytecie. Z kolei funkcja Loop Guard chroni łącza światłowodowe przed awariami jednokierunkowymi (Unidirectional Link Failure), przełączając port w stan niespójności pętli (Loop-Inconsistent) w przypadku nagłego ustania odbioru ramek BPDU na porcie blokowanym.

Skróty użyte w tym slajdzie:
Root Guard - Ochrona mostu głównego, Mechanizm uniemożliwiający portowi stania się Root Portem, zapobiegający przejęciu roli Root Bridge przez nieautoryzowany przełącznik.
Loop Guard - Ochrona przed pętlami jednokierunkowymi, Mechanizm wprowadzający port w stan Loop-Inconsistent, jeśli przestanie on odbierać ramki BPDU na łączu punkt-punkt.
Root-Inconsistent - Stan blokady Root Guard, Tymczasowe zablokowanie transmisji na porcie po odebraniu nadrzędnej ramki Superior BPDU.

25/54

Mechanizm BPDU Filter oraz ochrona przed błędną konfiguracją

Zastosowanie filtracji ramek sterujących na stykach domen.

Wykład 4: Mechanizm BPDU Filter oraz ochrona przed błędną konfiguracją

  • BPDU Filter: funkcja całkowicie blokująca wysyłanie i odbieranie ramek BPDU na porcie.
  • Ryzyko inżynierskie: włączenie BPDU Filter na porcie, gdzie powstanie pętla, całkowicie uniemożliwia działanie STP i gwarantuje burzę rozgłoszeniową.
  • Ostrzeżenie inżynierskie: Mechanizm BPDU Filter nakazuje przełącznikowi całkowite zaprzestanie wysyłania oraz ignorowanie odbieranych ramek BPDU na danym porcie. Włączenie tej funkcji na porcie brzegowym pozbawia sieć ochrony protokołu STP - przypadkowe połączenie dwóch portów kablem lub wpięcie przełącznika biurkowego doprowadza do natychmiastowej, niszczącej burzy rozgłoszeniowej (Broadcast Storm). W praktyce kampusowej zaleca się bezwzględne stosowanie mechanizmu BPDU Guard zamiast BPDU Filter.
  • Właściwe zastosowanie: wyłącznie na dedykowanych łączach między niezależnymi organizacjami lub do celów laboratoryjnych pod ścisłą kontrolą.
  • Mechanizm Errdisable Recovery: automatyczne przywracanie portów wyłączonych przez mechanizmy ochronne po zadanym czasie (np. po 300 sekundach) z logowaniem zdarzenia.
Ostrzeżenie inżynierskie: Mechanizm BPDU Filter nakazuje przełącznikowi zaprzestanie wysyłania i odbierania ramek BPDU. Włączenie go na porcie dostępowym pozbawia sieć ochrony STP i przy pętli wywołuje katastrofalną burzę rozgłoszeniową; zaleca się bezwzględne stosowanie mechanizmu BPDU Guard.
Ilustracja techniczna do slajdu 25: Mechanizm BPDU Filter oraz ochrona przed błędną konfiguracją

Wokół mechanizmu BPDU Filter narosło wiele nieporozumień inżynierskich. Włączenie tej funkcji nakazuje przełącznikowi całkowite zignorowanie protokołu STP - port przestaje wysyłać i odrzuca wszelkie odbierane ramki BPDU.

Zastosowanie BPDU Filter na porcie dostępowym pozbawia sieć jakiejkolwiek ochrony: przypadkowe spięcie dwóch gniazdek kablem krosowym doprowadza do natychmiastowej, niszczącej burzy rozgłoszeniowej. Zgodnie z najlepszymi praktykami inżynierskimi na brzegu sieci należy bezwzględnie stosować BPDU Guard, a stosowanie BPDU Filter jest całkowicie zakazane.

Niewłaściwe użycie mechanizmu BPDU Filter stanowi jedno z największych zagrożeń konfiguracji sieciowej. Zastosowanie tej funkcji na porcie magistralnym powoduje całkowite zaprzestanie wysyłania i odbierania ramek BPDU, co de facto wyłącza działanie protokołu STP na danym interfejsie. Jeśli po obu stronach takiego łącza istnieje fizyczna pętla, powstanie burzy rozgłoszeniowej następuje natychmiastowo i bez ostrzeżenia.

Skróty użyte w tym slajdzie:
BPDU Filter - Filtr ramek BPDU, Funkcja blokująca wysyłanie i odbiór BPDU, stwarzająca krytyczne ryzyko pętli przy błędnej konfiguracji.
Broadcast Storm - Burza rozgłoszeniowa, Bezpośredni skutek omyłkowego wpięcia pętli w port z aktywną funkcją BPDU Filter.
Safe Config - Bezpieczna konfiguracja, Zalecenie inżynierskie unikania BPDU Filter na rzecz BPDU Guard w środowiskach kampusowych.

26/54

Ograniczenia protokołów Spanning Tree w nowoczesnych szkieletach

Dlaczego współczesne projekty dążą do eliminacji STP ze szkieletu sieci.

Wykład 4: Ograniczenia protokołów Spanning Tree w nowoczesnych szkieletach

  • Złożoność diagnostyczna: w dużych sieciach kampusowych stany zbieżności STP przy częstych zmianach topologii bywają trudne do przewidzenia.
  • Marnowanie zasobów: zablokowane porty to niewykorzystane gigabity pasma optycznego.
  • Ryzyko błędu ludzkiego: jedna błędna komenda może wywołać przeliczenie topologii w całym kampusie.
  • Nowoczesny trend projektowy: Spanning Tree pozostawiony wyłącznie jako pasywny bezpiecznik (safety net) w warstwie dostępu, a w dystrybucji i rdzeniu zastąpiony technologiami agregacji wielourządzeniowej i routingiem L3.
W nowoczesnych sieciach kampusowych dąży się do eliminacji STP w rdzeniu na rzecz agregacji wielourządzeniowej (MCEC) lub routingu L3, ponieważ blokowanie portów fizycznych marnotrawi 50% zainstalowanego pasma magistral światłowodowych.
Ilustracja techniczna do slajdu 26: Ograniczenia protokołów Spanning Tree w nowoczesnych szkieletach

Mimo wprowadzenia standardów RSTP i MSTP, technologie drzewa rozpinającego posiadają wady nie do pogodzenia z wymaganiami nowoczesnych kampusów: blokowanie łączy, długie ścieżki transmisyjne oraz podatność na błędy ludzkie w konfiguracji parametrów drzewa.

Z tego względu współczesna inżynieria dąży do budowy sieci całkowicie wolnych od protokołu STP w szkieletach. Osiąga się to poprzez wdrożenie wielourządzeniowej agregacji łączy (M-LAG / vPC) oraz sprowadzenie routingu warstwy 3 bezpośrednio do przełączników warstwy dostępu.

Współczesne centra danych i szkielety kampusowe odchodzą od klasycznych protokołów Spanning Tree na rzecz topologii routowanych warstwy 3 lub agregacji wielourządzeniowej. Blokowanie 50 procent dostępnych łączy światłowodowych przez algorytm STP jest nieefektywne ekonomicznie, a czas konwergencji rzędu kilkuset milisekund nie spełnia współczesnych wymagań ciągłości transmisji aplikacji chmurowych.

Skróty użyte w tym slajdzie:
Blocked Link - Zablokowane łącze, Fizyczny trakt transmisyjny wyłączony z ruchu przez STP, generujący straty w paśmie szkieletu.
Fabric - Nowoczesna sieć szkieletowa, Architektura eliminująca zależność od STP na rzecz routingu L3 lub agregacji wielourządzeniowej.
Convergence Delay - Opóźnienie konwergencji, Ryzyko chwilowego gubienia pakietów podczas przeliczania topologii przez drzewo rozpinające.

27/54

Alternatywa dla STP: agregacja łączy (Link Aggregation) i standard IEEE 802.1AX

Łączenie wielu fizycznych kabli w jeden logiczny kanał transmisyjny.

Wykład 4: Alternatywa dla STP: agregacja łączy (Link Aggregation) i standard IEEE 802.1AX

  • Standard IEEE 802.1AX-2020 (wcześniej znany jako IEEE 802.3ad).
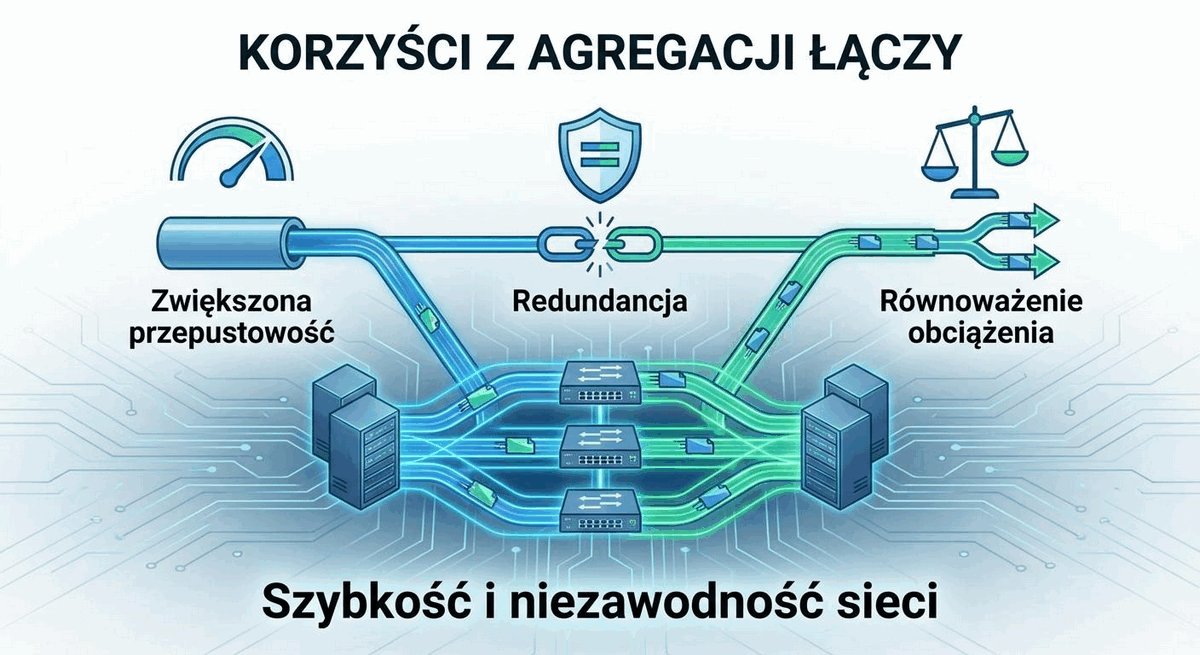
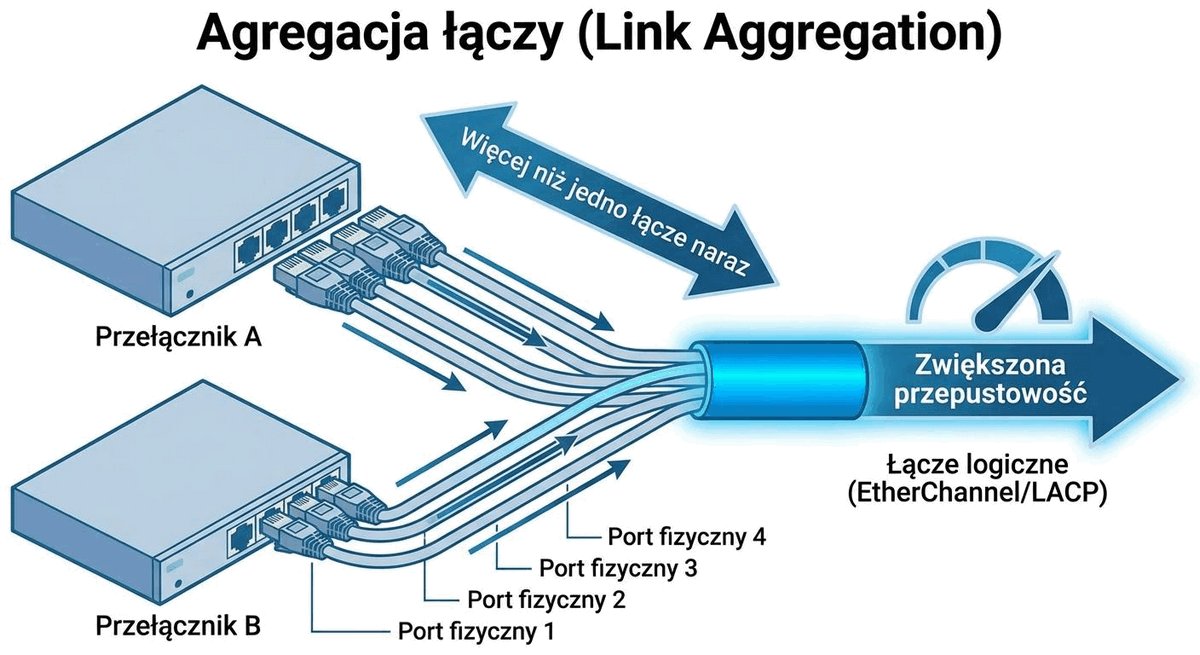
  • Pojęcie agregacji (Link Aggregation / Port-Channel / LAG / EtherChannel): połączenie od 2 do 8 równoległych łączy fizycznych w jeden logiczny interfejs transmisyjny.
  • Korzyści: sumowanie pasma (np. 4 x 10 Gb/s daje wirtualne łącze 40 Gb/s) oraz natychmiastowa redundancja sprzętowa.
  • Spanning Tree widzi całą wiązkę jako jeden port: brak blokowania któregokolwiek z kabli składowych.
  • Uszkodzenie jednego kabla w wiązce zmniejsza jedynie pasmo logiczne, ale nie wywołuje przeliczenia drzewa STP.
Agregacja łączy (LAG / EtherChannel według IEEE 802.1AX) łączy do 8 równoległych portów fizycznych w jeden interfejs logiczny o zwielokrotnionej przepustowości, eliminując blokowanie portów przez STP i tworząc topologię bezpętlową.
Ilustracja techniczna do slajdu 27: Alternatywa dla STP: agregacja łączy (Link Aggregation) i standard IEEE 802.1AX

Agregacja łączy (Link Aggregation), ustandaryzowana w normie IEEE 802.1AX (dawniej IEEE 802.3ad), polega na połączeniu od 2 do 8 równoległych fizycznych traktów Ethernet w jeden logiczny interfejs wiązki (Port-Channel / LAG).

Z punktu widzenia protokołów wyższych warstw (w tym protokołu STP) wiązka zagregowana widziana jest jako pojedyncze łącze transmisyjne o sumarycznej przepustowości równej sumie łączy składowych. Eliminuje to konieczność blokowania któregokolwiek z portów fizycznych.

Standard IEEE 802.1AX (dawniej 802.3ad) definiuje reguły łączenia od 2 do 8 fizycznych interfejsów Ethernet w jeden logiczny kanał transmisyjny (Link Aggregation Group - LAG). Rozwiązanie to pozwala na zwielokrotnienie przepustowości między przełącznikami oraz zapewnia pełną redundancję: awaria pojedynczego kabla powoduje natychmiastowe usunięcie go z wiązki w czasie poniżej 1 milisekundy bez udziału protokołu STP.

Skróty użyte w tym slajdzie:
LAG - Link Aggregation Group, Logiczna wiązka łącząca fizyczne porty Ethernet w jeden interfejs o zwielokrotnionej przepustowości.
IEEE 802.1AX - Standard agregacji łączy, Aktualny międzynarodowy standard definiujący agregację traktów (dawniej IEEE 802.3ad).
Loop-Free - Topologia bezpętlowa, Układ sieci pozbawiony pętli L2 dzięki traktowaniu wielu kabli jako jednego logicznego łącza.

28/54

Protokół LACP (Link Aggregation Control Protocol)

Automatyczna, bezpieczna negocjacja wiązek agregowanych.

Wykład 4: Protokół LACP (Link Aggregation Control Protocol)

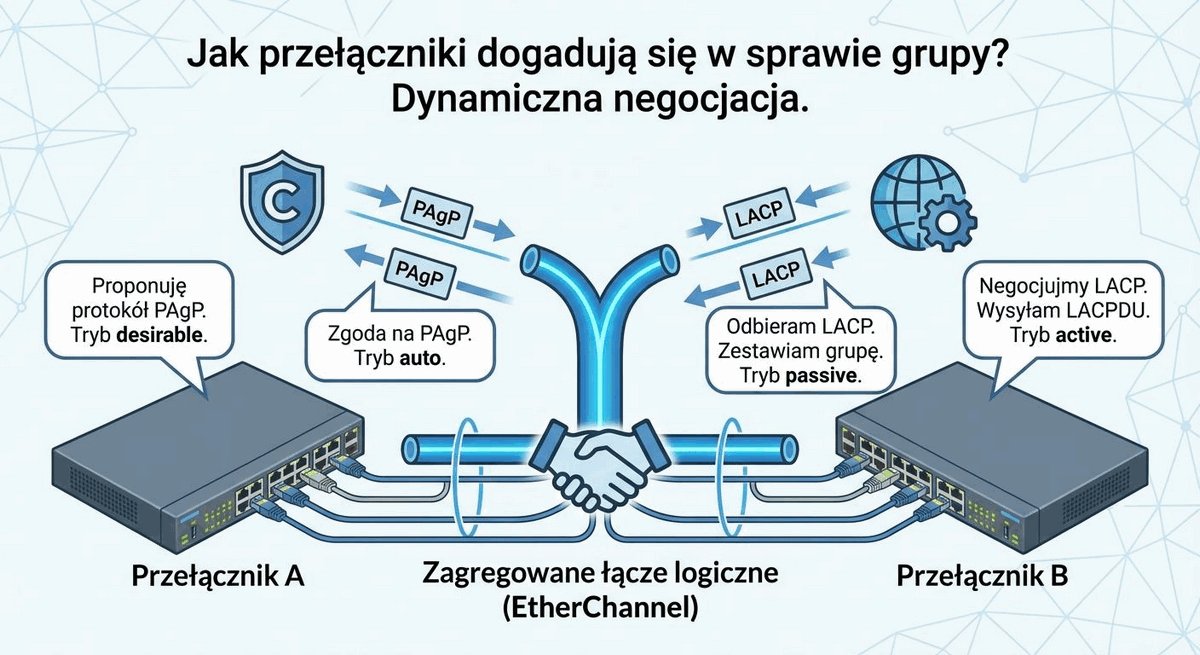
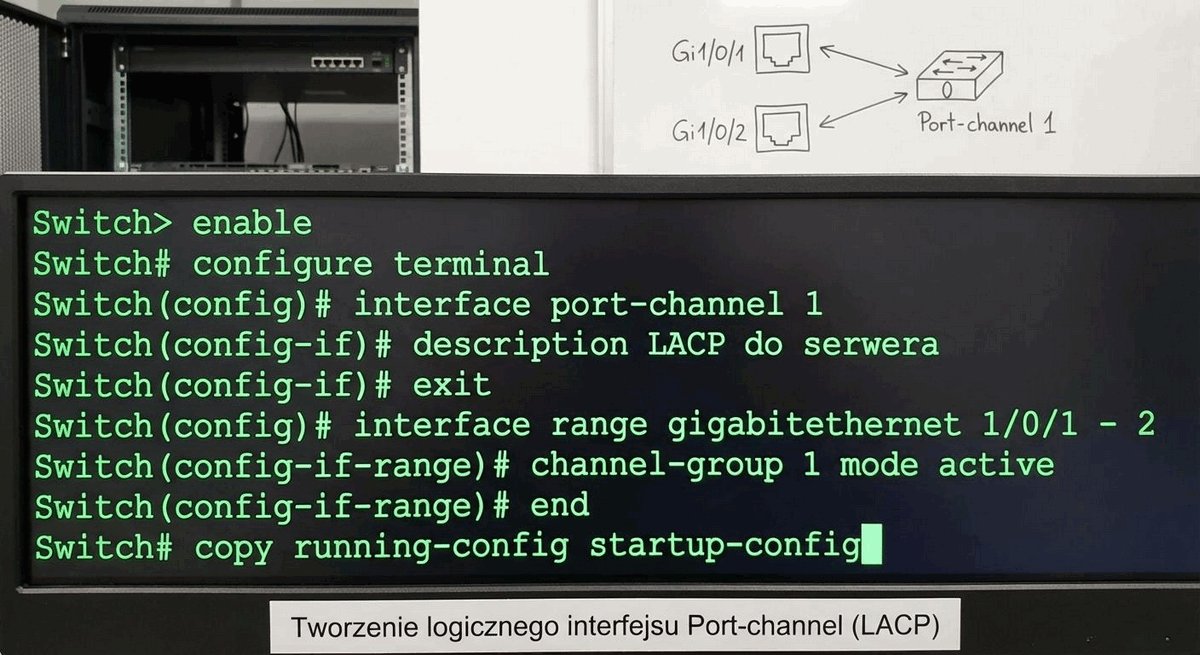
  • Tryby pracy portów w agregacji: tryb statyczny (On - bez negocjacji) a tryb dynamiczny LACP (Active / Passive).
  • Niebezpieczeństwo trybu statycznego: w przypadku awarii po jednej stronie kabel może utknąć w stanie czarnej dziury pakietowej.
  • Protokół LACP: urządzenia wymieniają ramki LACPDU w celu weryfikacji tożsamości partnera, parametrów prędkości, dupleksu i kompatybilności VLAN.
  • Tryb Active: przełącznik aktywnie wysyła ramki LACPDU i inicjuje zestawienie kanału; tryb Passive: przełącznik nasłuchuje.
  • Rekomendacja inżynierska: zawsze konfigurować LACP w trybie Active-Active.
Link Aggregation Control Protocol (LACP) to standardowy protokół dynamicznej negocjacji wiązek agregowanych; poprzez cykliczną wymianę ramek LACPDU weryfikuje spójność parametrów portów składowych (prędkość, dupleks, VLAN) i monitoruje ich integralność.
Ilustracja techniczna do slajdu 28: Protokół LACP (Link Aggregation Control Protocol)

Do bezpiecznego zestawiania wiązek zagregowanych służy protokół LACP (Link Aggregation Control Protocol). Przełączniki stale wymieniają ramki LACPDU, weryfikując tożsamość sąsiada, parametry szybkości, dupleksu oraz zgodność konfiguracji portów po obu stronach.

Zaleca się konfigurację LACP w trybie aktywnym (lacp mode active). W przypadku fizycznego uszkodzenia pojedynczego włókna światłowodowego protokół LACP w ułamku sekundy usuwa uszkodzone łącze z wiązki, a ruch jest natychmiast i bezstratnie kierowany na pozostałe łącza składowe.

Wymiana pakietów LACPDU (Link Aggregation Control Protocol Data Unit) z domyślnym interwałem 1 sekundy (tryb Fast Periodic) pozwala na natychmiastowe wykrycie asymetrycznych uszkodzeń toru transmisyjnego lub zawieszenia portu przełącznika. W przeciwieństwie do statycznej agregacji (Mode On), w której błąd konfiguracji na jednym końcu wiązki natychmiast tworzy pętlę warstwy 2 lub czarną dziurę pakietową, protokół LACP automatycznie blokuje niespójne porty, chroniąc integralność sieci.

Standard LACP (IEEE 802.1AX) rozróżnia stany portów za pomocą 8-bitowego pola stanu (State Field) w pakietach LACPDU, obejmującego m.in. flagi Activity, Timeout, Aggregation, Synchronization, Collecting, Distributing, Defaulted oraz Expired. Dopiero gdy porty po obu stronach łącza osiągną stan Collecting i Distributing, interfejs zostaje włączony do aktywnego przekazywania ruchu użytkowników, co w 100 procentach wyklucza sytuacje, w których jedna strona transmituje pakiety, a druga je odrzuca.

Skróty użyte w tym slajdzie:
LACP - Link Aggregation Control Protocol, Protokół automatycznego zestawiania i weryfikacji integralności wiązki zagregowanej.
LACPDU - Link Aggregation Control Protocol Data Unit, Ramka sterująca przesyłana co 1 s (Fast) lub 30 s (Slow) w celu kontroli stanu połączeń fizycznych.
Active/Passive - Tryby pracy LACP, Tryb aktywny wymusza inicjację negocjacji wiązki, tryb pasywny oczekuje na pakiety LACP sąsiada.
29/54

Algorytmy równoważenia ruchu w wiązkach LACP

Mechanizm dystrybucji pakietów na fizyczne łącza składowe.

Wykład 4: Algorytmy równoważenia ruchu w wiązkach LACP

  • Zasada podstawowa: pakiety należące do jednego przepływu (sesji) muszą zawsze podróżować tym samym fizycznym kablem, aby uniknąć zmiany kolejności pakietów (Out-of-Order Delivery).
  • Funkcja haszująca (Hash Function): obliczanie indeksu kabla wyjściowego na podstawie pól nagłówka pakietu.
  • Opcje haszowania: na podstawie MAC źródła/celu (L2), na podstawie IP źródła/celu (L3) lub na podstawie IP i portów TCP/UDP (L4).
  • Ograniczenia algorytmu haszowania: Algorytmy równoważenia obciążenia w LACP bazują na funkcji skrótu liczonej z nagłówków warstw L2/L3/L4 (Source/Destination MAC, IP oraz porty TCP/UDP). Ponieważ pakiety należące do tej samej sesji muszą być przesyłane tym samym łączem fizycznym w celu zachowania kolejności dostarczania, maksymalna przepustowość pojedynczego transferu jest zawsze ograniczona do prędkości pojedynczego łącza fizycznego w wiązce (np. transfer pojedynczego pliku kopii zapasowej przez wiązkę 4x10 Gb/s osiągnie maksymalnie 10 Gb/s).
  • Optymalizacja dla kampusu: wybór algorytmu haszującego L3+L4 zapewnia równomierne rozłożenie tysięcy różnych sesji internetowych na wszystkie kable wiązki.
Algorytmy haszowania LACP rozkładają ruch na łącza składowe na podstawie sumy skrótu nagłówków L2/L3/L4; ponieważ pakiety pojedynczego przepływu muszą podróżować tym samym łączem fizycznym, przepustowość pojedynczej sesji jest zawsze ograniczona do prędkości jednego łącza.
Ilustracja techniczna do slajdu 29: Algorytmy równoważenia ruchu w wiązkach LACP

Równoważenie obciążenia w wiązkach LACP realizowane jest sprzętowo w oparciu o algorytmy haszujące analizujące pola nagłówków pakietów (Source/Destination MAC, Source/Destination IP oraz numery portów TCP/UDP warstwy 4).

Kluczowym faktem inżynierskim jest to, że pakiety należące do tej samej sesji (strumienia) muszą być przesyłane tym samym fizycznym łączem w celu zachowania kolejności dostarczania. W rezultacie maksymalna prędkość pojedynczego transferu (np. pobierania pliku) nigdy nie przekroczy przepustowości pojedynczego łącza w wiązce (np. 10 Gb/s w wiązce 4x10 Gb/s).

Wybór funkcji haszującej w przełącznikach dystrybucyjnych determinuje stopień utylizacji poszczególnych łączy w wiązce. Zastosowanie prostego haszowania opartego wyłącznie na adresach MAC (Source/Destination MAC) w sieci kampusowej, w której cały ruch kierowany jest do pojedynczego routera brzegowego o stałym adresie MAC, skutkuje skierowaniem 100 procent ruchu na jedno fizyczne łącze. Dlatego bezwzględnym standardem konfiguracyjnym jest haszowanie 5-krotkowe analizujące adresy IP oraz porty warstwy czwartej (TCP/UDP).

Skróty użyte w tym slajdzie:
Hashing - Funkcja skrótu, Algorytm matematyczny przydzielający pakiety danej sesji do konkretnego łącza fizycznego w wiązce LAG.
L4 Hash - Haszowanie warstwy 4, Równoważenie ruchu oparte na adresach IP oraz numerach portów TCP/UDP zapewniające optymalną dystrybucję sesji.
Per-Flow - Podział na przepływy, Zasada gwarantująca, że wszystkie pakiety danej sesji przesyłane są tym samym portem w celu zachowania kolejności.

30/54

Agregacja wielourządzeniowa (Multi-Chassis EtherChannel - MCEC)

Przełamanie ograniczenia pojedynczego przełącznika fizycznego.

Wykład 4: Agregacja wielourządzeniowa (Multi-Chassis EtherChannel - MCEC)

  • Ograniczenie tradycyjnego LACP: oba końce wiązki kablowej muszą być wpięte do tego samego fizycznego przełącznika.
  • Koncepcja MCEC / MLAG: możliwość podłączenia jednego przełącznika dostępowego wiązką LACP do dwóch różnych, niezależnych przełączników dystrybucyjnych.
  • Wymóg technologiczny: przełączniki nadrzędne muszą komunikować się ze sobą i prezentować się przełącznikowi podrzędnemu jako jedno urządzenie logiczne.
  • Rezultat: pełna odporność na awarię przełącznika dystrybucyjnego połączona z pełnym wykorzystaniem pasma obu łączy (brak portów zablokowanych przez STP).
Multi-Chassis EtherChannel (MCEC, technologie vPC, VSS, MLAG) pozwala na podłączenie wiązki agregowanej do dwóch niezależnych fizycznie przełączników szkieletowych prezentujących się jako jeden węzeł L2, eliminując potrzebę blokowania portów przez STP.
Ilustracja techniczna do slajdu 30: Agregacja wielourządzeniowa (Multi-Chassis EtherChannel - MCEC)

Klasyczny standard LACP wymaga, aby wszystkie łącza składowe wiązki były podłączone do tego samego fizycznego przełącznika. Stanowi to poważny SPOF: awaria przełącznika powoduje załamanie całej wiązki.

Rozwiązaniem jest agregacja wielourządzeniowa (Multi-Chassis EtherChannel - MCEC, znana jako Cisco vPC, VSS lub uniwersalny standard M-LAG). Pozwala ona na zestawienie wiązki LACP rozpiętej pomiędzy dwoma niezależnymi fizycznymi przełącznikami rdzeniowymi, zapewniając pełną redundancję urządzeń i łączy.

Zastosowanie agregacji wielourządzeniowej eliminuje dylemat inżynierski polegający na konieczności wyboru między nadmiarowością a pełnym wykorzystaniem pasma. Dzięki zestawieniu łącza synchronizacyjnego (Inter-Switch Link / Peer-Link) dwa fizyczne przełączniki wymieniają stany tablic przekazywania i prezentują się dla urządzeń dostępowych jako pojedynczy logiczny węzeł LACP, co pozwala na bezpieczne zlikwidowanie blokowanych portów STP.

W architekturze agregacji wielourządzeniowej (np. Cisco vPC) dwa przełączniki nadrzędne wymieniają między sobą informacje sterujące za pośrednictwem dedykowanego łącza pomocniczego (Peer-Keepalive Link) oraz łącza transmisyjnego (Peer-Link). Niezwykle istotnym mechanizmem jest zasada ochrony przed pętlami (vPC Loop Avoidance Rule), która zabrania przełącznikowi przekazywania pakietów odebranych przez Peer-Link na dowolny port vPC, co zapobiega powstawaniu pętli w warstwie 2 bez udziału blokowania portów STP.

Skróty użyte w tym slajdzie:
MCEC - Multi-Chassis EtherChannel, Technologia agregacji łączy fizycznych rozproszonych pomiędzy dwoma niezależnymi przełącznikami.
MLAG - Multi-Chassis Link Aggregation, Otwarty standard branżowy eliminujący konieczność blokowania portów przez protokół Spanning Tree.
vPC - Virtual Port Channel, Implementacja agregacji wielourządzeniowej w przełącznikach centrum danych Cisco Nexus.

31/54

Technologie łączenia przełączników w stosy (Stacking)

Fizyczna integracja urządzeń dostępowych z wykorzystaniem dedykowanych magistral stosowych.

Wykład 4: Technologie łączenia przełączników w stosy (Stacking)

  • Idea Switch Stacking: połączenie od 2 do 8 przełączników specjalnymi kablami szkieletowymi (Stack Cables) w pierścień o przepustowości setek Gb/s.
  • Wspólna płaszczyzna sterowania (Single Control Plane): jeden przełącznik pełni rolę Master/Active, pozostałe są członkami (Members).
  • Jeden adres IP zarządzania, jedna konfiguracja, jedna tablica przełączania.
  • Możliwość tworzenia wiązek LACP rozproszonych na różne przełączniki w stosie (Cross-Stack EtherChannel).
  • Zastosowanie: szafy IDF na piętrach budynków.
Stos przełączników (Switch Stack) integruje fizyczne jednostki dostępowe w jeden węzeł zarządzany wspólną płaszczyzną kontrolną przez dedykowane magistrale stosowe, co upraszcza administrację i umożliwia tworzenie rozproszonych wiązek EtherChannel.
Ilustracja techniczna do slajdu 31: Technologie łączenia przełączników w stosy (Stacking)

W warstwie dostępu powszechnie stosowaną technologią eliminacji punktów awarii jest fizyczne łączenie przełączników w stosy (np. Cisco StackWise). Grupa od 2 do 8 przełączników łączy się za pomocą specjalnych magistral o przepustowości kilkuset gigabitów na sekundę.

Stos funkcjonuje jako jedno logiczne urządzenie sieciowe z pojedynczym adresem IP do zarządzania i wspólną tablicą przełączania. W przypadku awarii przełącznika nadrzędnego (Master) rolę przejmuje przełącznik zapasowy bez przerywania przekazywania ramek na pozostałych modułach.

Łączenie przełączników w stos za pomocą dedykowanych magistral sprzętowych zapewnia nie tylko redundancyjne zarządzanie, lecz także deterministyczną przepustowość wewnętrzną rzędu 480 Gb/s lub więcej. Architektura ta pozwala na tworzenie rozproszonych wiązek EtherChannel (Cross-Stack EtherChannel), w których poszczególne łącza podłączone są do różnych jednostek w stosie, gwarantując ciągłość transmisji nawet przy nagłej awarii zasilania jednego z przełączników.

Skróty użyte w tym slajdzie:
Stacking - Łączenie w stos, Fizyczne połączenie wielu przełączników za pomocą dedykowanych kabli szkieletowych w jeden logiczny system.
StackWise - Technologia stosu Cisco, Własnościowa magistrala pierścieniowa o przepustowości 160-480 Gb/s zarządzana przez jeden adres IP.
Single Management - Jednolity punkt zarządzania, Możliwość administrowania całym stosem przełączników przez pojedynczą sesję SSH i jeden plik konfiguracyjny.

32/54

Wirtualizacja przełączników w rdzeniu i dystrybucji

Implementacje technologii multichassis u wiodących producentów.

Wykład 4: Wirtualizacja przełączników w rdzeniu i dystrybucji

  • Technologia Cisco VSS (Virtual Switching System) oraz StackWise Virtual: połączenie dwóch wielkich przełączników rdzeniowych w jedną jednostkę wirtualną przez łącza optyczne 40G/100G (Virtual Switch Link).
  • Technologia Cisco vPC (Virtual Port Channel): wirtualizacja w płaszczyźnie danych przy zachowaniu niezależnych płaszczyzn sterowania (stosowana powszechnie w centrach danych).
  • Standardy Arista MLAG, HPE/Aruba VSX, Juniper Virtual Chassis.
  • Osiągnięcie architektury Loop-Free: eliminacja STP na styku dostęp-dystrybucja, natychmiastowe przełączenie ruchu poniżej 50 ms w razie awarii przełącznika.
Wirtualizacja systemów przełączających (np. Virtual Switching System, Cisco StackWise-Virtual) łączy parę przełączników dystrybucyjnych lub rdzeniowych w jeden logiczny węzeł z jednolitym adresem IP, wspólną tablicą routingu i mechanizmem Stateful Switchover (SSO).
Ilustracja techniczna do slajdu 32: Wirtualizacja przełączników w rdzeniu i dystrybucji

Wirtualizacja urządzeń w warstwach dystrybucji i rdzenia (Cisco VSS, vPC lub klastry HP IRF) pozwala na logiczne połączenie dwóch potężnych przełączników chassisowych w jedną wirtualną całość. Płaszczyzna sterowania synchronizuje stany w czasie rzeczywistym.

Umożliwia to podłączenie przełączników dostępowych za pomocą wiązek Port-Channel z rozplotem do obu węzłów wirtualnego rdzenia. Topologia sieci staje się całkowicie płaska i odporna na pętle w warstwie 2, bez konieczności jakiejkolwiek interwencji protokołów Spanning Tree.

Wirtualizacja węzłów w warstwie dystrybucji i rdzenia przekształca klasyczną, podatną na błędy pętlę trójkątną w logiczną topologię typu punkt-punkt. Brak konieczności negocjacji stanów blokowania STP sprawia, że cały proces przełączania pakietów odbywa się ze sprzętową prędkością układów ASIC, a czas rekonfiguracji po awarii pojedynczego węzła ogranicza się do czasu usunięcia łącza z tablicy CEF (Cisco Express Forwarding).

Skróty użyte w tym slajdzie:
VSS - Virtual Switching System, Wirtualizacja pary przełączników modułowych w jeden wirtualny węzeł komutacyjny.
StackWise Virtual - Wirtualny stos szkieletowy, Nowoczesna technologia wirtualizacji przełączników Catalyst serii 9000 bez dedykowanych kabli stosowych.
Dual-Active Detection - Detekcja podwójnego stanu aktywnego, Mechanizm chroniący przed sytuacją Split-Brain w przypadku zerwania łącz wirtualizacji.

33/54

Budowa topologii bezblokadowej typu Loop-Free

Wzorzec projektowy nowoczesnej sieci kampusowej.

Wykład 4: Budowa topologii bezblokadowej typu Loop-Free

  • Zestawienie przełączników dostępowych w stosy (Stack).
  • Zestawienie przełączników dystrybucyjnych w parę wirtualną (MCEC / MLAG / StackWise Virtual).
  • Połączenie dostępu z dystrybucją wiązką dwóch łączy LACP (jedno do przełącznika dystrybucyjnego A, drugie do przełącznika B).
  • Brak jakichkolwiek zablokowanych portów: 100% pasma pracuje w trybie Active-Active.
  • Brak ryzyka powstawania pętli w warstwie 2; protokół RSTP/MSTP pozostaje włączony w tle jako zabezpieczenie na wypadek błędnego spięcia portów krosowych.
Topologia bezblokadowa (Loop-Free Topology) to projekt architektury kampusowej, w którym eliminacja pętli w warstwie 2 następuje poprzez agregację łączy do wirtualnych węzłów lub terminacji VLAN na poziomie dystrybucji, gwarantując 100% wykorzystania łączy transmisyjnych.
Ilustracja techniczna do slajdu 33: Budowa topologii bezblokadowej typu Loop-Free

Budowa topologii bezblokadowej (Loop-Free Topology) to zaawansowany wzorzec nowoczesnej inżynierii warstwy 2. Dzięki zastosowaniu łączenia przełączników w stosy w warstwie dostępu oraz agregacji wielourządzeniowej M-LAG w dystrybucji sieć uzyskuje układ podwójnej gwiazdy.

Żaden port transmisyjny nie znajduje się w stanie blokowania STP - wszystkie łącza pracują z pełną wydajnością w trybie Active/Active. Czas reakcji na awarię pojedynczego kabla lub całego przełącznika dystrybucyjnego wynosi poniżej 50 ms; mechanizm polega na sprzętowym przekierowaniu ruchu z wykorzystaniem funkcji skrótu LACP.

Wzorzec architektury Loop-Free eliminuje ryzyko burz rozgłoszeniowych już na poziomie samej topologii sieci. W takim układzie protokół Spanning Tree (MSTP/RSTP) pozostaje włączony na wszystkich przełącznikach wyłącznie jako mechanizm zabezpieczający (Failsafe Mechanism) na wypadek pomyłkowego spięcia portów kablem krosowym przez technika, nie ingerując w codzienny transfer danych użytkowników.

Skróty użyte w tym slajdzie:
Non-blocking - Architektura bezblokadowa, Topologia sieci, w której wszystkie fizyczne łącza transmisyjne aktywnie przesyłają pakiety.
MEC - Multi-Chassis EtherChannel, Zastosowanie wiązek MEC pomiędzy warstwą dostępu a dystrybucją eliminujące potrzebę blokowania portów przez STP.
Bandwidth Utilization - Utylizacja pasma, Osiągnięcie 100% wykorzystania zakupionych przepustowości traktów światłowodowych.

34/54

Redundancja pierwszej bramy domyślnej (FHRP)

Problem pojedynczego punktu awarii w adresacji stacji roboczych.

Wykład 4: Redundancja pierwszej bramy domyślnej (FHRP)

  • Konfiguracja hosta: każda stacja robocza w sieci posiada skonfigurowany jeden adres IP bramy domyślnej (Default Gateway).
  • Problem awarii: jeśli router lub przełącznik L3 pełniący rolę bramy ulegnie awarii, stacja traci łączność ze światem zewnętrznym i innymi podsieciami, mimo że w budynku istnieje drugi, sprawny przełącznik dystrybucyjny.
  • Rozwiązanie: rodzina protokołów First Hop Redundancy Protocols (FHRP).
  • Wirtualna brama: stacje robocze otrzymują adres IP wirtualnego routera, który jest dynamicznie obsługiwany przez jeden z fizycznych przełączników.
Protokoły FHRP (First Hop Redundancy Protocols) zapewniają automatyczną redundancję bramy domyślnej dla stacji roboczych poprzez współdzielenie wirtualnego adresu IP i wirtualnego adresu MAC pomiędzy co najmniej dwoma routerami lub przełącznikami warstwy 3.
Ilustracja techniczna do slajdu 34: Redundancja pierwszej bramy domyślnej (FHRP)

Większość stacji roboczych i urządzeń końcowych posiada w swojej konfiguracji sieciowej wpisany wyłącznie jeden adres IP bramy domyślnej (Default Gateway). Awaria routera lub interfejsu SVI pełniącego tę rolę odcina stacje od reszty kampusu i Internetu.

Do rozwiązania tego problemu służy rodzina protokołów redundancji pierwszej bramy FHRP (First Hop Redundancy Protocols). Pozwalają one na logiczne współdzielenie wirtualnego adresu IP oraz wirtualnego adresu MAC bramy przez dwa lub więcej fizycznych routerów.

Brak redundancji bramy domyślnej sprawia, że nawet najbardziej zaawansowane mechanizmy dublowania łączy światłowodowych i zasilaczy stają się bezużyteczne w momencie awarii fizycznego interfejsu L3 routera. Protokoły FHRP wprowadzają wirtualny adres IP oraz wirtualny adres MAC, które wędrują dynamicznie między routerami w klastrze, zapewniając stacjom roboczym stały i niezawodny punkt wyjścia do szkieletu uczelni i Internetu.

Skróty użyte w tym slajdzie:
FHRP - First Hop Redundancy Protocol, Grupa protokołów zapewniających bezprzerwowe przekierowanie ruchu stacji w przypadku awarii routera domyślnego.
Default Gateway - Brama domyślna, Adres IP interfejsu L3 wpisany w konfiguracji stacji roboczej do komunikacji poza lokalną podsieć.
VIP - Virtual IP Address, Współdzielony wirtualny adres IP bramy przypisany do grupy redundancji.

35/54

Protokół Hot Standby Router Protocol (HSRP)

Własnościowy protokół redundancji bramy stworzony przez Cisco.

Wykład 4: Protokół Hot Standby Router Protocol (HSRP)

  • Zasada działania HSRP: dwa lub więcej routerów tworzy wspólną grupę HSRP (Standby Group).
  • Router Active: przetwarza ruch kierowany na wirtualny adres IP i wirtualny adres MAC (np. 0000.0c07.acXX dla HSRPv1 oraz 0000.0c9f.fXXX dla HSRPv2).
  • Router Standby: monitoruje obecność routera aktywnego za pomocą komunikatów Hello (domyślnie co 3 sekundy).
  • Przejęcie roli (Failover): jeśli router Standby nie odbierze komunikatu przez czas Dead Interval (10 sekund), natychmiast przejmuje rolę Active i wirtualny MAC.
  • Funkcja Preemption: wymuszenie powrotu roli Active do routera nadrzędnego po jego restarcie.
  • Integracja z protokołem BFD (Bidirectional Forwarding Detection, RFC 5880): skrócenie czasu detekcji awarii łącza lub routera z sekund do kilkudziesięciu milisekund (<50 ms).
Protokół Cisco HSRP (RFC 2281) działa w układzie Active/Standby z wirtualnym adresem MAC 0000.0c07.acXX (HSRPv1) lub 0000.0c9f.fXXX (HSRPv2), a integracja z protokołem BFD pozwala na skrócenie czasu przełączenia poniżej 50 ms.
Ilustracja techniczna do slajdu 35: Protokół Hot Standby Router Protocol (HSRP)

Protokół HSRP (Hot Standby Router Protocol) to własnościowe rozwiązanie firmy Cisco pracujące w układzie Active/Standby. Router aktywny odpowiada na zapytania ARP dla adresu wirtualnego i przesyła pakiety, podczas gdy router zapasowy nasłuchuje pakietów Hello.

W nowoczesnych sieciach stosuje się wyłącznie wersję HSRPv2, która obsługuje adresację IPv6, oferuje timery milisekundowe oraz wykorzystuje wirtualny adres MAC w formacie 0000.0c9f.fXXX (gdzie XXX oznacza numer grupy). Włączenie opcji preemption gwarantuje powrót roli Active do preferowanego routera po jego restarcie.

W protokole HSRPv2 router aktywny odpowiada na zapytania ARP dotyczące wirtualnego adresu IP dedykowanym adresem fizycznym z puli 0000.0C9F.Fxxx (gdzie xxx oznacza numer grupy HSRP). Istotnym elementem projektu jest włączenie mechanizmu wywłaszczania (Preempt) wraz z opóźnieniem czasowym (Preempt Delay), co zapobiega przedwczesnemu przejęciu roli przez router po restarcie, zanim jego tablice routingu OSPF lub BGP osiągną stan pełnej zbieżności.

Skróty użyte w tym slajdzie:
HSRP - Hot Standby Router Protocol, Protokół redundancji bramy firmy Cisco wybierający węzeł aktywny (Active) i rezerwowy (Standby).
HSRPv2 - Druga wersja HSRP, Standard obsługujący numery grup 0-4095, wirtualny adres MAC 0000.0c9f.fXXX oraz adresację IPv6.
Preemption - Funkcja pierwszeństwa, Mechanizm wymuszający przejęcie roli routera aktywnego przez węzeł o wyższym priorytecie po jego powrocie do sprawności.

36/54

Standard otwarty VRRPv3 według RFC 5798

Międzynarodowy, uniwersalny standard redundancji pierwszej bramy.

Wykład 4: Standard otwarty VRRPv3 według RFC 5798

  • Standard IETF RFC 5798: Virtual Router Redundancy Protocol (VRRP) Version 3.
  • Kompatybilność wieloproducentowa: możliwość zestawienia pary przełączników różnych producentów w jedną grupę redundancji.
  • Obsługa protokołów IPv4 oraz IPv6 w ramach jednej wersji protokołu VRRPv3.
  • Role urządzeń: Master Router (przetwarza ruch) oraz Backup Routers.
  • Wirtualny adres MAC: format 00-00-5E-00-01-XX dla IPv4 oraz 00-00-5E-00-02-XX dla IPv6.
  • Domyślne timery: anonsowanie co sekundę (znacznie szybsza reakcja niż domyślny HSRP).
  • Integracja z BFD (RFC 5880): detekcja awarii routera Master poniżej 50 ms.
Virtual Router Redundancy Protocol (VRRPv3, zdefiniowany w IETF RFC 5798) to uniwersalny standard redundancji bramy dla protokołów IPv4 i IPv6 z wirtualnymi adresami MAC 00-00-5E-00-01-XX (IPv4) oraz 00-00-5E-00-02-XX (IPv6).
Ilustracja techniczna do slajdu 36: Standard otwarty VRRPv3 według RFC 5798

Protokół VRRPv3 (Virtual Router Redundancy Protocol version 3), zdefiniowany w standardzie IETF RFC 5798, stanowi otwarty międzynarodowy odpowiednik protokołu HSRP. Wspiera równolegle stosy adresowe IPv4 oraz IPv6, gwarantując pełną interoperacyjność urządzeń różnych producentów.

W protokole VRRPv3 węzeł zarządzający określany jest mianem Master, a węzły zapasowe jako Backup. Standard definiuje wirtualne adresy MAC: 0000.5e00.01XX dla IPv4 oraz 0000.5e00.02XX dla IPv6. Domyślny okres ogłaszania wynosi 1 sekundę, jednak w kampusie konfiguruje się wartości rzędu 100-200 ms.

Standard VRRPv3 jest w pełni neutralny technologicznie, co umożliwia budowę odpornego klastra bramy domyślnej z wykorzystaniem przełączników L3 różnych producentów. Dodatkowo RFC 5798 wprowadza natywną obsługę protokołu IPv6 oraz pozwala na skonfigurowanie interwałów wysyłania ogłoszeń VRRP Advertisement w milisekundach (domyślnie 1 sekunda, z możliwością redukcji do 100 ms), co skraca czas przełączenia w przypadku awarii do wartości niezauważalnych dla użytkowników końcowych.

Warto podkreślić, że RFC 5798 w wersji VRRPv3 wprowadza zunifikowaną strukturę protokołu zdolną do równoległej ochrony ruchu IPv4 oraz IPv6 przy użyciu tego samego formatu komunikatów. Zrezygnowano w niej z mechanizmów uwierzytelniania tekstowego obecnych w starszym VRRPv2, uznając je za nieskuteczne kryptograficznie, a ochronę integralności pakietów sterujących powierzono mechanizmom bezpieczeństwa na poziomie warstwy sieciowej (IPsec AH/ESP) lub fizycznej separacji dedykowanego VLAN-u tranzytowego.

Skróty użyte w tym slajdzie:
VRRP - Virtual Router Redundancy Protocol, Otwarty międzynarodowy standard redundancji routerów zdefiniowany w IETF RFC 5798.
Master - Router główny, Router VRRP aktywnie odpowiadający na zapytania ARP i przekazujący pakiety skierowane na wirtualny adres IP.
Backup - Router zapasowy, Węzeł nasłuchujący komunikatów rozgłoszeniowych Advertisement i przejmujący rolę Mastera po zaniku sygnału.

37/54

Zaawansowany protokół GLBP (Gateway Load Balancing Protocol)

Równoważenie obciążenia na poziomie pierwszej bramy.

Wykład 4: Zaawansowany protokół GLBP (Gateway Load Balancing Protocol)

  • Ograniczenie HSRP i VRRP: router zapasowy (Standby/Backup) nie przekazuje pakietów, jego moc obliczeniowa i łącza są niewykorzystane.
  • Idea GLBP: aktywny udział wszystkich routerów w grupie w przekazywaniu ruchu wychodzącego.
  • Jeden wirtualny adres IP, ale wiele wirtualnych adresów MAC (Active Virtual Forwarders - AVF, do 4 routerów).
  • Router nadrzędny (Active Virtual Gateway - AVG) odpowiada na zapytania ARP stacji roboczych, przydzielając im różne wirtualne adresy MAC w trybie Round-Robin.
  • Format adresów MAC: 0007.b400.XXYY (gdzie XX to numer grupy GLBP, a YY to numer forwardera AVF) oraz integracja z BFD (RFC 5880) dla sub-sekundowej detekcji.
  • Automatyczne rozłożenie ruchu komputerów w podsieci na kilka fizycznych przełączników L3.
Gateway Load Balancing Protocol (GLBP) realizuje równoważenie obciążenia pierwszej bramy w trybie aktywno-aktywnym; router AVG przydziela stacjom unikalne wirtualne adresy MAC należące do routerów AVF, dynamicznie rozkładając ruch podsieci na wiele fizycznych urządzeń L3.
Ilustracja techniczna do slajdu 37: Zaawansowany protokół GLBP (Gateway Load Balancing Protocol)

Protokół GLBP (Gateway Load Balancing Protocol) firmy Cisco stanowi unikalne rozwinięcie koncepcji FHRP o natywne równoważenie obciążenia bramy. W odróżnieniu od HSRP i VRRP, gdzie pakiety przesyła wyłącznie jeden węzeł, w GLBP ruch jest rozkładany na wszystkie routery w grupie.

Węzeł AVG (Active Virtual Gateway) przydziela stacjom unikalne wirtualne adresy MAC bramy w odpowiedzi na zapytania ARP, wyznaczając aktywne węzły przekazujące AVF (Active Virtual Forwarders). Zapewnia to pełną redundancję połączoną z dynamicznym sumowaniem pasma obu routerów.

Przewaga protokołu GLBP nad HSRP i VRRP polega na jednoczesnym wykorzystaniu przepustowości obu routerów dystrybucyjnych bez konieczności sztucznego dzielenia sieci VLAN na grupy. Router AVG (Active Virtual Gateway) steruje ruchem poprzez przydzielanie w odpowiedziach ARP wirtualnych adresów MAC poszczególnych routerów przesyłających AVF (Active Virtual Forwarder), realizując równoważenie obciążenia w algorytmie Round-Robin lub na podstawie wag procentowych.

Skróty użyte w tym slajdzie:
GLBP - Gateway Load Balancing Protocol, Zaawansowany protokół redundancji firmy Cisco łączący ochronę bramy z równoważeniem obciążenia stacji.
AVG - Active Virtual Gateway, Główny router odpowiadający na zapytania ARP klientów różnymi wirtualnymi adresami MAC.
AVF - Active Virtual Forwarder, Router faktycznie przekazujący ruch stacji, której przydzielono jego unikalny wirtualny adres MAC.

38/54

Czasy konwergencji protokołów FHRP i mechanizm śledzenia łączy

Dostrojenie protokołów redundancji do wymagań sieci kampusowej.

Wykład 4: Czasy konwergencji protokołów FHRP i mechanizm śledzenia łączy

  • Optymalizacja timerów (Sub-second Timers): zmiana czasów Hello na 200 ms i Holdtime na 600 ms skraca przerwę przy awarii bramy poniżej sekundy.
  • Problem ślepej bramy: przełącznik dystrybucyjny A działa poprawnie, ale jego łącze szkieletowe do rdzenia zostało przerwane; przełącznik nadal anonsuje się jako aktywna brama i pochłania pakiety użytkowników, nie mogąc ich wysłać dalej.
  • Mechanizm Object Tracking: monitorowanie stanu interfejsu szkieletowego lub trasy w tablicy routingu; w razie utraty połączenia z rdzeniem priorytet VRRP/HSRP jest automatycznie obniżany, co wywołuje natychmiastowe przekazanie roli Active do drugiego przełącznika.
Mechanizm Object Tracking w protokołach FHRP monitoruje stan łączy wyjściowych (Uplink) lub tras routingu, automatycznie obniżając priorytet routera aktywnego w przypadku awarii traktu tranzytowego i wymuszając natychmiastowe przełączenie awaryjne.
Ilustracja techniczna do slajdu 38: Czasy konwergencji protokołów FHRP i mechanizm śledzenia łączy

Kluczowym wyzwaniem w protokołach FHRP jest minimalizacja czasu wykrycia awarii oraz śledzenie stanu łączy zewnętrznych (Object Tracking). Jeżeli router aktywny utraci łączność ze szkieletem nadrzędnym, musi natychmiast zrzec się roli bramy na rzecz routera zapasowego.

Mechanizm Tracking obniża priorytet routera po wykryciu awarii interfejsu uplink. Dodatkowo standardem staje się powiązanie protokołów FHRP z protokołem BFD (Bidirectional Forwarding Detection, RFC 5880), co skraca czas detekcji awarii routera do 30-50 milisekund.

Skorelowanie protokołów FHRP z mechanizmem wykrywania dwukierunkowego przekazywania (Bidirectional Forwarding Detection - BFD) pozwala na skrócenie czasu detekcji awarii łącza do kilkunastu milisekund. Pakiety BFD generowane są bezpośrednio przez wyspecjalizowany mikrokontroler sprzętowy, co gwarantuje natychmiastową reakcję klastra FHRP nawet w sytuacji silnego przeciążenia głównego procesora przełącznika.

Skróty użyte w tym slajdzie:
Object Tracking - Śledzenie obiektów, Mechanizm dynamicznej redukcji priorytetu routera FHRP w przypadku awarii jego łącza nadrzędnego (Uplink).
BFD - Bidirectional Forwarding Detection, Protokół sub-sekundowej detekcji przerw transmisyjnych przyspieszający przełączenie FHRP.
Sub-second Timers - Timery milisekundowe, Konfiguracja czasów Hello i Holddown poniżej 1 sekundy minimalizująca przerwę w transmisji.

39/54

Nadmiarowość urządzeń aktywnych w rdzeniu i dystrybucji

Zasada podwójnych węzłów w punktach koncentracji ruchu.

Wykład 4: Nadmiarowość urządzeń aktywnych w rdzeniu i dystrybucji

  • Wdrożenie symetrycznych par urządzeń we wszystkich kluczowych węzłach.
  • Dwa przełączniki rdzeniowe umieszczone w osobnych szafach rack, a optymalnie w osobnych pomieszczeniach serwerowni (np. serwerownia główna i serwerownia zapasowa kampusu).
  • Niezależne karty sterujące (Dual Supervisor) w przełącznikach modułowych z mechanizmem synchronizacji stanu sesji (Stateful Switchover - SSO).
  • Technologia Non-Stop Routing (NSR): awaria procesora zarządzającego nie przerywa sesji sąsiedztwa w protokole OSPF.
Architektura redundantna rdzenia i dystrybucji bazuje na parzystych węzłach połączonych siatką pełną (Full-Mesh) lub częściową, eliminując pojedynczy punkt awarii i zapewniając deterministyczny czas przełączenia w przypadku awarii sprzętowej węzła.
Ilustracja techniczna do slajdu 39: Nadmiarowość urządzeń aktywnych w rdzeniu i dystrybucji

Nadmiarowość urządzeń w rdzeniu i dystrybucji sieci kampusowej wymaga bezwzględnego stosowania par przełączników wielowarstwowych połączonych redundantnymi łączami szkieletowymi. Każdy budynek powinien być obsługiwany przez minimum dwa niezależne przełączniki dystrybucyjne.

W węzłach szkieletowych stosuje się przełączniki modularne (Chassis) wyposażone w dwa niezależne procesory routingu i matryce przełączające (Dual Supervisor). W przypadku awarii procesora aktywnego przełączenie w trybie Stateful Switchover (SSO) następuje w czasie zerowym bez utraty tablic FIB i sesji użytkowników.

W nowoczesnych przełącznikach modularnych rdzenia sieci stosuje się architekturę NSF/SSO (Nonstop Forwarding with Stateful Switchover). W tym układzie zapasowy moduł zarządzający stale replikuje tablice routingu i stany sesji protokołów. Podczas fizycznej awarii procesora nadrzędnego przełączenie kontroli odbywa się bez restartu interfejsów liniowych, a pakiety danych są nieprzerwanie przekazywane ze sprzętową prędkością układów ASIC.

Skróty użyte w tym slajdzie:
Core Redundancy - Redundancja rdzenia, Instalacja co najmniej dwóch niezależnych przełączników szkieletowych połączonych pełną siatką.
Distribution Pair - Para dystrybucyjna, Układ dwóch przełączników agregujących obsługujących dany budynek lub grupę obiektów.
Failover - Przełączenie awaryjne, Zautomatyzowane przejęcie ruchu przez bliźniaczy węzeł sieciowy w czasie niezauważalnym dla użytkowników.

40/54

Nadmiarowość okablowania i tras kablowych między budynkami

Ochrona infrastruktury pasywnej na terenie otwartym.

Wykład 4: Nadmiarowość okablowania i tras kablowych między budynkami

  • Zagrożenia dla kabli zewnętrznych: prace ziemne, roboty budowlane, uszkodzenia przez gryzonie, zgniecenia traktów kanalizacji.
  • Złota zasada projektowa: zakaz prowadzenia kabla podstawowego i kabla zapasowego w tym samym wykopie lub tej samej rurze teletechnicznej.
  • Wymóg geograficznej separacji tras: kabel podstawowy prowadzony wschodnią stroną kampusu, kabel zapasowy zachodnią stroną kampusu.
  • Różne punkty wejścia do budynku: wprowadzenie światłowodów do budynku z dwóch przeciwległych stron (Dual Entrance Facilities).
Fizyczna redundancja tras światłowodowych wymaga prowadzenia kabli magistralnych odrębnymi kanalizacjami teletechnicznymi lub traktami napowietrznymi, co chroni kampus przed odcięciem budynku wskutek przypadkowego uszkodzenia kabla podczas prac ziemnych.
Ilustracja techniczna do slajdu 40: Nadmiarowość okablowania i tras kablowych między budynkami

Infrastruktura kablowa stanowi najdłużej eksploatowany element sieci kampusowej (cykl życia 15-20 lat). Z tego względu okablowanie szkieletowe pomiędzy budynkiem serwerowni (MDF) a punktami dystrybucyjnymi w budynkach (IDF) musi być projektowane z pełną redundancją fizyczną.

Do każdego budynku należy doprowadzić co najmniej dwa niezależne kable światłowodowe wielowłóknowe, jednomodowe (Single-Mode Fiber), zakończone w odrębnych szafach teletechnicznych lub na niezależnych przełącznicach ODF, co zabezpiecza łączność przed przypadkowym uszkodzeniem pojedynczego kabla.

Projektując okablowanie szkieletowe między obiektami kampusu, należy przyjąć zasadę instalacji kabli jednomodowych (Single-Mode Fiber - OS2) z odpowiednim zapasem włókien (minimum 24-48 włókien na relację). Kable jednomodowe charakteryzują się niemal nieograniczonym pasmem przenoszenia i umożliwiają wdrożenie technologii zwielokrotnienia falowego CWDM lub DWDM w przypadku konieczności gwałtownej rozbudowy pasma bez ponownych prac ziemnych.

Skróty użyte w tym slajdzie:
Diverse Conduit - Niezależna kanalizacja, Układanie kabli światłowodowych w odrębnych rurociągach kablowych w celu ochrony przed robotami ziemnymi.
FO - Fiber Optic, Wielowłóknowy kabel światłowodowy zapewniający rezerwę ciemnych włókien na wypadek uszkodzenia.
OTDR - Optical Time-Domain Reflectometer, Reflektometr optyczny do natychmiastowej lokalizacji miejsca przerwania kabla w terenie.

41/54

Geograficzna separacja traktów światłowodowych

Przykłady inżynierskiego projektowania tras na planie sytuacyjnym kampusu.

Wykład 4: Geograficzna separacja traktów światłowodowych

  • Analiza ryzyka urbanistycznego: identyfikacja newralgicznych punktów (mostki technologiczne, przepusty pod drogami publicznymi).
  • Stosowanie kabli światłowodowych z pancerzem ze stali falistej lub pancerzem dielektrycznym z włókien aramidowych przeciw gryzoniom.
  • Zastosowanie dedykowanych włókien ciemnych (Dark Fiber) w topologii pierścieniowej.
  • Okresowa weryfikacja parametrów tłumiennych reflektometrem optycznym (OTDR) na obu trasach.
Zasada geograficznej i budowlanej separacji tras kablowych wymaga wprowadzania kabli redundantnych do budynku przez przeciwległe ściany zewnętrzne i odrębne przepusty kablowe do niezależnych pionów instalacyjnych.
Ilustracja techniczna do slajdu 41: Geograficzna separacja traktów światłowodowych

Krytyczną zasadą inżynierską jest geograficzna separacja traktów światłowodowych. Ułożenie dwóch kabli w tej samej rurze kanalizacji teletechnicznej lub w tym samym wykopie tworzy złudne poczucie bezpieczeństwa - pojedynczy błąd operatora koparki przecina oba kable jednocześnie.

Prawidłowy projekt wymaga poprowadzenia tras światłowodowych całkowicie rozbieżnymi drogami: trakt podstawowy prowadzony jest np. wschodnią stroną kampusu, a trakt zapasowy stroną zachodnią. Podobnie wprowadzenia kabli do budynku powinny znajdować się po przeciwnych stronach obiektu.

Prawdziwa redundancja traktów światłowodowych wymaga wyeliminowania zjawiska pozornej dwudrogowości. Inżynier projektujący infrastrukturę kampusową musi przeanalizować mapy geodezyjne i upewnić się, że trasa podstawowa i rezerwowa nie krzyżują się w tych samych studniach kablowych ani nie przechodzą przez wspólne mostki technologiczne czy przepusty drogowe, które są szczególnie narażone na uszkodzenia mechaniczne podczas robót budowlanych.

Przy planowaniu separacji geograficznej traktów optycznych stosuje się zasadę traktu podstawowego i obwodowego (Diverse Routing). Standardem inżynierskim jest wprowadzenie kabli do budynku przez dwa niezależne przepusty kablowe w ścianach zewnętrznych (np. wschodni i zachodni) oraz zakończenie ich w dwóch odrębnych szafach teletechnicznych lub odrębnych panelach krosowych ODF, co eliminuje ryzyko zniszczenia całej łączności obiektu w przypadku lokalnego pożaru w piwnicy.

Skróty użyte w tym slajdzie:
Geographical Diversity - Separacja geograficzna, Prowadzenie światłowodów podstawowych i zapasowych przeciwległymi stronami kampusu.
Backhoe Fade - Przecięcie kabla koparką, Potoczne określenie mechanicznego zniszczenia infrastruktury podziemnej podczas prac budowlanych.
Right-of-Way - Prawo drogi, Formalne zgody zarządców dróg na wprowadzenie redundantnych tras kablowych do obiektów.

42/54

Topologie okablowania szkieletowego: podwójna gwiazda a pierścień

Porównanie ekonomiczne i techniczne układów połączeń międzyobiektowych.

Wykład 4: Topologie okablowania szkieletowego: podwójna gwiazda a pierścień

  • Układ podwójnej gwiazdy (Dual Star): każdy budynek połączony dwoma niezależnymi kablami bezpośrednio z centralnym MDF; najwyższa wydajność, prosty routing, wysoki koszt robót ziemnych.
  • Układ pierścieniowy (Fiber Ring): kable światłowodowe łączą kolejne budynki w pętlę; niższy koszt prac ziemnych, mniejsze zużycie kabla.
  • Wybór rozwiązania: pierścień optyczny na poziomie fizycznym, na którym zestawia się logiczne połączenia gwiazdowe za pomocą wydzielonych par włókien lub technologii zwielokrotnienia falowego (CWDM/DWDM).
Topologia podwójnej gwiazdy (Dual-Star / Hub-and-Spoke) jest preferowanym modelem sieci kampusowej zapewniającym stałe, minimalne opóźnienia i prostotę zarządzania, podczas gdy topologia pierścieniowa optymalizuje koszty robót ziemnych kosztem złożoności konwergencji.
Ilustracja techniczna do slajdu 42: Topologie okablowania szkieletowego: podwójna gwiazda a pierścień

W topologii szkieletu kampusowego wybiera się pomiędzy układem podwójnej gwiazdy (Dual Star) a pierścieniem światłowodowym (Collapsed Ring). Topologia podwójnej gwiazdy jest preferowanym standardem Cisco CVD ze względu na deterministyczne opóźnienia i prostotę trasowania L3.

Topologia pierścienia stosowana jest w rozległych kampusach terenowych w celu optymalizacji kosztów robót ziemnych. Wymaga ona jednak stosowania protokołów zabezpieczeń pierścieni (np. ITU-T G.8032 ERPS) gwarantujących rekonfigurację ścieżek poniżej 50 ms po przerwaniu ciągłości włókna.

Wybór między topologią podwójnej gwiazdy (Dual Star) a pierścieniem zależy od gęstości zabudowy kampusu. Podwójna gwiazda zapewnia najniższe i stałe opóźnienia transmisyjne oraz prostotę trasowania pakietów, wymagając jednak dużej liczby łączy punkt-punkt. Topologia pierścienia jest ekonomiczniejsza w instalacji ziemnej, lecz wymaga zastosowania protokołów ochrony pierścienia (np. ITU-T G.8032 ERPS), aby czas powrotu do sprawności po przecięciu kabla nie przekraczał 50 ms.

Skróty użyte w tym slajdzie:
Dual-Star - Podwójna gwiazda, Rekomendowana topologia szkieletu kampusowego oferująca deterministyczne trasy i brak pętli L2.
Ring - Topologia pierścienia, Ekonomiczny wariant prowadzenia kabli wymagający protokołów ochrony pierścienia ITU-T G.8032 ERPS.
ERPS - Ethernet Ring Protection Switching, Protokół ochrony pierścieni Ethernet z czasem rekonfiguracji poniżej 50 ms.

43/54

Nadmiarowość serwerów i usług kampusowych: klastry HA

Zapewnienie ciągłości pracy systemów uczelnianych i aplikacji.

Wykład 4: Nadmiarowość serwerów i usług kampusowych: klastry HA

  • Klastrowanie serwerów wirtualizacji (np. VMware vSphere HA, Proxmox VE Cluster, Microsoft Hyper-V).
  • Współdzielona pamięć masowa (SAN / NAS) z podwójnymi kontrolerami macierzy dyskowych i wielościeżkowością (Multipathing / MPIO).
  • Funkcja automatycznego restartu wirtualnych maszyn (VM Failover) na innym węźle klastra w razie fizycznej awarii serwera.
  • Technologia migracji na żywo bez przestoju (Live Migration / vMotion) umożliwiająca konserwację sprzętu w godzinach pracy.
Klastry wysokiej dostępności (HA Clusters) łączą fizyczne serwery i środowiska wirtualne (np. VMware HA, Proxmox VE), gwarantując automatyczny restart maszyn wirtualnych na węzłach zapasowych w przypadku awarii fizycznego hosta.
Ilustracja techniczna do slajdu 43: Nadmiarowość serwerów i usług kampusowych: klastry HA

Wysoka dostępność infrastruktury serwerowej i krytycznych usług uczelnianych (DNS, DHCP, Active Directory, systemy dziekanatowe) opiera się na klastrach wirtualizacyjnych (np. VMware vSphere HA, Proxmox VE Ceph Cluster). Serwery fizyczne wyposaża się w podwójne zasilacze i redundantne łącza sieciowe.

W przypadku fizycznej awarii pojedynczego serwera kasetowego mechanizmy automatyki klastra restartują wirtualne maszyny na pozostałych węzłach w czasie kilkunastu sekund. Usługi krytyczne (DNS, kontrolery domeny) wdraża się w układzie Anycast lub w parach z aktywną replikacją bazy danych.

Klasteryzacja usług serwerowych w kampusie opiera się na separacji warstwy obliczeniowej od warstwy pamięci masowej (SAN/NAS). Wykorzystanie protokołów iSCSI lub Fibre Channel z dedykowanymi, redundantnymi sieciami przełączanymi Fabric A i Fabric B gwarantuje, że awaria przełącznika pamięci masowej nie przerwie operacji wejścia-wyjścia wirtualnych maszyn bazodanowych i systemów dziekanatowych.

Skróty użyte w tym slajdzie:
Cluster - Klaster serwerowy, Grupa połączonych serwerów współpracujących w celu zapewnienia ciągłości działania aplikacji i baz danych.
Active/Passive Cluster - Klaster aktywny/pasywny, Wzorzec klastrowania z węzłem rezerwowym oczekującym na awarię węzła głównego.
Split-Brain - Stan niespójności klastra, Krytyczny błąd klastra powstały w wyniku utraty łączności kontrolnej pomiędzy węzłami.

44/54

Sprzętowe i programowe mechanizmy równoważenia obciążenia (Load Balancing)

Równomierne rozkładanie ruchu na farmy serwerowe.

Wykład 4: Sprzętowe i programowe mechanizmy równoważenia obciążenia (Load Balancing)

  • Urządzenia Application Delivery Controller (ADC) / Load Balancery (sprzętowe lub wirtualne, np. F5, HAProxy, Nginx).
  • Algorytmy równoważenia: Round-Robin, Least Connections (najmniejsza liczba aktywnych połączeń), IP Hash.
  • Ciągłe badanie stanu usług (Health Checks): odpytywanie serwerów WWW/SQL o status; natychmiastowe wykluczenie niesprawnego serwera z puli.
  • Terminacja sesji SSL/TLS na Load Balancerze w celu odciążenia procesorów serwerów aplikacyjnych.
Sprzętowe i programowe kontrolery dostarczania aplikacji (ADC / Load Balancer) dystrybuują ruch przychodzący pomiędzy farmami serwerów w oparciu o algorytmy Least Connections lub Round-Robin oraz monitorowanie stanu (Health Checks) usług aplikacyjnych.
Ilustracja techniczna do slajdu 44: Sprzętowe i programowe mechanizmy równoważenia obciążenia (Load Balancing)

Do równoważenia obciążenia i ochrony serwerów aplikacyjnych stosuje się sprzętowe lub programowe kontrolery dostarczania aplikacji ADC (Application Delivery Controllers / Load Balancers, np. F5 BIG-IP, HAProxy). Kontrolery monitorują stan serwerów za pomocą sond L4/L7.

W przypadku awarii serwera WWW lub spowolnienia jego odpowiedzi, Load Balancer natychmiast wycofuje dany węzeł z puli produkcyjnej, kierując ruch użytkowników do sprawnych serwerów zapasowych. Zapewnia to nieprzerwaną obsługę studentów nawet w trakcie awarii części infrastruktury backendowej.

Kontrolery ADC (Application Delivery Controller) pełnią w kampusie kluczową rolę w zapewnieniu dostępności portali uniwersyteckich i platform e-learningowych. Zaawansowane mechanizmy badania stanu zdrowia aplikacji (Health Checks) weryfikują nie tylko dostępność portu TCP, lecz także poprawność odpowiedzi na poziomie zapytań HTTP/HTTPS i zapytań SQL do bazy danych, automatycznie izolując węzły generujące błędy wewnętrzne aplikacji.

Skróty użyte w tym slajdzie:
SLB - Server Load Balancing, Sprzętowy kontroler dostarczania aplikacji (ADC) rozdzielający ruch użytkowników pomiędzy farmami serwerów.
VIP - Virtual IP, Wirtualny adres IP serwisu sieciowego rozgłaszany przez load balancer.
Health Check - Sonda sprawdzająca stan, Ciągłe testowanie dostępności aplikacji na serwerach w celu eliminacji maszyn niesprawnych.

45/54

Teaming kart sieciowych w serwerach (NIC Bonding)

Eliminacja SPOF na styku serwera z przełącznikiem dostępowym.

Wykład 4: Teaming kart sieciowych w serwerach (NIC Bonding)

  • Wymóg inżynierski: serwer wyposażony w co najmniej dwie fizyczne karty sieciowe (lub kartę dwuportową z osobnymi kontrolerami ASIC).
  • Połączenie fizyczne: port 1 wpięty do przełącznika dostępowego A, port 2 wpięty do przełącznika dostępowego B.
  • Tryby pracy w systemach Linux / Windows Server:
  • Active-Backup (Mode 1): jeden port aktywny, drugi przejmuje ruch po awarii kabla.
  • LACP (802.3ad / Mode 4): agregacja pasma obu portów przy wsparciu technologii multichassis na przełącznikach.
  • Eliminacja ryzyka paraliżu serwera bazy danych USOS przy awarii pojedynczego kabla krosowego (patchcordu).
NIC Teaming (Bonding w systemach Linux) to technologia łączenia wielu fizycznych kart sieciowych serwera w logiczny interfejs współpracujący z protokołem LACP, zapewniająca ochronę przed awarią karty sieciowej lub portu przełącznika.
Ilustracja techniczna do slajdu 45: Teaming kart sieciowych w serwerach (NIC Bonding)

Na poziomie pojedynczych serwerów fizycznych standardem eliminacji SPOF jest agregacja kart sieciowych, określana jako NIC Teaming lub NIC Bonding. Serwer wyposaża się w minimum dwa porty sieciowe podłączone do dwóch niezależnych przełączników dostępowych.

Zastosowanie trybu LACP (802.3ad) w połączeniu z technologią M-LAG na przełącznikach pozwala serwerowi na jednoczesne przesyłanie danych oboma łączami z pełną prędkością (np. 2x10 Gb/s) oraz natychmiastowe zachowanie łączności w przypadku awarii jednej z kart lub kabli.

Konfiguracja bondingu kart sieciowych w serwerach w trybie LACP (802.3ad) wymaga ścisłej współpracy z konfiguracją portów przełącznika. Zastosowanie rozproszonej grupy agregacji łączy (M-LAG) pozwala na podłączenie dwóch portów serwera do dwóch niezależnych przełączników dostępowych w szafie RACK, eliminując przełącznik dostępowy jako pojedynczy punkt awarii dla całego węzła obliczeniowego.

Skróty użyte w tym slajdzie:
NIC Teaming - Wiązanie kart sieciowych, Połączenie dwóch lub więcej fizycznych portów serwera w jeden logiczny interfejs sieciowy.
LACP Bonding - Agregacja dynamiczna 802.3ad, Tryb teamingu kart serwera zintegrowany z protokołem LACP przełącznika sieciowego.
Switch-Independent - Tryb niezależny od przełącznika, Wiązanie kart serwera nie wymagające specjalnej konfiguracji portów przełącznika.

46/54

Redundancja zasilania urządzeń sieciowych: zasilacze 1+1 i N+1

Zabezpieczenie przed najczęstszą awarią sprzętową przełączników.

Wykład 4: Redundancja zasilania urządzeń sieciowych: zasilacze 1+1 i N+1

  • Statystyka serwisowa: uszkodzenie zasilacza impulsowego to ponad 60% wszystkich awarii sprzętowych w przełącznikach sieciowych.
  • Wymóg projektowy: wszystkie przełączniki rdzeniowe, dystrybucyjne i kluczowe przełączniki dostępowe muszą posiadać co najmniej dwa niezależne zasilacze (Dual Power Supplies).
  • Wymogi normy PN-EN 50600: Architektura zasilania serwerowni kampusowej (MDF) powinna spełniać wymagania klasy dostępności Class 3 lub Class 4 według normy PN-EN 50600-2-2.
  • Tryb redundancyjny 1+1: każdy zasilacz jest w stanie samodzielnie pokryć 100% zapotrzebowania urządzenia na moc; pracują w trybie dzielenia obciążenia (Load Sharing).
  • Funkcja Hot-Swap: uszkodzony zasilacz wysuwa się z tylnej ścianki działającego przełącznika i wymienia się go na nowy bez wyłączania urządzenia i bez utraty choćby jednego pakietu.
Zgodnie z normą PN-EN 50600-2-2 urządzenia szkieletowe i dystrybucyjne muszą posiadać zasilacze nadmiarowe (Dual Power Supplies w trybie 1+1) z możliwością wymiany podczas pracy (Hot-Swap), zabezpieczając węzeł przed najczęstszą awarią sprzętową.
Ilustracja techniczna do slajdu 46: Redundancja zasilania urządzeń sieciowych: zasilacze 1+1 i N+1

Większość awarii infrastruktury sieciowej wynika z problemów po stronie zasilania elektroenergetycznego. Z tego względu wszystkie urządzenia szkieletowe i dystrybucyjne w kampusie muszą być wyposażone w podwójne zasilacze redundantne pracujące w układzie 1+1 lub N+1.

Zasilacze muszą pracować w trybie hot-swap, co umożliwia wymianę uszkodzonego modułu pod pełnym obciążeniem sieciowym bez konieczności wyłączania przełącznika. Dodatkowo zasilacze wyposaża się w monitoring parametrów prądowych przez protokół SNMPv3.

Zasilacze nadmiarowe w przełącznikach warstwy rdzenia i dystrybucji powinny pracować w trybie równoważenia obciążenia (Load Sharing). W tym układzie oba moduły zasilają urządzenie jednocześnie, pracując przy obciążeniu około 40-50 procent mocy nominalnej, co obniża temperaturę pracy ich podzespołów elektronicznych i znacząco wydłuża średni czas bezawaryjnej pracy (MTBF) całego systemu zasilania.

Skróty użyte w tym slajdzie:
1+1 Redundancy - Redundancja zasilaczy 1+1, Układ z dwoma zasilaczami, z których każdy jest w stanie samodzielnie pokryć 100% zapotrzebowania urządzenia.
N+1 - Redundancja modułowa, Architektura zasilania z jednym zasilaczem zapasowym dla grupy N zasilaczy pracujących.
Hot-Swap - Wymiana pod napięciem, Możliwość wymiany uszkodzonego modułu zasilacza bez wyłączania urządzenia sieciowego.

47/54

Podwójne tory zasilania w serwerowniach: linia A i linia B

Prawidłowe podłączenie zasilaczy redundantnych w szafie rack.

Wykład 4: Podwójne tory zasilania w serwerowniach: linia A i linia B

  • Podstawowy błąd instalacyjny: wpięcie obu zasilaczy przełącznika do tej samej listwy zasilającej PDU lub tego samego bezpiecznika.
  • Standard zasilania A+B (Dual-Corded Infrastructure):
  • Zasilacz 1 podłączony do pionowej listwy zasilającej PDU A (zasilanej z toru UPS A).
  • Zasilacz 2 podłączony do pionowej listwy zasilającej PDU B (zasilanej z toru UPS B).
  • Przełączniki statyczne STS (Static Transfer Switch): dla urządzeń sieciowych z pojedynczym zasilaczem należy stosować szafowe przełączniki faz STS o czasie przełączania 4-6 ms (zgodnie z krzywą podatności zasilaczy impulsowych ITIC/CBEMA), co gwarantuje ciągłość pracy bez restartu sprzętu.
  • Pełna odporność na wyłączenie jednego z torów zasilania podczas prac elektrycznych lub awarii bezpiecznika różnicowoprądowego.
Standard zasilania A+B wymaga zasilania urządzeń z podwójnym kablem zasilającym z odrębnych torów UPS, a dla urządzeń jednozasilaczowych stosowania ultraszybkich przełączników statycznych STS (Static Transfer Switch) o czasie przełączenia 4-6 ms (zgodnie z krzywą ITIC/CBEMA).
Ilustracja techniczna do slajdu 47: Podwójne tory zasilania w serwerowniach: linia A i linia B

Podstawowym wymogiem dla serwerowni kampusowej (MDF) oraz punktów dystrybucyjnych (IDF) jest wdrożenie architektury zasilania dwutorowego (Linia A oraz Linia B) zgodnie z normą PN-EN 50600-2-2 (Availability Class 3 lub 4). Każdy tor zasilany jest z odrębnego transformatora i dedykowanego zasilacza UPS.

Dla urządzeń z pojedynczym kablem zasilającym (Single-corded) standardem inżynierskim jest stosowanie szafowych przełączników statycznych STS (Static Transfer Switch). Przełącznik STS realizuje bezprzerwowe przełączenie faz w czasie 4-6 ms (zgodnie z krzywą podatności zasilaczy impulsowych ITIC/CBEMA), zapobiegając restartowi sprzętu.

Architektura dwutorowa (Dual-Corded Infrastructure) zakłada całkowite odseparowanie toru A od toru B, począwszy od rozdzielnicy głównej budynku, przez odrębne jednostki UPS, aż po pionowe listwy zasilające PDU w szafach RACK. Pozwala to na wykonywanie planowych prac konserwacyjnych, wymianę baterii w UPS czy przeglądy transformatorów bez konieczności wyłączania krytycznych urządzeń teleinformatycznych.

Skróty użyte w tym slajdzie:
Feed A / Feed B - Tory zasilania A i B, Dwie całkowicie niezależne linie elektroenergetyczne doprowadzone do szaf serwerowych.
STS - Static Transfer Switch, Elektroniczny przełącznik statyczny przełączający zasilanie urządzeń jednozasilaczowych w czasie 4-6 ms.
PDU - Power Distribution Unit, Dedykowana listwa zasilająca dla toru A i odrębna dla toru B w każdej szafie RACK.

48/54

Systemy zasilania bezprzerwowego (UPS): topologie i dobór

Filtrowanie zakłóceń sieci energetycznej i podtrzymanie bateryjne.

Wykład 4: Systemy zasilania bezprzerwowego (UPS): topologie i dobór

  • Topologie zasilaczy awaryjnych UPS:
  • Off-line (VFD): najprostsza, czas przełączenia na baterię 4-10 ms (niezalecana w serwerowniach).
  • Line-interactive (VI): stabilizacja napięcia AVR, czas przełączenia 2-4 ms (dopuszczalna w szafach piętrowych IDF).
  • On-line z podwójną konwersją (VFI): prąd zmienny jest stale prostowany na stały i ponownie przetwarzany na idealną sinusoidę; zerowy czas przełączenia (0 ms) - absolutny wymóg dla serwerowni MDF i rdzenia sieci.
  • Czas autonomii bateryjnej: w serwerowni z agregatem prądotwórczym i automatyką SZR (układ ATS) minimalny czas podtrzymania UPS wynosi 15-20 minut (czas na rozruch i stabilizację agregatu). W odległych szafach IDF pozbawionych agregatu czas podtrzymania powinien wynosić od 60 do 120 minut.
  • Filtrowanie skoków napięcia, zapadów, przepięć i zakłóceń harmonicznych z sieci miejskiej.
W serwerowniach kampusowych MDF bezwzględnie wymaga się stosowania zasilaczy UPS w topologii On-line z podwójną konwersją (VFI), która gwarantuje zerowy czas przełączenia (0 ms) oraz kompletną filtrację zakłóceń i przepięć sieci energetycznej.
Ilustracja techniczna do slajdu 48: Systemy zasilania bezprzerwowego (UPS): topologie i dobór

Systemy zasilania bezprzerwowego (UPS) stanowią pierwszą linię obrony przed zanikami i zakłóceniami sieci energetycznej. W serwerowniach kampusowych dopuszcza się wyłącznie zasilacze UPS pracujące w topologii Online (VFI - Voltage and Frequency Independent wg normy PN-EN 62040-3).

W topologii VFI następuje ciągłe podwójne przetwarzanie energii (AC/DC i DC/AC), co gwarantuje zerowy czas przełączenia na baterie (0 ms) oraz całkowitą izolację urządzeń sieciowych od przepięć i wahań częstotliwości w miejskiej sieci energetycznej. Zaleca się stosowanie układów modułowych z redundancją modułów mocy N+1.

W serwerowniach kampusowych standardem inżynierskim jest stosowanie zasilaczy UPS w topologii True Online (VFI według normy PN-EN 62040-3). W tym rozwiązaniu falownik zasila urządzenia sieciowe bez przerw, pobierając energię ze stałoprądowej szyny bateryjnej, co całkowicie eliminuje zakłócenia sieciowe, spadki napięcia oraz stany nieustalone generowane przez załączanie odbiorników dużej mocy na terenie kampusu.

Klasyfikacja systemów UPS według normy PN-EN 62040-3 opiera się na kodzie literowym, w którym oznaczenie VFI (Voltage and Frequency Independent) wskazuje na całkowitą niezależność napięcia i częstotliwości wyjściowej od wahań w sieci zasilającej. W przeciwieństwie do tańszych zasilaczy line-interactive (klasa VI) lub offline (klasa VFD), układy VFI nie generują żadnego czasu przełączania na pracę bateryjną (Transfer Time = 0 ms), co chroni czułe zasilacze impulsowe serwerów i przełączników rdzeniowych przed mikroresetami.

Skróty użyte w tym slajdzie:
Online UPS - Zasilacz bezprzerwowy z podwójną konwersją, Topologia VFI (Voltage and Frequency Independent) gwarantująca zerowy czas przełączenia na baterie.
VFI - Voltage and Frequency Independent, Międzynarodowa klasyfikacja zasilaczy UPS najwyższej klasy bezpieczeństwa wg PN-EN 62040-3.
Bypass - Tor obejściowy, Automatyczny i ręczny tor obejściowy umożliwiający serwisowanie zasilacza UPS bez wyłączania odbiorników.

49/54

Wymiarowanie czasu podtrzymania bateryjnego dla szaf IDF i MDF

Kalkulacja inżynierska pojemności akumulatorów.

Wykład 4: Wymiarowanie czasu podtrzymania bateryjnego dla szaf IDF i MDF

  • Zróżnicowanie wymagań w zależności od węzła:
  • Punkty piętrowe IDF: czas podtrzymania typowo 15-30 minut (wystarczający na bezpieczne wyłączenie stacji lub przeczekanie krótkich zaników).
  • Główna serwerownia MDF (bez agregatu): czas podtrzymania od 60 do 120 minut.
  • Główna serwerownia MDF (z agregatem prądotwórczym): czas podtrzymania 10-15 minut (akumulatory pokrywają jedynie czas rozruchu i stabilizacji silnika diesla).
  • Współczynnik degradacji baterii: uwzględnienie spadku pojemności ogniw kwasowo-ołowiowych (VRLA/AGM) lub litowo-jonowych (Li-Ion) o 20-30% w cyklu 3-5 lat eksploatacji.
Projektowanie autonomii bateryjnej wymaga zapewnienia 15-20 minut pracy w serwerowni MDF wyposażonej w agregat prądotwórczy z układem SZR oraz 60-120 minut podtrzymania w szafach piętrowych IDF pozbawionych zasilania awaryjnego z agregatu.
Ilustracja techniczna do slajdu 49: Wymiarowanie czasu podtrzymania bateryjnego dla szaf IDF i MDF

Wymiarowanie czasu autonomii bateryjnej UPS musi ściśle zależeć od lokalizacji i obecności agregatu prądotwórczego. W głównej serwerowni MDF wyposażonej w automatyczny agregat prądotwórczy (SZR) czas podtrzymania UPS projektuje się na 15-20 minut (czas niezbędny na rozruch i stabilizację silnika spalinowego).

Z kolei w odległych szafach IDF zlokalizowanych w budynkach dydaktycznych pozbawionych agregatu, zasilacze UPS muszą zapewnić podtrzymanie zasilania przez 60-120 minut. Pozwala to na podtrzymanie zasilania PoE dla kamer monitoringu IP, zamków elektronicznych i punktów AP w trakcie typowych awarii miejskiej sieci energetycznej.

Wymiarowanie pojemności akumulatorów UPS opiera się na wyznaczeniu całkowitego poboru mocy czynnej (W) i pozornej (VA) zainstalowanych urządzeń z uwzględnieniem sprawności falownika oraz współczynnika starzenia baterii (zwykle przyjmuje się 20-procentowy narzut na utratę pojemności po 3-5 latach eksploatacji). W szafach IDF czas podtrzymania powinien zapewniać bezpieczne zamknięcie systemów lub podtrzymanie pracy sieci do momentu usunięcia typowych awarii zasilania miejskiego.

Skróty użyte w tym slajdzie:
Autonomy Time - Czas podtrzymania, Wymagany czas pracy na bateriach (15-20 min przy obecności agregatu, 60-120 min w szafach IDF).
kVA/kW - Moc pozorna i czynna, Parametry elektryczne doboru mocy zasilaczy z uwzględnieniem współczynnika mocy Power Factor.
VRLA / Li-Ion - Technologia baterii, Baterie ołowiowo-kwasowe regulowane zaworem lub nowoczesne akumulatory litowo-jonowe.

50/54

Zasilanie awaryjne z agregatów prądotwórczych i układy automatyki SZR

Autonomia energetyczna kampusu w warunkach długotrwałego blackoutu.

Wykład 4: Zasilanie awaryjne z agregatów prądotwórczych i układy automatyki SZR

  • Agregat prądotwórczy z silnikiem wysokoprężnym (Diesel Generator): źródło energii na wypadek wielogodzinnych awarii sieci zawodowej.
  • Układ Samoczynnego Załączenia Rezerwy (SZR / ATS - Automatic Transfer Switch): sterownik automatycznie wykrywa zanik napięcia sieciowego, uruchamia silnik agregatu i po ustabilizowaniu obrotów (typowo 10-20 sekund) przełącza zasilanie obiektu na generator.
  • Rola UPS w cyklu SZR: podtrzymanie pracy urządzeń sieciowych w czasie rozruchu agregatu.
  • Wymóg regularnych testów pod obciążeniem rzeczywistym oraz stałego monitorowania poziomu i jakości paliwa.
Agregat prądotwórczy współpracujący z układem Samoczynnego Załączania Rezerwy (SZR / ATS) zapewnia długotrwałą autonomię energetyczną całego obiektu, automatycznie uruchamiając generator i przejmując zasilanie w ciągu kilkunastu sekund od zaniku sieci miejskiej.
Ilustracja techniczna do slajdu 50: Zasilanie awaryjne z agregatów prądotwórczych i układy automatyki SZR

Drugą linię obrony zasilania gwarantowanego stanowi stacjonarny agregat prądotwórczy z silnikiem wysokoprężnym połączony z układem automatyki Samoczynnego Załączania Rezerwy (SZR / ATS). Układ SZR stale monitoruje parametry napięcia miejskiego.

W przypadku zaniku fazy układ SZR wysyła sygnał startu do agregatu. Czas od zaniku zasilania do podania pełnej mocy z generatora wynosi zazwyczaj 10-15 sekund (w tym czasie serwerownię podtrzymuje UPS). Agregat musi posiadać podgrzewany blok silnika, automatyczną ładowarkę akumulatorów oraz zapas paliwa na 24-48 godzin ciągłej pracy.

Stacjonarne zespoły prądotwórcze z układem automatycznego załączania rezerwy (SZR / ATS) muszą być wyposażone w układy podgrzewania bloku silnika i ładowania buforowego akumulatorów rozruchowych. Prawidłowy cykl eksploatacyjny wymaga przeprowadzania comiesięcznych próbnych rozruchów agregatu pod realnym obciążeniem serwerowni, co pozwala zweryfikować sprawność układów przełączających SZR oraz zapobiega zjawisku koksowania wtryskiwaczy silnika wysokoprężnego.

Z punktu widzenia projektanta instalacji elektrycznej w serwerowni kluczowym parametrem zespołu prądotwórczego jest odporność na obciążenia nieliniowe generowane przez zasilacze impulsowe serwerów (wyższe harmoniczne prądu). Wymaga to przewymiarowania mocy prądnicy agregatu o około 30-50 procent w stosunku do mocy zainstalowanych zasilaczy UPS oraz wyposażenia generatora w elektroniczny regulator napięcia (AVR) z szybką pętlą sprzężenia zwrotnego, co zapobiega niekontrolowanym skokom częstotliwości podczas nagłych zmian obciążenia.

Skróty użyte w tym slajdzie:
SZR - Samoczynne Załączanie Rezerwy, Układ automatyki sterujący rozruchem generatora diesla i przełączeniem styczników zasilania.
ATS - Automatic Transfer Switch, Automatyczny przełącznik zasilania sieciowego na generator prądotwórczy.
Genset - Agregat prądotwórczy, Stacjonarny generator prądu z silnikiem wysokoprężnym zapewniający wielodniową ciągłość zasilania kampusu.

51/54

Zasilanie prądem przemiennym (AC) a zasilaniem prądem stałym (DC -48V)

Standardy energetyczne w węzłach teleinformatycznych.

Wykład 4: Zasilanie prądem przemiennym (AC) a zasilaniem prądem stałym (DC -48V)

  • Tradycyjne zasilanie AC (230V / 400V 50Hz): standard w środowiskach IT i szafach biurowych; łatwa dostępność urządzeń i osprzętu.
  • Zasilanie prądem stałym DC -48V: historyczny standard telekomunikacyjny (Telco Standard), powszechnie stosowany w węzłach szkieletowych operatorów i dużych MDF.
  • Zalety zasilania DC: brak strat na wielokrotnej konwersji AC/DC, bezpośrednie buforowanie bateryjne (baterie wpięte bezpośrednio do szyny prądowej bez falowników), ogromna niezawodność i prostota układu.
  • Współczesne przełączniki rdzeniowe i routery brzegowe: możliwość zamówienia wersji z zasilaczami AC lub zasilaczami DC -48V.
Zasilanie prądem stałym DC -48V, powszechne w obiektach telekomunikacyjnych, eliminuje problem synchronizacji faz i podwójnej konwersji energii, oferując najwyższą sprawność energetyczną i bezpośrednie podłączenie bufora bateryjnego.
Ilustracja techniczna do slajdu 51: Zasilanie prądem przemiennym (AC) a zasilaniem prądem stałym (DC -48V)

Tradycyjne urządzenia teleinformatyczne w kampusie zasilane są prądem przemiennym AC (230V / 400V). Jednak w centralnych węzłach szkieletowych i serwerowniach telekomunikacyjnych coraz częściej stosuje się zasilanie prądem stałym DC o napięciu -48V.

Systemy DC -48V charakteryzują się znacznie prostszą budową i wyższą sprawnością energetyczną (brak strat na falownikach DC/AC w UPS). Baterie akumulatorów są podłączone bezpośrednio do szyny prądowej w buforze, co całkowicie wyklucza ryzyko awarii elementów przełączających fazy.

Przejście na zasilanie prądem stałym DC -48V w głównych węzłach kampusowych przynosi istotne korzyści w zakresie niezawodności i sprawności energetycznej. Wyeliminowanie falowników prądu przemiennego oznacza brak wrażliwych na temperaturę kondensatorów elektrolitycznych wysokiego napięcia, a bezpośrednie podłączenie banku baterii do szyny zasilającej gwarantuje absolutnie bezprzerwowe zasilanie urządzeń w przypadku zaniku napięcia w sieci zawodowej.

Skróty użyte w tym slajdzie:
AC - Alternating Current, Standardowe zasilanie prądem przemiennym 230V/400V 50Hz powszechne w serwerowniach IT.
DC -48V - Prąd stały -48V, Standard zasilania telekomunikacyjnego o wysokiej niezawodności i prostej architekturze buforowania bateryjnego.
Rectifier - Prostownik, Urządzenie przetwarzające prąd przemienny na napięcie stałe -48V z bezpośrednim podłączeniem baterii.

52/54

Zarządzanie środowiskowe i telemetria punktów dystrybucyjnych

Nadzór nad parametrami fizycznymi szaf rackowych.

Wykład 4: Zarządzanie środowiskowe i telemetria punktów dystrybucyjnych

  • Czynniki niszczące sprzęt aktywny: przegrzanie, wilgoć, zalanie wodą, zapylenie.
  • Instalacja czujników środowiskowych (Environment Monitoring): temperatura w szafie, wilgotność względna, czujniki dymu, czujniki zalania podłogi technicznej, kontaktrony otwarcia drzwi szafy rack.
  • Integracja z systemem zarządzania siecią (NMS) za pośrednictwem protokołu SNMP i komunikatów Syslog.
  • Automatyczne alerty SMS/e-mail w przypadku przekroczenia temperatury progowej (np. powyżej 35 stopni C w szafie IDF).
Zdalny monitoring środowiskowy (SNMP, sensory temperatury, wilgotności, zalania oraz czujniki otwarcia drzwi szaf rack) stanowi nieodzowny element ochrony proaktywnej, ostrzegając administratorów o anomaliach klimatycznych przed wystąpieniem awarii sprzętowej.
Ilustracja techniczna do slajdu 52: Zarządzanie środowiskowe i telemetria punktów dystrybucyjnych

Niezawodność sprzętu aktywnego jest ściśle uzależniona od warunków środowiskowych panujących w szafach RACK i serwerowniach. Każdy punkt dystrybucyjny musi być wyposażony w precyzyjną klimatyzację oraz zintegrowany system monitoringu środowiskowego.

Sensory monitorują temperaturę powietrza nawiewanego i wywiewanego, wilgotność względną, obecność zalania wodą pod podłogą techniczną oraz stan czujników otwarcia drzwi szafy. Przekroczenie progów alarmowych powoduje natychmiastowe wysłanie alertów SNMPv3 Trap i powiadomień SMS do dyżurnych inżynierów.

Systemy zarządzania środowiskowego w szafach RACK (DCIM / EMS) stanowią integralną część strategii wysokiej dostępności. Integracja czujników temperatury, wilgotności, czujek dymu i otwarcia drzwi z uczelnianym systemem zarządzania siecią (NMS) za pośrednictwem protokołu SNMPv3 pozwala na wczesne wykrywanie anomalii termicznych (np. awarii klimatyzatora precyzyjnego) i automatyczne generowanie alertów przed dojściem do termicznego wyłączenia przełączników rdzeniowych.

Skróty użyte w tym slajdzie:
EMS - Environmental Monitoring System, System czujników temperatury, wilgotności, zalania i otwarcia drzwi szafy RACK.
SNMP Trap - Pułapka telemetryczna SNMP, Natychmiastowe powiadomienie alarmowe wysyłane do administratora przy wzroście temperatury w szafie.
HVAC - Heating, Ventilation, and Air Conditioning, System klimatyzacji precyzyjnej w węzłach teletechnicznych.

53/54

Podsumowanie najważniejszych zagadnień wykładu

Kluczowe filary wysokiej dostępności sieci kampusowej.

Wykład 4: Podsumowanie najważniejszych zagadnień wykładu

  • Wysoka dostępność to całościowa strategia projektowa eliminująca pojedyncze punkty awarii (SPOF) na każdym poziomie.
  • W warstwie 2 nowoczesne standardy RSTP (802.1w) i MSTP (802.1s) rozwiązują problem pętli i umożliwiają równoważenie obciążenia w podziale na instancje VLAN.
  • Mechanizmy ochrony STP (BPDU Guard, Root Guard, Loop Guard) są krytyczne dla zachowania integralności topologii logicznej.
  • Nowoczesne szkielety kampusowe dążą do eliminacji blokowania portów poprzez agregację wielourządzeniową (MCEC / MLAG / StackWise) pracującą w trybie Loop-Free Active-Active.
  • Redundancję pierwszej bramy domyślnej zapewniają standardy FHRP (VRRPv3 RFC 5798, HSRP, GLBP) z mechanizmami Object Tracking.
  • Infrastruktura fizyczna wymaga geograficznej separacji tras kabli światłowodowych oraz podwójnych torów zasilania gwarantowanego A+B (UPS On-Line, SZR, agregat).
  • Węzły MDF o najwyższej krytyczności mogą korzystać z telekomunikacyjnych systemów zasilania prądem stałym DC -48V.
Kompleksowa wysoka dostępność w kampusie łączy redundancję fizyczną (zasilanie A+B, separowane trasy kablowe), niezawodność sprzętową (zasilacze hot-swap, łączenie przełączników w stosy) oraz protokoły subsekundowej konwergencji (RSTP, LACP, FHRP z BFD).
Ilustracja techniczna do slajdu 53: Podsumowanie najważniejszych zagadnień wykładu

Wysoka dostępność sieci kampusowej to wynik współdziałania wielu warstw technologicznych. Eliminacja pojedynczych punktów awarii wymaga konsekwentnego dublowania urządzeń, tras kablowych i torów zasilania, a także eliminacji blokad STP na rzecz wiązek LACP i routingu L3.

Nowoczesna infrastruktura kampusowa projektowana zgodnie z normami PN-EN 50600 i wytycznymi CVD gwarantuje ciągłość usług dydaktycznych i badawczych, odporność na błędy ludzkie oraz deterministyczną konwergencję w przypadku nieprzewidzianych awarii fizycznych.

Podsumowując zagadnienia wysokiej dostępności, należy podkreślić, że niezawodność sieci kampusowej jest procesem ciągłym, wymagającym regularnego audytu i testów awaryjnych. Wdrożenie odpornej topologii bezpętlowej, agregacji wielourządzeniowej, redundancji bram FHRP oraz wielopoziomowego zasilania gwarantowanego pozwala zminimalizować ryzyko przestoju i zapewnić nieprzerwaną ciągłość procesów dydaktycznych i badawczych.

Skróty użyte w tym slajdzie:
HA - High Availability, Holistyczne podejście łączące redundancję zasilania, okablowania, urządzeń i protokołów sieciowych.
STP/RSTP - Drzewo rozpinające, Ochrona warstwy 2 w połączeniu z agregacją LACP.
FHRP - Redundancja bramy, Bezpieczeństwo pierwszego skoku stacji roboczych.
Dual-Feed - Podwójne zasilanie, Gwarancja ciągłości energetycznej węzłów kampusowych.

54/54

Zapowiedź kolejnego wykładu: wirtualne sieci lokalne VLAN i zaawansowana segmentacja

Wskazanie kolejnego etapu kursu inżynierskiego.

Wykład 4: Zapowiedź kolejnego wykładu: wirtualne sieci lokalne VLAN i zaawansowana segmentacja

  • Temat kolejnego spotkania: wirtualne sieci lokalne (VLAN), separacja portów, Private VLAN, dynamiczne przypisywanie VLAN i routing między-VLAN.
  • Kluczowe zagadnienia: tagowanie 802.1Q, porty dostępowe (Access) i trunkowe (Trunk), Private VLAN (izolacja w akademikach), dynamiczne przypisywanie VLAN na podstawie adresu MAC i 802.1X, interfejsy SVI na przełącznikach L3.
  • Powiązanie z redundancją: jak prawidłowo zaprojektować schemat VLAN i podsieci, aby idealnie współgrał z protokołami wysokiej dostępności.
  • Zadanie do przemyślenia: dlaczego umieszczenie wszystkich studentów, kamer i serwerów w jednym VLAN-ie to katastrofa bezpieczeństwa i wydajności.
Wirtualna sieć lokalna (VLAN) to logiczna domena rozgłoszeniowa standaryzowana w normie IEEE 802.1Q; kolejny wykład przedstawi projektowanie segmentacji ruchu, architekturę łączy trunkingowych oraz optymalizację bezpieczeństwa warstwy dostępu.
Ilustracja techniczna do slajdu 54: Zapowiedź kolejnego wykładu: wirtualne sieci lokalne VLAN i zaawansowana segmentacja

Wykład poświęcony wysokiej dostępności i redundancji zamyka blok zagadnień dotyczących odporności fizycznej i logicznej sieci kampusowej. Kolejny moduł programowy koncentruje się na zaawansowanej segmentacji logicznej w warstwie 2 i 3.

W wykładzie 5 szczegółowej analizie poddane zostaną wirtualne sieci lokalne (VLAN, IEEE 802.1Q), technologia Private VLAN (PVLAN), dynamiczne przypisywanie do sieci VLAN w oparciu o standard IEEE 802.1X i atrybuty RADIUS oraz sprzętowa realizacja routingu między-VLAN na przełącznikach warstwy 3 (SVI, CEF, TCAM).

Zapewnienie wysokiej dostępności i odporności na awarie w warstwie fizycznej i łączowej stanowi solidny fundament dla dalszej rozbudowy architektury sieciowej. W kolejnym wykładzie uwaga zostanie skierowana na zagadnienia wirtualnych sieci lokalnych (VLAN) oraz zaawansowanej segmentacji ruchu, w tym izolacji portów w architekturze Private VLAN, technologii podwójnego tagowania ramek QinQ oraz projektowania routingu międzywęzłowego Inter-VLAN.

Skróty użyte w tym slajdzie:
VLAN - Virtual Local Area Network, Tematyka kolejnego spotkania poświęconego zaawansowanej segmentacji sieci.
PVLAN - Private VLAN, Techniki izolacji portów wewnątrz wspólnej podsieci.
802.1Q - Standard trunkingu, Znakowanie ramek w wieloobiektowej sieci kampusowej.

Podgląd okładki książki