Wykład 6: Adresacja IPv4 i IPv6 oraz kluczowe usługi sieciowe w środowisku kampusowym

1/54

Adresacja IPv4 i IPv6 oraz kluczowe usługi sieciowe w środowisku kampusowym

Slajd tytułowy definiujący zakres wykładu poświęconego adresacji sieciowej i usługom aplikacyjnym.

Wykład 6: Adresacja IPv4 i IPv6 oraz kluczowe usługi sieciowe w środowisku kampusowym

  • Tytuł wykładu i kontekst inżynierski: planowanie przestrzeni adresowej oraz architektura podstawowych usług sieciowych.
  • Zakres zagadnień: od strategii VLSM i wdrożenia IPv6, przez usługi DHCP z DHCP Relay i DNS (caching, RPZ, DoH/DoT), po uczelniane serwery plików i konteneryzację Docker.
  • Prezentacja obejmuje także zaawansowane usługi sieciowe i konteneryzację, zgodnie z wymaganiami nowoczesnego kampusu.
  • Miejsce w programie: warstwa logiczna i usługowa infrastruktury teleinformatycznej.
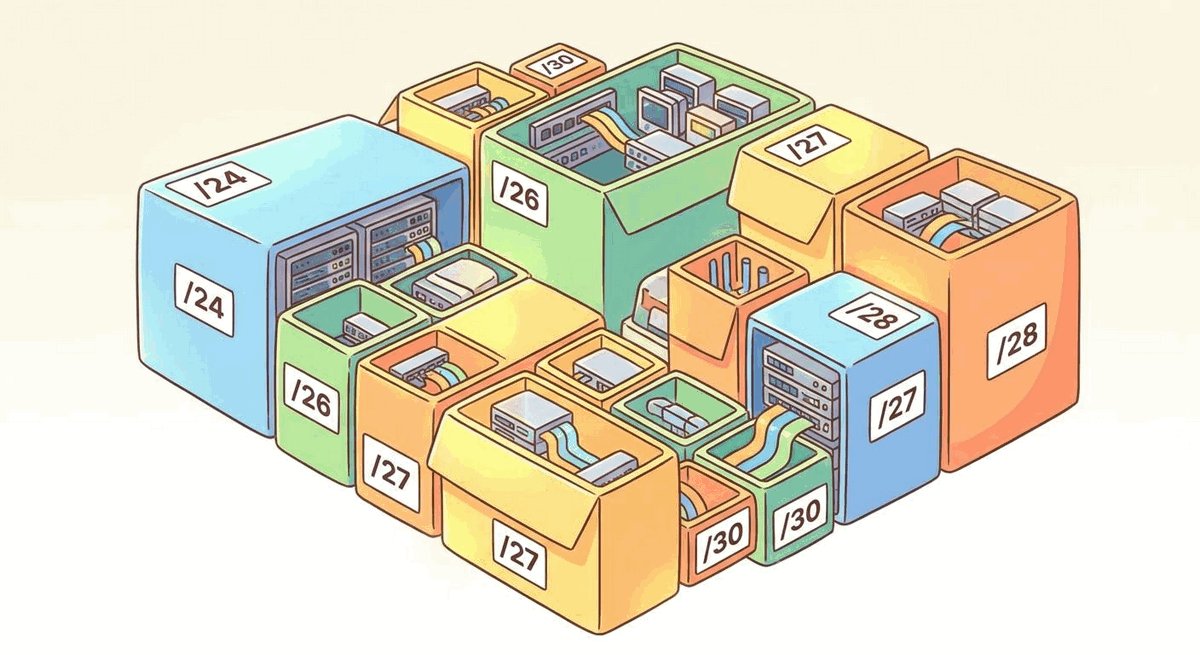
Planowanie przestrzeni adresowej to proces inżynierski polegający na logicznym podziale i przydziale prefiksów IPv4 i IPv6, który zapewnia stabilność routingu i bezpieczeństwo sieci kampusowej.
Ilustracja techniczna do slajdu 1: Adresacja IPv4 i IPv6 oraz kluczowe usługi sieciowe w środowisku kampusowym

Adresacja logiczna oraz podstawowe usługi infrastrukturalne (DHCP, DNS, transfer plików i mikrousługi) tworzą środowisko operacyjne dla wszystkich aplikacji i użytkowników w sieci kampusowej. Bez spójnego, hierarchicznego planu adresacji nawet najbardziej zaawansowane przełączniki i routery stają się niezarządzalne.

Współczesna sieć kampusowa funkcjonuje w modelu Dual-Stack, obsługując równolegle protokół IPv4 oraz standard IPv6. Integracja adresacji z automatyzacją przydziału konfiguracji i ochroną warstwy dostępu decyduje o stabilności i bezpieczeństwie całego środowiska akademickiego.

Współczesna sieć kampusowa to nie tylko kable i przełączniki, lecz przede wszystkim zintegrowane środowisko usług sieciowych warstwy 3 do 7. Prawidłowo zaprojektowany plan adresacji logicznej jest fundamentem, na którym opierają się krytyczne procesy uczelni: od rejestracji studentów w systemach dziekanatowych, przez uwierzytelnianie w sieci eduroam, aż po zdalny dostęp do laboratoriów badawczych i klastrów obliczeniowych wysokiej wydajności.

Wdrażanie modelu Dual-Stack w kampusie akademickim wymaga zrównoważonego podejścia do zasobów sprzętowych przełączników i routerów. Tablice routingu sprzętowego TCAM muszą równolegle przechowywać prefiksy 32-bitowe oraz 128-bitowe, co zmniejsza efektywną pojemność tablicy FIB o około połowę w porównaniu z pracą w czystym środowisku IPv4. Inżynier projektujący infrastrukturę musi uwzględnić ten kompromis przy doborze platform sprzętowych dla węzłów szkieletowych i dystrybucyjnych.

Skróty użyte w tym slajdzie:
IPv4 (Internet Protocol version 4) - Czwarta wersja protokołu IP z 32-bitową przestrzenią adresową (RFC 791).
IPv6 (Internet Protocol version 6) - Protokół internetowy nowej generacji ze 128-bitową przestrzenią adresową (RFC 8200).
DHCP (Dynamic Host Configuration Protocol) - Protokół automatycznej konfiguracji węzłów w sieci IP (RFC 2131).
DNS (Domain Name System) - Rozproszony system mapowania nazw mnemonicznych na binarne adresy IP (RFC 1034/1035).
SLAAC (Stateless Address Autoconfiguration) - Mechanizm bezstanowej autokonfiguracji adresów IPv6 (RFC 4862).

2/54

Cel i agenda wykładu

Przedstawienie harmonogramu wykładu i kluczowych zagadnień.

Wykład 6: Cel i agenda wykładu

  • Część 1: strategia planowania adresacji IPv4, pule RFC 1918, VLSM i agregacja CIDR.
  • Część 2: architektura protokołu IPv6 w kampusie, typy adresów, planowanie prefiksów, SLAAC i DHCPv6.
  • Część 3: protokół DHCP - cykl DORA, agent pośredniczący DHCP Relay (ip helper-address) i ochrona DHCP Snooping.
  • Część 4: system nazw domenowych DNS w kampusie - architektura Split-DNS, serwery autorytatywne i rekurencyjne.
  • Część 5: zaawansowane mechanizmy DNS - buforowanie, filtrowanie DNS RPZ / sinkhole oraz szyfrowany DNS (DoT, DoH).
  • Część 6: podstawowe uczelniane usługi sieciowe - WWW, SFTP, serwery plików SMB/CIFS i NFS.
  • Część 7: konteneryzacja i platforma Docker w architekturze mikrousług sieciowych.
  • Część 8: podsumowanie wykładu i wnioski projektowe.
Plan wykładu prowadzi od matematycznych reguł podziału przestrzeni adresowej (VLSM, CIDR, RFC 3021), przez specyfikację IPv6 i protokoły DHCP, aż po architekturę DNS, usługi plikowe i konteneryzację.
Ilustracja techniczna do slajdu 2: Cel i agenda wykładu

Agenda wykładu odzwierciedla logiczny ciąg projektowy: od matematycznych i strukturalnych podstaw podziału przestrzeni adresowej (VLSM, CIDR, RFC 3021), przez architekturę i bezstanową autokonfigurację IPv6, aż po mechanizmy dynamicznego przydziału adresów DHCPv4/v6 i ich ochronę w warstwie 2.

Drugi kluczowy blok zagadnień obejmuje projektowanie odpornego na awarie systemu nazw domenowych (Split-Horizon DNS, DNS RPZ, DNSSEC, DoT/DoH), infrastrukturę transferu plików i pamięci masowych SAN/iSCSI oraz nowoczesne techniki konteneryzacji mikrousług sieciowych w środowisku Docker.

Struktura wykładu łączy rygorystyczne fundamenty matematyczne alokacji bitów adresowych z praktycznymi wyzwaniami eksploatacyjnymi w dobie transformacji cyfrowej. Szczególną uwagę poświęcono mechanizmom obronnym chroniącym protokoły warstwy aplikacyjnej i sieciowej przed manipulacją oraz wykorzystaniu nowoczesnych technik wirtualizacji i konteneryzacji w procesie bezpiecznego wdrażania usług teleinformatycznych.

Skróty użyte w tym slajdzie:
VLSM (Variable Length Subnet Masking) - Technika podziału przestrzeni adresowej na podsieci o zróżnicowanych długościach masek.
CIDR (Classless Inter-Domain Routing) - Bezklasowa agregacja i routing prefiksów sieciowych (RFC 4632).
DORA (Discover, Offer, Request, Acknowledge) - Standardowy czterokrokowy cykl wymiany komunikatów w protokole DHCPv4.
DoH (DNS over HTTPS) - Standard przesyłania zapytań DNS wewnątrz szyfrowanego tunelu HTTPS/TLS (RFC 8484).
DoT (DNS over TLS) - Protokół szyfrowania zapytań DNS bezpośrednio przez protokół TLS na dedykowanym porcie TCP 853 (RFC 7858).

3/54

Wykaz norm i dokumentów IETF RFC

Zestawienie kluczowych dokumentów standaryzacyjnych IETF.

Wykład 6: Wykaz norm i dokumentów IETF RFC

  • Przestrzeń adresów prywatnych: IETF RFC 1918, Address Allocation for Private Internets.
  • Protokół dynamicznej konfiguracji hosta: IETF RFC 2131, Dynamic Host Configuration Protocol.
  • Protokół DHCP dla IPv6: IETF RFC 8415, Dynamic Host Configuration Protocol for IPv6 (DHCPv6).
  • Podstawy systemu nazw domenowych: IETF RFC 1034 oraz RFC 1035, Domain Names - Concepts and Facilities.
  • Szyfrowany DNS przez TLS: IETF RFC 7858, Specification for DNS over Transport Layer Security (DoT).
  • Szyfrowany DNS przez HTTPS: IETF RFC 8484, DNS Queries over HTTPS (DoH).
  • Architektura adresacji IPv6: IETF RFC 4291, IP Version 6 Addressing Architecture.
Normy IETF (RFC 1918, RFC 3021, RFC 2131, RFC 8415) oraz zalecenia CSIRT NASK / CERT Polska definiują formalne wymagania standaryzacyjne dla usług adresacji i infrastruktury sieciowej.
Ilustracja techniczna do slajdu 3: Wykaz norm i dokumentów IETF RFC

Podstawą standaryzacji adresacji i usług sieciowych są specyfikacje IETF publikowane w dokumentach RFC. Obejmują one zarówno fundamenty przestrzeni prywatnych (RFC 1918) i prefiksów /31 na łączach punkt-punkt (RFC 3021), jak i specyfikacje protokołów DHCP (RFC 2131, RFC 3046, RFC 8415) oraz bezpieczeństwa DNS (RFC 4033, RFC 7858, RFC 8484).

Wdrażanie usług sieciowych na uczelni wymaga również zgodności z przepisami prawa, w tym z ustawą Prawo komunikacji elektronicznej, wytycznymi UODO w zakresie ochrony tożsamości oraz zaleceniami CSIRT NASK / CERT Polska dotyczącymi zabezpieczenia serwerów DNS przed zatruwaniem pamięci podręcznej (DNS Cache Poisoning).

Studiowanie oryginalnych dokumentów RFC jest niezbędnym elementem kształcenia inżyniera teleinformatyki. Uczy ono precyzyjnego rozróżniania wymogów bezwzględnych (słowa kluczowe MUST, REQUIRED) od zaleceń opcjonalnych (SHOULD, RECOMMENDED), co zapobiega powstawaniu trudnych do zdiagnozowania problemów interoperacyjności w heterogenicznym środowisku sprzętowo-programowym wielobudynkowego kampusu.

Skróty użyte w tym slajdzie:
IETF (Internet Engineering Task Force) - Główna międzynarodowa organizacja standaryzująca protokoły internetowe.
RFC (Request for Comments) - Seria dokumentów technicznych i standardów publikowanych przez IETF.
ICANN (Internet Corporation for Assigned Names and Numbers) - Globalna instytucja nadzorująca przydział adresów IP i zarządzanie domenami TLD.
RIR (Regional Internet Registry) - Regionalny rejestr internetowy (np. RIPE NCC dla Europy) przydzielający bloki adresowe IP.

4/54

Strategia planowania przestrzeni adresowej w kampusie

Zasady inżynierskiego projektowania logicznej struktury adresowej.

Wykład 6: Strategia planowania przestrzeni adresowej w kampusie

  • Adresacja IP jako fundament logiczny: błędy popełnione na etapie planowania adresacji są kosztowne i trudne do naprawienia w działającej instytucji.
  • Kryteria dobrego planu adresowego:
  • Hierarchiczność: odzwierciedlenie struktury budynków i warstw sieci.
  • Skalowalność: zapewnienie w każdej podsieci rezerwy adresowej wynoszącej 30-50%.
  • Łatwość agregacji: możliwość łączenia tras na granicach budynków.
  • Czytelność: łatwa identyfikacja lokalizacji i funkcji urządzenia na podstawie adresu IP.
Hierarchiczna przestrzeń adresowa to zorganizowana struktura adresów IP, w której prefiksy są ściśle skorelowane z fizyczną topologią budynków oraz logicznym podziałem sieci VLAN, co ułatwia agregację tras i audyt ruchu.
Ilustracja techniczna do slajdu 4: Strategia planowania przestrzeni adresowej w kampusie

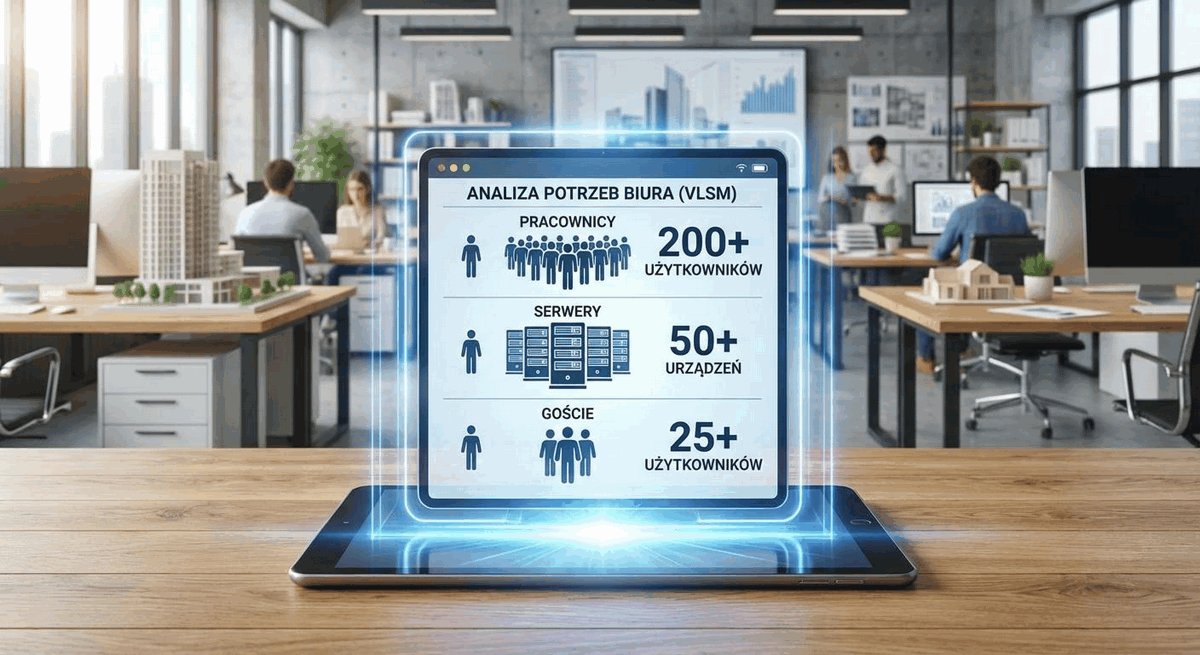
Projektowanie przestrzeni adresowej kampusu wymaga podejścia hierarchicznego i modułowego. Inżynier sieciowy musi podzielić dostępną pulę adresową z uwzględnieniem fizycznej topologii budynków, ról użytkowników (studenci, pracownicy, goście) oraz urządzeń specjalnych (telefonia VoIP, monitoring CCTV, IoT, serwery w serwerowni MDF).

Kluczową zasadą projektową jest zachowanie w każdej podsieci rezerwy adresowej na poziomie 30-50% oraz czytelna korelacja pomiędzy numerem VLAN a trzecim oktetem adresu IPv4, co ułatwia diagnostykę, tworzenie reguł ACL oraz agregację tras w protokołach routingu.

Błędy popełnione na etapie planowania adresacji niosą za sobą ogromny dług technologiczny i wymuszają w przyszłości bolesne procesy renumberingu (przepisywania adresów) w tysiącach urządzeń i systemów bazodanowych. Dlatego inżynier projektujący kampus musi zawsze uwzględniać współczynnik rozwoju (zapas minimum 30-50% wolnej przestrzeni adresowej na blok) oraz logiczną separację stref bezpieczeństwa zgodnie z koncepcją stref zaufania NIST SP 800-162.

Skróty użyte w tym slajdzie:
IPAM (IP Address Management) - Zintegrowane oprogramowanie i procedury zarządzania przestrzenią adresową IP, DHCP i DNS.
PoP (Point of Presence) - Fizyczny punkt styku sieci kampusowej z infrastrukturą operatora zewnętrznego.
ISP (Internet Service Provider) - Dostawca usług dostępu do publicznej sieci Internet.

5/54

Adresacja IPv4: adresy prywatne i publiczne

Standard IETF RFC 1918 i zasady separacji adresowej.

Wykład 6: Adresacja IPv4: adresy prywatne i publiczne

  • Globalny niedobór publicznych adresów IPv4: niemożność przydzielenia publicznego adresu IP każdemu komputerowi, telefonowi i drukarce na uczelni.
  • Standard RFC 1918: wyznaczenie specjalnych pul adresowych przeznaczonych wyłącznie do użytku w sieciach wewnętrznych (nieroutowalnych w publicznym Internecie).
  • Konieczność stosowania bram translacji adresów NAT/PAT na styku z operatorem internetowym.
  • Adresy publiczne: rezerwowane wyłącznie dla zewnętrznych interfejsów zapór ogniowych, routerów brzegowych BGP oraz publicznie dostępnych serwerów w strefie DMZ.
Przestrzeń adresowa RFC 1918 to zbiór wydzielonych zakresów adresów IPv4 nieroutowalnych w globalnym Internecie, wykorzystywanych do adresowania stacji kampusowych za zaporami z mechanizmem NAT/NAPT.
Ilustracja techniczna do slajdu 5: Adresacja IPv4: adresy prywatne i publiczne

W warstwie sieciowej IPv4 obowiązuje ścisły podział na pule adresów publicznych (routowalnych globalnie w Internecie) oraz prywatnych (przeznaczonych do użytku w sieciach lokalnych). Z uwagi na wyczerpanie publicznej puli IPv4 w rejestrze RIPE NCC, w kampusach stacje robocze otrzymują wyłącznie adresację prywatną.

Dostęp użytkowników do sieci Internet realizowany jest za pośrednictwem translacji adresów NAT/NAPT (Network Address and Port Translation) na zaporach brzegowych NGFW. Adresy publiczne rezerwowane są wyłącznie dla zewnętrznych interfejsów routerów brzegowych oraz publicznie dostępnych serwerów uczelnianych w strefie DMZ.

Konieczność stosowania mechanizmu translacji adresów NAT/PAT na styku kampusu z siecią operatorską tworzy asymetrię komunikacyjną, która komplikuje działanie połączeń bezpośrednich peer-to-peer oraz protokołów telefonii VoIP (np. SIP). Z tego względu uczelnie starają się zachować przydzielone historycznie pule adresów publicznych dla serwerów udostępniających usługi na zewnątrz, podczas gdy stacje robocze i urządzenia studentów funkcjonują w przestrzeni prywatnej.

Skróty użyte w tym slajdzie:
IANA (Internet Assigned Numbers Authority) - Jednostka odpowiedzialna za globalną alokację adresacji IP i numerów portów.
NAT (Network Address Translation) - Mechanizm tłumaczenia prywatnych adresów IP na publiczne adresy routowalne (RFC 1631 / RFC 3022).
PAT (Port Address Translation) - Odmiana NAT (tzw. NAT Overload) mapująca wiele prywatnych adresów na pojedynczy adres publiczny za pomocą portów L4.

6/54

Analiza zakresów prywatnych RFC 1918

Dobór odpowiedniej puli adresowej dla skali kampusu.

Wykład 6: Analiza zakresów prywatnych RFC 1918

  • Pula 10.0.0.0/8 (od 10.0.0.0 do 10.255.255.255): 16 777 216 adresów; optymalny wybór dla średnich i dużych sieci kampusowych, pozwala na łatwy podział hierarchiczny.
  • Pula 172.16.0.0/12 (od 172.16.0.0 do 172.31.255.255): 1 048 576 adresów (16 bloków /16); często stosowana w modułach serwerowych i strefach DMZ.
  • Pula 192.168.0.0/16 (od 192.168.0.0 do 192.168.255.255): 65 536 adresów (256 bloków /24); popularna w małych sieciach biurowych i domowych, niezalecana dla dużych kampusów z powodu braku elastyczności.
  • Rekomendacja inżynierska: oparcie całej adresacji wewnętrznej kampusu na bloku 10.0.0.0/8.
Pula prywatna 10.0.0.0/8 zapewnia 16,7 miliona adresów i jest podstawą projektowania sieci kampusowych, umożliwiając intuicyjne mapowanie drugiego oktetu na budynek, a trzeciego na numer wirtualnej sieci VLAN.
Ilustracja techniczna do slajdu 6: Analiza zakresów prywatnych RFC 1918

Standard RFC 1918 definiuje trzy bloki adresów prywatnych: klasę A (10.0.0.0/8 - 16,7 mln adresów), klasę B (172.16.0.0/12 - 1,04 mln adresów) oraz klasę C (192.168.0.0/16 - 65,5 tys. adresów). W kampusach najczęściej stosuje się blok 10.0.0.0/8.

Blok 10.0.0.0/8 daje projektantowi pełną swobodę w budowie czytelnej struktury: drugi oktet może wskazywać konkretny budynek lub kampus filialny (np. 10.15.0.0 dla Wydziału Informatyki), trzeci numer sieci VLAN, a czwarty konkretnego hosta.

Wybór bloku 10.0.0.0/8 jest powszechnym standardem w dużych sieciach akademickich, gdyż pozwala na zakodowanie w drugim i trzecim oktecie czytelnych identyfikatorów lokalizacji i funkcji (np. 10.budynek.vlan.host). Zapobiega to nakładaniu się adresacji przy łączeniu filii uczelni przez tunele VPN oraz ułatwia tworzenie przejrzystych reguł na zaporach sieciowych bez konieczności rozdrabniania wpisów filtrujących.

Skróty użyte w tym slajdzie:
RFC 1918 (Address Allocation for Private Internets) - Standard IETF definiujący prywatne pule adresowe: 10.0.0.0/8, 172.16.0.0/12 oraz 192.168.0.0/16.
CGNAT (Carrier-Grade NAT) - Adresacja z prefiksu 100.64.0.0/10 (RFC 6598) wykorzystywana przez operatorów do translacji wielopoziomowej.

7/54

Ograniczenia tradycyjnego podziału na równe podsieci (FLSM)

Nieefektywność sztywnego podziału przestrzeni adresowej.

Wykład 6: Ograniczenia tradycyjnego podziału na równe podsieci (FLSM)

  • FLSM (Fixed Length Subnet Mask): podział sieci na podsieci o identycznej, stałej długości maski (np. dzielenie całej uczelni na podsieci /24 - 254 adresy).
  • Problem marnotrawstwa adresów: łącze punkt-punkt między dwoma routerami potrzebuje tylko 2 adresów IP, ale przy masce /24 marnuje 252 adresy.
  • Problem niewystarczającego rozmiaru: aula dla 400 studentów nie mieści się w podsieci /24 i wymaga podziału na dwa VLAN-y.
  • Wniosek: sztywny podział FLSM prowadzi do szybkiego wyczerpania przestrzeni adresowej i chaosu projektowego.
Fixed Length Subnet Masking (FLSM) to klasyczna metoda podziału sieci na równe podsieci, która w zróżnicowanym kampusie powoduje znaczne marnotrawstwo adresów na małych łączach tranzytowych.
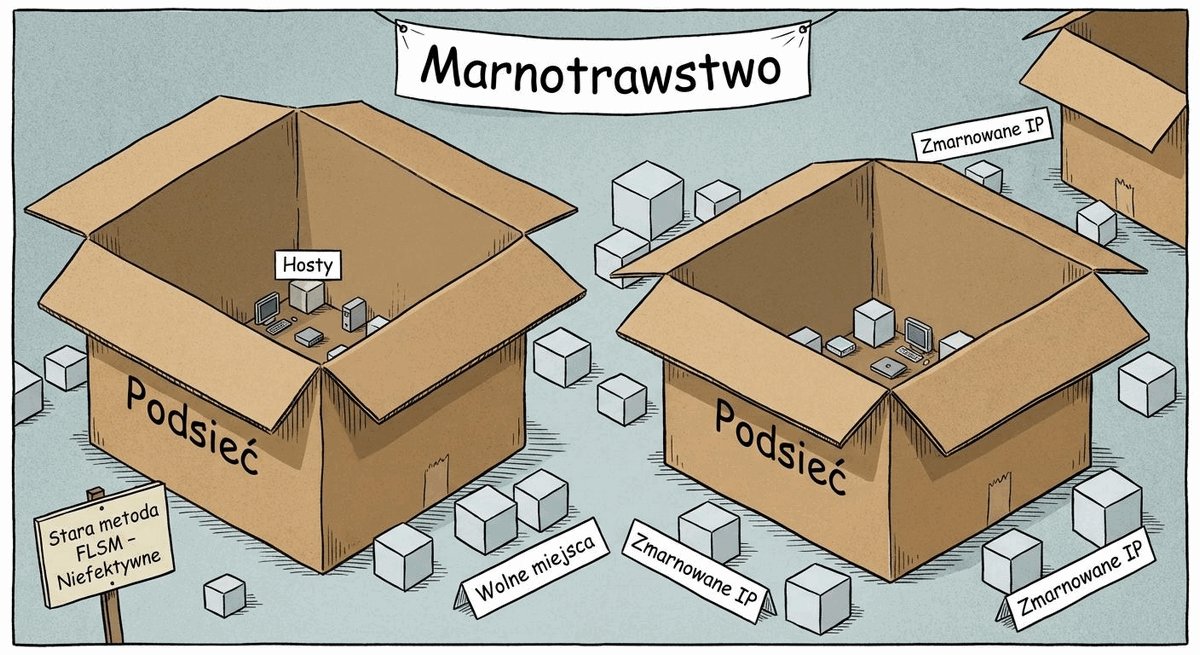
Ilustracja techniczna do slajdu 7: Ograniczenia tradycyjnego podziału na równe podsieci (FLSM)

Tradycyjny podział sieci za pomocą masek o stałej długości (FLSM - Fixed Length Subnet Masking) polega na dzieleniu całej przestrzeni adresowej na podsieci o identycznym rozmiarze. W zróżnicowanym środowisku kampusowym prowadzi to do marnotrawstwa adresów.

Przykładowo, przypisanie maski /24 do łącza punkt-punkt między dwoma routerami szkieletowymi zużywa 256 adresów IP, z których wykorzystywane są zaledwie dwa. Z kolei dla auli wykładowej z 400 studentami podsieć /24 okazuje się zbyt mała, wymuszając podział użytkowników na kilka segmentów.

Stosowanie sztywnego podziału FLSM prowadzi do nieefektywnych sytuacji projektowych, w których łącze punkt-punkt (Point-to-Point) spinające dwa routery otrzymuje podsieć z maską /24 rezerwującą 254 adresy hostów, z których wykorzystywane są zaledwie dwa. W skali kampusu z dziesiątkami połączeń międzyprzełącznikowych oznacza to błyskawiczne wyczerpanie dostępnej puli adresowej i zmusza do sztucznego mnożenia domen sieciowych.

Skróty użyte w tym slajdzie:
FLSM (Fixed Length Subnet Masking) - Podział sieci na podsieci o jednakowym, sztywno określonym rozmiarze i masce.
Broadcast (Directed Broadcast) - Pakiet rozgłoszeniowy skierowany do wszystkich hostów w określonej podsieci logicznej.

8/54

Podział na podsieci o zmiennej długości maski (VLSM)

Precyzyjne dopasowanie rozmiaru podsieci do realnych wymagań.

Wykład 6: Podział na podsieci o zmiennej długości maski (VLSM)

  • Technika VLSM (Variable Length Subnet Masking): możliwość stosowania masek o różnej długości w obrębie tej samej przestrzeni adresowej.
  • Zasada projektowa: wielkość podsieci dopasowujemy ściśle do planowanej liczby urządzeń z uwzględnieniem rezerwy.
  • Typowe maski stosowane w sieci kampusowej:
  • Maska /31 (2 adresy) lub /30 (4 adresy, 2 użyteczne): łącza punkt-punkt między przełącznikami i routerami L3 (RFC 3021).
  • Maska /28 (14 hostów) lub /27 (30 hostów): małe podsieci serwerów zarządzających i drukarek.
  • Maska /24 (254 hosty): standardowe laboratoria komputerowe i działy administracji.
  • Maska /22 (1022 hosty) lub /21 (2046 hostów): rozległe sieci bezprzewodowe Wi-Fi w audytoriach i akademikach.
Variable Length Subnet Masking (VLSM) to technika podziału przestrzeni adresowej na podsieci o zróżnicowanych długościach masek, dopasowująca rozmiar segmentu dokładnie do liczby wymaganych stacji roboczych.
Ilustracja techniczna do slajdu 8: Podział na podsieci o zmiennej długości maski (VLSM)

Wdrożenie techniki masek o zmiennej długości (VLSM - Variable Length Subnet Masking) pozwala inżynierowi na precyzyjne dopasowanie rozmiaru każdej podsieci do rzeczywistych wymagań danego segmentu. Większe bloki (np. /23 - 512 adresów) przeznacza się dla aul i sieci Wi-Fi, a mniejsze (/28, /29) dla stref serwerowych.

Warunkiem koniecznym stosowania VLSM jest obsługa bezklasowych protokołów routingu (Classless Routing Protocols, takich jak OSPFv2, IS-IS lub BGP-4), które przesyłają informacje o masce podsieci w swoich komunikatach aktualizacyjnych.

Technika VLSM wymaga stosowania protokołów routingu bezklasowego (Classless Routing Protocols, takich jak OSPFv2, IS-IS czy EIGRP), które w swoich komunikatach aktualizacyjnych przesyłają informacje o masce podsieci. Dzięki temu inżynier może precyzyjnie dobrać maskę do realnego zapotrzebowania: od maski /30 lub /31 dla łączy tranzytowych, przez /28 dla serwerów wydziałowych, aż po /22 dla rozległych sieci bezprzewodowych Wi-Fi w akademikach.

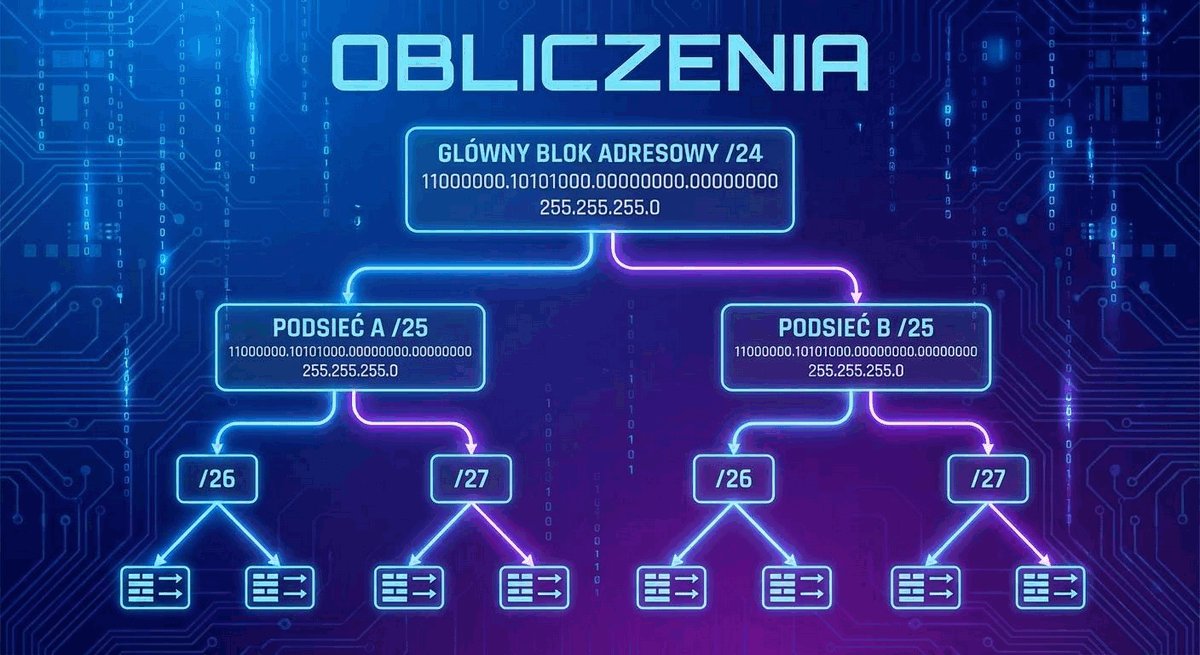
W procesie projektowania przestrzeni adresowej VLSM inżynierowie posługują się binarnym drzewem podziału, co pozwala na wizualizację i eliminację kolizji prefiksów sieciowych. Przydzielając podsieci w naturalnym porządku potęg dwójki, uzyskujemy spójną strukturę bloków adresowych, która w przyszłości ułatwia wdrażanie zaawansowanych reguł kontroli dostępu na zaporach sieciowych oraz umożliwia jednoznaczne mapowanie podsieci na identyfikatory VLAN w kampusie.

Skróty użyte w tym slajdzie:
Prefix (Subnet Prefix) - Długość maski podsieci zapisywana w notacji CIDR po znaku ukośnika (np. /24).
Host (IP Host) - Węzeł końcowy w sieci IP posiadający unikalny adres interfejsu.

9/54

Przykład inżynierski projektu VLSM dla wydziału uczelnianego

Krok po kroku: od kalkulacji zapotrzebowania do przydziału masek.

Wykład 6: Przykład inżynierski projektu VLSM dla wydziału uczelnianego

  • Dostępna pula dla budynku wydziału: blok 10.15.0.0/20 (łącznie 4096 adresów IP).
  • Krok 1: uporządkowanie wymagań malejąco według liczby hostów:
  • Sieć Wi-Fi studencka: zapotrzebowanie na 800 hostów, przydział podsieci /22 (1024 adresy): 10.15.0.0/22.
  • Pokoje w akademiku: zapotrzebowanie na 450 hostów, przydział podsieci /23 (512 adresów): 10.15.4.0/23.
  • Sale laboratoryjne (4 sale po 30 komputerów): zapotrzebowanie na 4 × 30 hostów, 4 podsieci /26 (po 64 adresy): 10.15.6.0/26 do 10.15.6.192/26.
  • Administracja i dziekanat: 50 hostów, podsieć /26: 10.15.7.0/26.
  • Telefonia VoIP: 100 aparatów, podsieć /25 (128 adresów): 10.15.7.128/25.
  • Łącza dosyłowe L3: 4 łącza punkt-punkt, 4 podsieci /31: 10.15.8.0/31 do 10.15.8.6/31.
  • Pozostała przestrzeń (od 10.15.9.0 do 10.15.15.255) pozostaje rezerwą na przyszły rozwój.
Projektowanie VLSM wymaga uszeregowania segmentów malejąco według zapotrzebowania na hosty, co zapobiega fragmentacji przestrzeni adresowej i zapewnia optymalne wykorzystanie dostępnych bloków potęg dwójki.
Ilustracja techniczna do slajdu 9: Przykład inżynierski projektu VLSM dla wydziału uczelnianego

Proces planowania podsieci VLSM rozpoczyna się od uszeregowania wymagań adresowych malejąco: od największych grup odbiorców do najmniejszych. Pozwala to na optymalne upakowanie bloków bez powstawania luk adresowych (tzw. fragmentacji przestrzeni).

W kolejnym etapie projektant rezerwuje ciągłe bloki potęg dwójki dla każdego segmentu, pamiętając o odliczeniu dwóch adresów (adresu sieci i adresu broadcast w tradycyjnych podsieciach) oraz zachowaniu rezerwy na przyszły rozwój stacji roboczych i urządzeń mobilnych.

Kluczową zasadą algorytmu VLSM jest sortowanie podsieci w kolejności malejącej według liczby wymaganych adresów IP przed rozpoczęciem procesu alokacji. Taka kolejność zapobiega powstawaniu nieciągłych fragmentów wolnej przestrzeni adresowej i gwarantuje, że adres bazowy każdej kolejnej podsieci będzie naturalnie wyrównany do granicy binarnej wyznaczonej przez jej maskę, co eliminuje błędy nakładania się zakresów (Subnet Overlap).

Skróty użyte w tym slajdzie:
P2P (Point-to-Point) - Łącze transmisyjne dedykowane bezpośrednio pomiędzy dwoma urządzeniami sieciowymi.
SVI (Switched Virtual Interface) - Wirtualny interfejs warstwy 3 na przełączniku wielowarstwowym reprezentujący daną podsieć.

10/54

Agregacja tras (Route Summarization / CIDR)

Redukcja tablic routingu dzięki hierarchicznej strukturze VLSM.

Wykład 6: Agregacja tras (Route Summarization / CIDR)

  • Zasada agregacji: przełącznik dystrybucyjny budynku rozgłasza do rdzenia kampusu tylko jeden wpis trasy: `10.15.0.0/20`.
  • Rdzeń sieci nie musi wiedzieć o istnieniu kilkunastu małych podsieci wewnątrz budynku.
  • Korzyści wydajnościowe: zmniejszenie rozmiaru tablic FIB w przełącznikach szkieletowych, szybkie wyszukiwanie tras w pamięci TCAM.
  • Izolacja awarii (Route Dampening): wahania stanu pojedynczego interfejsu laboratoryjnego w budynku nie powodują przeliczania SPF w rdzeniu całego kampusu.
  • Zalecenie inżynierskie - wdrożenie RFC 3021: na łączach szkieletowych między routerami oraz między przełącznikiem dystrybucyjnym a rdzeniem standardem jest stosowanie prefiksów 31-bitowych (maska `255.255.255.254`). W podsieci `/31` występują dokładnie dwa adresy hostów bez rezerwowania adresu sieci i broadcastu, oszczędzając 50% adresacji w porównaniu z podsiecią `/30`.
Zgodnie ze standardem IETF RFC 3021 na łączach punkt-punkt (P2P) stosuje się maski 31-bitowe (/31), co eliminuje rezerwację adresu sieci i adresu rozgłoszeniowego, oszczędzając 50% adresacji w porównaniu z tradycyjnymi podsieciami /30.
Ilustracja techniczna do slajdu 10: Agregacja tras (Route Summarization / CIDR)

Hierarchiczna struktura podsieci VLSM umożliwia realizację agregacji tras (Route Summarization / CIDR). Przełącznik dystrybucyjny budynku rozgłasza do rdzenia sieci wyłącznie pojedynczy prefiks zbiorczy (np. 10.15.0.0/20) reprezentujący wszystkie podsieci wewnętrzne danego obiektu.

Dla łączy punkt-punkt (P2P) łączących urządzenia L3 standardem inżynierskim jest wdrożenie specyfikacji RFC 3021 (maska /31: 255.255.255.254). W podsieci /31 występują dokładnie dwa adresy hostów bez rezerwowania adresu sieci i broadcastu, co oszczędza 50% adresów w porównaniu z historycznymi maskami /30.

Skuteczna agregacja tras w węzłach dystrybucyjnych odciąża pamięć operacyjną przełączników rdzeniowych i przyspiesza konwergencję routingu. Co równie istotne, podsumowanie prefiksów ukrywa lokalne niestabilności łączy (flapping interfejsu w szafie dostępowej nie powoduje rozsyłania pakietów LSA w całym kampusie), tworząc naturalną barierę tłumiącą oscylacje tras w protokole OSPF.

Skróty użyte w tym slajdzie:
RFC 3021 (Using 31-Bit Prefixes on IPv4 Point-to-Point Links) - Standard IETF dopuszczający stosowanie masek /31 na łączach punkt-punkt bez adresu sieci i rozgłoszeniowego.
Supernetting - Agregacja wielu przyległych podsieci w jedną wspólną trasę nadrzędną.

11/54

Wyczerpanie adresacji IPv4 i konieczność wdrożenia IPv6

Uwarunkowania strategiczne wymuszające obsługę protokołu IPv6.

Wykład 6: Wyczerpanie adresacji IPv4 i konieczność wdrożenia IPv6

  • Oficjalne wyczerpanie puli adresów IPv4 w rejestrze RIPE NCC (Europa) w listopadzie 2019 roku.
  • Zalecenia unijne i krajowe: instytucje publiczne i uczelnie powinny zapewnić dostępność swoich usług w protokole IPv6.
  • Wzrost udziału urządzeń mobilnych i połączeń komórkowych natywnie obsługujących IPv6.
  • Eliminacja konieczności stosowania translacji NAT: przywrócenie zasady architektury Internetu, czyli bezpośredniej łączności koniec-w-koniec (End-to-End Connectivity).
Wyczerpanie publicznej przestrzeni IPv4 w rejestrze RIPE NCC wymusza strategiczne wdrażanie protokołu IPv6 w modelu Dual-Stack, przywracającego bezpośrednią łączność End-to-End bez narzutu translacji NAT.
Ilustracja techniczna do slajdu 11: Wyczerpanie adresacji IPv4 i konieczność wdrożenia IPv6

Oficjalne wyczerpanie puli wolnych adresów IPv4 w rejestrach RIR (w tym europejskim RIPE NCC) wymusza strategiczną migrację w stronę protokołu IPv6. Chociaż mechanizmy NAT/NAPT przedłużyły żywotność IPv4, naruszają one zasadę architektury Internetu - bezpośrednią łączność End-to-End.

Wdrożenie protokołu IPv6 eliminuje konieczność stosowania translacji adresów, upraszcza proces routingu, przywraca pełną dwukierunkową widoczność usług oraz zapewnia niemal nieograniczoną przestrzeń adresową dla rozwoju uczelnianych projektów badawczych i Internetu Rzeczy (IoT).

Mechanizmy takie jak Carrier-Grade NAT (CGNAT) stosowane przez dostawców Internetu są jedynie protezą wydłużającą żywotność IPv4, naruszającą fundamentalną dla architektury Internetu zasadę łączności koniec-do-końca (End-to-End Principle). Wdrożenie protokołu IPv6 w kampusie akademickim jest wymogiem cywilizacyjnym, umożliwiającym prowadzenie zaawansowanych badań naukowych, obsługę miliardów urządzeń Internetu Rzeczy (IoT) oraz bezpośrednią komunikację bez pośrednictwa translacji stanowych.

Skróty użyte w tym slajdzie:
RIPE NCC (Réseaux IP Européens Network Coordination Centre) - Regionalny rejestr internetowy obsługujący Europę, Bliski Wschód i Azję Centralną.
Dual-Stack (Dual-Stack Architecture) - Równoległe wdrażanie stosów IPv4 i IPv6 na wszystkich urządzeniach i interfejsach w sieci.

12/54

Architektura protokołu IPv6 w kampusie

Struktura zapisu, długość adresu i zasady reprezentacji.

Wykład 6: Architektura protokołu IPv6 w kampusie

  • Długość adresu: 128 bitów (w porównaniu z 32 bitami w IPv4), co daje teoretycznie 3,4 × 10^38 unikalnych adresów.
  • Brak transmisji rozgłoszeniowej (No Broadcast): w architekturze IPv6 nie używa się transmisji rozgłoszeniowej; komunikacja kontrolna i adresowa opiera się na grupach Multicast (w tym Solicited-Node Multicast).
  • Zapis szesnastkowy: 8 grup po 4 cyfry heksadecymalne (hextety) rozdzielone dwukropkami, np. `2001:0db8:85a3:0000:0000:8a2e:0370:7334`.
  • Stały nagłówek IPv6: uproszczona struktura o długości 40 bajtów; brak sumy kontrolnej w nagłówku przyspiesza przetwarzanie przez routery.
  • Brak transmisji rozgłoszeniowej: broadcast zastąpiono grupami multicast i anycast.
Protokół IPv6 wykorzystuje 128-bitową przestrzeń adresową i nie używa transmisji typu Broadcast, zastępując ją wyspecjalizowaną komunikacją grupową Multicast i protokołem odkrywania sąsiadów NDP.
Ilustracja techniczna do slajdu 12: Architektura protokołu IPv6 w kampusie

Adres protokołu IPv6 ma długość 128 bitów (czterokrotnie więcej niż IPv4), co daje przestrzeń około 3,4 × 10^38 unikalnych adresów. Zapisywany jest w postaci 8 grup szesnastkowych (tzw. hextetów) oddzielonych dwukropkami, np. 2001:0db8:85a3:0000:0000:8a2e:0370:7334.

Kluczową cechą architektury IPv6 jest brak transmisji rozgłoszeniowej (Broadcast). Operacje realizowane dawniej rozgłoszeniowo (np. protokół ARP) zostały zastąpione celowanymi komunikatami Multicast (w tym Solicited-Node Multicast) protokołu NDP.

Uproszczenie nagłówka podstawowego IPv6 do stałej długości 40 bajtów oraz usunięcie pola sumy kontrolnej nagłówka pozwoliło na radykalne przyspieszenie przetwarzania pakietów w sprzętowych układach ASIC routerów szkieletowych. Ewentualne funkcje dodatkowe, takie jak routing źródłowy czy fragmentacja, realizowane są za pomocą elastycznego łańcucha nagłówków rozszerzeń (Extension Headers) analizowanych tylko wtedy, gdy jest to bezwzględnie wymagane.

Skróty użyte w tym slajdzie:
NDP (Neighbor Discovery Protocol) - Protokół ICMPv6 (RFC 4861) zastępujący mechanizmy ARP, Router Discovery i Redirect w sieciach IPv6.
EUI-64 (Extended Unique Identifier 64) - Metoda automatycznego generowania 64-bitowego identyfikatora interfejsu IPv6 z 48-bitowego adresu MAC.

13/54

Reguły skracania zapisu adresu IPv6

Zasady czytelnej reprezentacji adresów 128-bitowych.

Wykład 6: Reguły skracania zapisu adresu IPv6

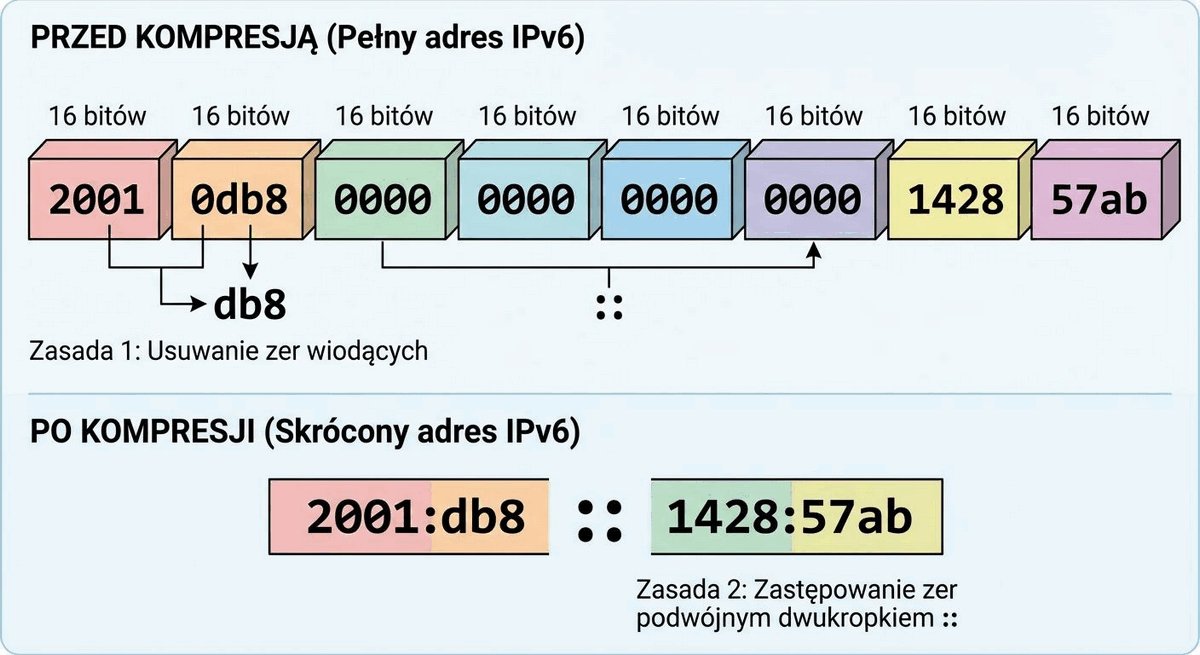
  • Reguła 1: pomijanie zer wiodących w dowolnym hextecie (np. :0042: zapisujemy jako :42:, :0000: zapisujemy jako :0:).
  • Reguła 2: zastąpienie najdłuższego ciągu sąsiadujących hextetów składających się z samych zer podwójnym dwukropkiem ::.
  • Ograniczenie reguły 2: podwójny dwukropek :: może wystąpić w danym adresie tylko raz (w przeciwnym razie zapis byłby niejednoznaczny).
  • Przykład skracania: adres `2001:0db8:0000:0000:0000:0000:0000:0001` po skróceniu przyjmuje postać `2001:db8::1`.
Zgodnie ze specyfikacją RFC 5952 zapis adresu IPv6 upraszcza się przez usuwanie wiodących zer oraz pojedyncze zastąpienie najdłuższego ciągu zer symbolem podwójnego dwukropka (::).
Ilustracja techniczna do slajdu 13: Reguły skracania zapisu adresu IPv6

W celu zwiększenia czytelności zapisu 128-bitowych adresów IPv6 standard RFC 5952 wprowadza dwie reguły kompresji: usuwanie wiodących zer w każdym hextecie (np. przekształcenie :0042: w :42:) oraz zastąpienie pojedynczego, najdłuższego ciągu sąsiadujących pól zerowych podwójnym dwukropkiem (::).

Podwójny dwukropek może wystąpić w zapisie adresu dokładnie jeden raz, aby uniknąć niejednoznaczności przy rekonstrukcji pełnego adresu 128-bitowego. Pozwala to na zwięzłą reprezentację adresów pętli zwrotnej (::1) czy prefiksów tras domyślnych (::/0).

Zgodnie ze standardem RFC 5952, ujednolicającym reguły prezentacji tekstowej IPv6, podwójny dwukropek '::' może wystąpić w zapisie adresu tylko raz i powinien zastępować najdłuższy ciąg zer lub pierwszy ciąg o równej długości. Ponadto litery w zapisie szesnastkowym należy bezwzględnie zapisywać małymi znakami (np. 2001:db8::1 zamiast 2001:DB8::1), co ułatwia automatyczne parsowanie konfiguracji i wyszukiwanie w uczelnianych systemach monitoringu.

Skróty użyte w tym slajdzie:
Hex (Hexadecimal) - Szesnastkowy system liczbowy wykorzystywany do kompaktowego zapisu adresów IPv6.
Hextet (Hextet / Quibble) - 16-bitowa grupa cyfr szesnastkowych w adresie IPv6 oddzielana dwukropkami.

14/54

Typy adresów IPv6 w sieci kampusowej

Klasyfikacja zakresów adresowych według przeznaczenia.

Wykład 6: Typy adresów IPv6 w sieci kampusowej

  • Global Unicast Address (GUA): publiczne, globalnie routowalne adresy internetowe (odpowiednik publicznych IPv4); zakres `2000::/3`.
  • Unique Local Address (ULA): prywatne adresy lokalne dla instytucji (odpowiednik RFC 1918 w IPv4); zakres `fc00::/7` (w praktyce `fd00::/8`).
  • Link-Local Address (LLA): adresy lokalne dla pojedynczego łącza; zakres `fe80::/10`; automatycznie generowane na każdym interfejsie IPv6, wykorzystywane do protokołów sąsiedztwa i routingu.
  • Adres pętli zwrotnej (Loopback): `::1/128`.
  • Adresy grupowe Multicast: zakres `ff00::/8` (np. `ff02::1` wszystkie węzły, `ff02::2` wszystkie routery).
Typy adresów IPv6 w kampusie obejmują adresy globalne (GUA, prefiks 2000::/3), adresy lokalne unikalne (ULA, prefiks fc00::/7) oraz automatycznie konfigurowane adresy łącza lokalnego (Link-Local, fe80::/10) niezbędne dla protokołów routingu i FHRP.
Ilustracja techniczna do slajdu 14: Typy adresów IPv6 w sieci kampusowej

Przestrzeń adresowa IPv6 dzieli się na wyspecjalizowane kategorie: adresy globalne (GUA - Global Unicast Address, prefiks 2000::/3, routowalne w Internecie), adresy lokalne unikalne (ULA - Unique Local Address, prefiks fc00::/7, odpowiednik adresów prywatnych) oraz adresy łącza lokalnego (Link-Local, fe80::/10).

Adresy Link-Local są generowane automatycznie na każdym aktywnym interfejsie IPv6 i zachowują ważność wyłącznie w obrębie pojedynczego łącza L2. Są wykorzystywane przez protokoły routingu dynamicznego (OSPFv3, BGP) oraz protokoły redundancji bramy FHRP (VRRPv3).

W środowisku IPv6 całkowicie zrezygnowano z transmisji rozgłoszeniowej (Broadcast), zastępując ją wysoce efektywną transmisją wieloadresową (Multicast) z dedykowanymi adresami grup Solicited-Node Multicast. Pozwala to na drastyczne odciążenie kart sieciowych hostów, które sprzętowo filtrują niechciany ruch na poziomie filtrów MAC karty, zamiast przetwarzać każde zapytanie w przerwaniach procesora stacji roboczej.

Skróty użyte w tym slajdzie:
GUA (Global Unicast Address) - Globalny, publicznie routowalny adres IPv6 z prefiksu 2000::/3 (odpowiednik publicznego IPv4).
ULA (Unique Local Address) - Prywatny adres IPv6 z prefiksu fc00::/7 (RFC 4193), odpowiednik adresów RFC 1918 w IPv4.
Link-Local (Link-Local Address) - Nieroutowalny adres IPv6 z prefiksu fe80::/10 obowiązujący wyłącznie w ramach pojedynczego łącza fizycznego.

15/54

Planowanie hierarchicznego przydziału prefiksów IPv6 w kampusie

Standardowy model podziału przestrzeni adresowej na uczelni.

Wykład 6: Planowanie hierarchicznego przydziału prefiksów IPv6 w kampusie

  • Typowy przydział od operatora ISP lub rejestru RIPE: prefiks `/48` dla instytucji (np. `2001:db8:acad::/48`).
  • Pole identyfikatora podsieci (Subnet ID): 16 bitów wewnątrz prefiksu `/48` daje uczelni do dyspozycji dokładnie 65 536 niezależnych podsieci.
  • Złota zasada IPv6: każda podsieć użytkowników i każdy VLAN otrzymuje prefiks `/64` (ponad 18 trylionów adresów na VLAN).
  • Przykład hierarchii: `2001:db8:acad:12af::/64` (gdzie 1 = budynek, 2 = piętro, a = funkcja sieci).
  • Identyfikator interfejsu (Interface ID): 64 bity generowane dynamicznie przez stację (SLAAC) lub przydzielane z DHCPv6.
Planowanie adresacji IPv6 zakłada przydział bloku /48 dla całej instytucji, z którego wyodrębnia się podsieci o stałej długości prefiksu /64 dla każdego segmentu użytkowników, co spełnia wymagania mechanizmów autokonfiguracji.
Ilustracja techniczna do slajdu 15: Planowanie hierarchicznego przydziału prefiksów IPv6 w kampusie

Standardowy plan przydziału adresacji IPv6 dla instytucji akademickiej zakłada otrzymanie od rejestru RIPE NCC lub operatora nadrzędnego (np. konsorcjum PIONIER) bloku o prefiksie /48. Uczelnia posiada wówczas 16 bitów na własne podsieci (bity 49-64), co pozwala na utworzenie 65 536 niezależnych sieci /64.

Zgodnie z międzynarodowymi standardami każda końcowa sieć LAN użytkowników w IPv6 musi posiadać prefiks o długości dokładnie /64, co wynika z wymogów mechanizmu bezstanowej autokonfiguracji SLAAC, który rezerwuje dolne 64 bity adresu na identyfikator interfejsu (Interface ID).

Kluczowym atutem 16-bitowego identyfikatora podsieci (Subnet ID) w prefiksie /48 przydzielanym uczelni przez RIR (np. RIPE NCC) jest możliwość zaalokowania do 65 536 niezależnych podsieci /64. Inżynier może podzielić tę przestrzeń heksadecymalnie na budynki, piętra i typy usług, rezerwując dla każdej podsieci użytkowej dokładnie prefiks /64, co gwarantuje pełną zgodność z mechanizmami autokonfiguracji SLAAC i chroni przed fragmentacją puli adresowej.

Skróty użyte w tym slajdzie:
NTP (Network Time Protocol) - Protokół precyzyjnej synchronizacji czasu zegarów w sieciach IP (RFC 5905).
BGP (Border Gateway Protocol) - Protokół wektora ścieżki (RFC 4271) realizujący routing pomiędzy systemami autonomicznymi w Internecie.

16/54

Autokonfiguracja IPv6: bezstanowy mechanizm SLAAC

Samoczynna konfiguracja stacji bez konieczności instalowania serwera DHCP.

Wykład 6: Autokonfiguracja IPv6: bezstanowy mechanizm SLAAC

  • SLAAC (Stateless Address Autoconfiguration): podstawowy mechanizm protokołu IPv6 opisany w RFC 4862.
  • Działanie: router okresowo rozgłasza komunikat Router Advertisement (RA) informujący stacje o prefiksie sieciowym (np. `2001:db8:acad:10::/64`) oraz o adresie routera pełniącego rolę bramy.
  • Generowanie adresu przez stację roboczą: host pobiera prefiks /64 z komunikatu RA i dołącza do niego własny 64-bitowy identyfikator interfejsu.
  • Generowanie Interface ID: metoda EUI-64 (na podstawie adresu MAC) lub metoda losowa (RFC 4941, Privacy Extensions), chroniąca przed śledzeniem użytkownika w sieci.
Stateless Address Autoconfiguration (SLAAC, RFC 4862) to autonomiczny mechanizm IPv6 pozwalający stacji na samodzielne wygenerowanie adresu globalnego na podstawie prefiksu odebranego w anonsie routera (RA).
Ilustracja techniczna do slajdu 16: Autokonfiguracja IPv6: bezstanowy mechanizm SLAAC

Bezstanowa autokonfiguracja adresów (SLAAC - Stateless Address Autoconfiguration, RFC 4862) to mechanizm IPv6 pozwalający stacji roboczej na samodzielne wygenerowanie własnego globalnego adresu IP natychmiast po podłączeniu do sieci, bez potrzeby odpytywania serwera DHCP.

Stacja nasłuchuje cyklicznych komunikatów anonsowania routera (RA - Router Advertisement) nadawanych przez bramę domyślną, pobiera z nich 64-bitowy prefiks podsieci, a następnie dołącza do niego własny 64-bitowy identyfikator interfejsu generowany losowo (RFC 7217) lub za pomocą algorytmu EUI-64.

Początkowo identyfikator interfejsu (Interface ID) w SLAAC był generowany na podstawie 48-bitowego adresu MAC w formacie EUI-64, co stwarzało poważne zagrożenie dla prywatności użytkowników, umożliwiając ich śledzenie w sieciach publicznych. Współczesne systemy operacyjne stosują rozszerzenia prywatności (RFC 4941) lub algorytmy semantycznie nieprzezroczystych identyfikatorów generowanych losowo (RFC 7217), co uniemożliwia korelację aktywności studenta z numerem fabrycznym jego karty sieciowej.

Skróty użyte w tym slajdzie:
RA (Router Advertisement) - Komunikat rozsyłany cyklicznie przez routery IPv6 informujący o prefiksie sieci, bramie i parametrach autokonfiguracji.
RS (Router Solicitation) - Komunikat wysyłany przez hosta IPv6 po włączeniu interfejsu z żądaniem natychmiastowego wysłania komunikatu RA.

17/54

Komunikaty protokołu ICMPv6 w SLAAC

Mechanizm dialogu między stacją a routerem bramy.

Wykład 6: Komunikaty protokołu ICMPv6 w SLAAC

  • Komunikat RS (Router Solicitation): wysyłany przez stację podczas jej uruchamiania na adres multicast `ff02::2` (wszystkie routery) z pytaniem o parametry podsieci.
  • Komunikat RA (Router Advertisement): odsyłany przez router na adres `ff02::1` (wszystkie węzły) zawierający prefiks, czas ważności i flagi konfiguracyjne.
  • Mechanizm DAD (Duplicate Address Detection): stacja przed użyciem wygenerowanego adresu wysyła zapytanie Neighbor Solicitation, aby upewnić się, czy inny host w podsieci nie używa już takiego samego adresu.
  • Brak konieczności utrzymywania stanu dzierżawy na routerze (rozwiązanie bezstanowe i bardzo skalowalne).
Protokół Neighbor Discovery (NDP, RFC 4861) zastępuje protokół ARP, wykorzystując komunikaty ICMPv6 Neighbor Solicitation (NS) oraz Neighbor Advertisement (NA) na adresy Solicited-Node Multicast.
Ilustracja techniczna do slajdu 17: Komunikaty protokołu ICMPv6 w SLAAC

Podstawą funkcjonowania SLAAC jest protokół ICMPv6 oraz mechanizm odkrywania sąsiadów (NDP - Neighbor Discovery Protocol, RFC 4861). Nowo podłączona stacja wysyła komunikat Router Solicitation (RS) na adres multicastowy wszystkich routerów ff02::2, żądając natychmiastowego anonsu RA.

Po wygenerowaniu adresu stacja wykonuje procedurę wykrywania duplikatów adresów (DAD - Duplicate Address Detection) za pomocą komunikatów Neighbor Solicitation (NS). Jeśli żadne urządzenie w segmencie nie zgłosi kolizji komunikatem NA, adres zostaje zatwierdzony jako unikalny i aktywny.

Integralnym elementem autokonfiguracji w IPv6 jest proces wykrywania duplikatów adresów (DAD - Duplicate Address Detection). Przed przypisaniem wygenerowanego adresu do interfejsu stacja wysyła zapytanie NS (Neighbor Solicitation) pod specjalny adres multicastowy Solicited-Node. Jeśli w określonym czasie nie nadejdzie odpowiedź NA (Neighbor Advertisement) od innego urządzenia, stacja uznaje adres za unikalny i aktywuje go w stosie sieciowym.

Skróty użyte w tym slajdzie:
NS (Neighbor Solicitation) - Komunikat ICMPv6 wysyłany w celu ustalenia adresu MAC sąsiada lub detekcji kolizji adresów (DAD).
NA (Neighbor Advertisement) - Komunikat ICMPv6 będący odpowiedzią na zapytanie NS lub rozgłaszający zmianę adresu MAC hosta.
DAD (Duplicate Address Detection) - Procedura weryfikacji unikalności wygenerowanego adresu IPv6 przed jego aktywacją na interfejsie.

18/54

Stanowy i bezstanowy protokół DHCPv6

Uzupełnienie mechanizmu SLAAC o centralne zarządzanie konfiguracją.

Wykład 6: Stanowy i bezstanowy protokół DHCPv6

  • Standard IETF RFC 8415: protokół DHCPv6.
  • Flagi w komunikatach RA sterujące zachowaniem klienta:
  • Flaga M (Managed Address Configuration): gdy ustawiona na 1, wymusza stanowy DHCPv6 (klient pobiera adres IP i wszystkie opcje bezpośrednio z serwera DHCPv6).
  • Flaga O (Other Configuration): gdy ustawiona na 1, stacja generuje adres przez SLAAC, ale opcje dodatkowe (DNS, domena) pobiera z bezstanowego serwera DHCPv6 (Stateless DHCPv6).
  • Zastosowanie stanowego DHCPv6 w kampusie: wymóg ścisłej ewidencji tego, który użytkownik otrzymał konkretny adres IP (kwestie rozliczalności i bezpieczeństwa).
Protokół DHCPv6 (RFC 8415) występuje w wariancie bezstanowym (dostarczanie opcji sieciowych obok SLAAC) oraz stanowym (pełna kontrola i rejestracja przydziału adresów IP przez centralny serwer).
Ilustracja techniczna do slajdu 18: Stanowy i bezstanowy protokół DHCPv6

W sieciach kampusowych IPv6 autokonfiguracja SLAAC jest często uzupełniana przez protokół DHCPv6 (RFC 8415). Wyróżnia się dwa tryby pracy: bezstanowy DHCPv6 (Stateless DHCPv6, flaga O=1 w komunikacie RA), gdzie stacja pobiera adres przez SLAAC, a z serwera DHCPv6 pobiera wyłącznie opcje dodatkowe (DNS, domenę).

W trybie stanowym DHCPv6 (Stateful DHCPv6, flaga M=1 w RA) serwer DHCPv6 przydziela stacjom pełne adresy IPv6 oraz rejestruje dzierżawy w bazie, przypominając działanie znane z IPv4. Zapewnia to ścisłą kontrolę audytową nad przydzielanymi zasobami w sieci uczelnianej.

Wybór trybu pracy protokołu DHCPv6 jest kontrolowany przez router za pomocą dwóch flag w nagłówku komunikatu RA: flagi M (Managed Address Configuration) oraz flagi O (Other Configuration). W trybie bezstanowym (flaga M=0, O=1) host pobiera prefiks sieciowy i generuje adres IP przez SLAAC, a z serwera DHCPv6 pobiera wyłącznie adresy rekurencyjnych serwerów DNS i domenę wyszukiwania. W trybie stanowym (flaga M=1) pełną odpowiedzialność za przydział adresu i rejestrację dzierżawy przejmuje serwer DHCPv6.

Skróty użyte w tym slajdzie:
DHCPv6 (Dynamic Host Configuration Protocol for IPv6) - Protokół stanowej lub bezstanowej konfiguracji parametrów sieciowych w IPv6 (RFC 8415).
M-Flag (Managed Address Configuration Flag) - Bit w komunikacie RA nakazujący klientom pobranie adresu IPv6 ze stanowego serwera DHCPv6.
O-Flag (Other Configuration Flag) - Bit w komunikacie RA informujący, że parametry dodatkowe (np. DNS) należy pobrać z bezstanowego DHCPv6.

19/54

Porównanie mechanizmów przydziału adresów w IPv4 i IPv6

Zestawienie różnic operacyjnych i inżynierskich.

Wykład 6: Porównanie mechanizmów przydziału adresów w IPv4 i IPv6

  • W IPv4: dominacja protokołu DHCPv4; brak natywnej bezstanowej autokonfiguracji (mechanizm APIPA 169.254.x.x jest jedynie rozwiązaniem awaryjnym bez dostępu do bramy).
  • W IPv6: elastyczność wyboru (SLAAC, Stateless DHCPv6, Stateful DHCPv6).
  • Wieloadresowość w IPv6: interfejs hosta posiada jednocześnie kilka adresów IPv6 (adres Link-Local, jeden lub więcej adresów GUA, adresy tymczasowe prywatności).
  • Równoległe wdrażanie (Dual-Stack): równoczesne uruchomienie stosu IPv4 i IPv6 na wszystkich interfejsach przełączników i stacji w okresie migracji.
Porównanie mechanizmów adresowania wykazuje przewagę IPv6 pod względem elastyczności (współistnienie SLAAC i DHCPv6, brak broadcastu) w porównaniu ze sztywnym, stanowym modelem DHCPv4.
Ilustracja techniczna do slajdu 19: Porównanie mechanizmów przydziału adresów w IPv4 i IPv6

Porównanie mechanizmów przydziału adresów wykazuje zasadnicze różnice pomiędzy generacjami protokołu IP. W IPv4 jedynym zautomatyzowanym standardem był stanowy protokół DHCP oparty na transmisji rozgłoszeniowej (Broadcast) i procedurze ARP.

W protokole IPv6 architektura oferuje wybór pomiędzy autonomicznym SLAAC, hybrydowym bezstanowym DHCPv6 oraz klasycznym stanowym DHCPv6. Komunikacja kontrolna opiera się wyłącznie na pakietach Multicast, a stacja może posiadać jednocześnie wiele prawidłowych adresów IPv6 na tym samym interfejsie fizycznym.

Wdrożenie IPv6 drastycznie upraszcza zarządzanie warstwą brzegową w kampusach akademickich, eliminując konieczność ciągłego monitorowania wyczerpywania się małych pul adresowych DHCPv4. Niemniej jednak w okresie koegzystencji obu protokołów administratorzy muszą utrzymywać podwójną infrastrukturę serwerową oraz podwójne tablice inspekcji bezpieczeństwa, co wymaga wysokiej dyscypliny operacyjnej i jednolitej telemetrii sieciowej.

Skróty użyte w tym slajdzie:
Multicast (Multicast Addressing) - Transmisja pakietów skierowana do wybranej grupy odbiorców (prefiksy 224.0.0.0/4 w IPv4 oraz ff00::/8 w IPv6).
Anycast (Anycast Addressing) - Transmisja pakietów do najbliższego topologicznie węzła spośród grupy współdzielącej ten sam adres IP.

20/54

Usługa dynamicznego przydziału adresów: protokół DHCPv4

Kluczowa usługa automatyzacji parametrów sieciowych stacji roboczych.

Wykład 6: Usługa dynamicznego przydziału adresów: protokół DHCPv4

  • Standard IETF RFC 2131: Dynamic Host Configuration Protocol.
  • Eliminacja ręcznej konfiguracji: automatyczne dostarczanie stacji adresu IP, maski podsieci, bramy domyślnej oraz adresów serwerów DNS.
  • Koncepcja dzierżawy (Lease): adres IP nie jest przydzielany na stałe, lecz wypożyczany na określony czas (Lease Time, typowo od kilku godzin do kilku dni).
  • Proces odnawiania dzierżawy: stacja wysyła zapytanie unicast o przedłużenie dzierżawy po upływie 50% czasu (T1) oraz zapytanie broadcast po 87,5% czasu (T2).
Dynamic Host Configuration Protocol (DHCPv4, RFC 2131) to usługa automatyzująca konfigurację IP urządzeń końcowych, eliminująca błędy ręcznego wprowadzania parametrów w rozległym kampusie.
Ilustracja techniczna do slajdu 20: Usługa dynamicznego przydziału adresów: protokół DHCPv4

Protokół dynamicznej konfiguracji węzłów IPv4 (DHCPv4 - Dynamic Host Configuration Protocol, RFC 2131) stanowi podstawową usługę infrastruktury kampusowej. Zwalnia administratorów z konieczności ręcznego konfigurowania parametrów sieciowych na tysiącach komputerów, laptopów i smartfonów.

Serwer DHCP odpowiada za automatyczny przydział nie tylko adresu IP i maski podsieci, lecz również adresu bramy domyślnej (Default Gateway), serwerów DNS, domeny wyszukiwania oraz dziesiątek parametrów specjalistycznych niezbędnych do prawidłowego funkcjonowania stacji w domenie uczelnianej.

Protokół DHCPv4 opiera się na architekturze klient-serwer wykorzystującej protokół UDP z portami 67 (dla serwera) i 68 (dla klienta). W dużych sieciach kampusowych stabilność tej usługi ma fundamentalne znaczenie: niedostępność serwera DHCP uniemożliwia tysiącom użytkowników uzyskanie konfiguracji sieciowej po włączeniu komputerów rano, co paraliżuje pracę jednostek dydaktycznych i administracyjnych.

Skróty użyte w tym slajdzie:
BOOTP (Bootstrap Protocol) - Historyczny protokół sieciowy (RFC 951) stanowiący technologiczny fundament protokołu DHCP.
UDP (User Datagram Protocol) - Bezpołączeniowy protokół warstwy transportowej (RFC 768) wykorzystywany przez usługi DHCP i DNS.

21/54

Czteroetapowy cykl wymiany komunikatów DHCP: proces DORA

Przebieg transmisji między klientem a serwerem DHCP.

Wykład 6: Czteroetapowy cykl wymiany komunikatów DHCP: proces DORA

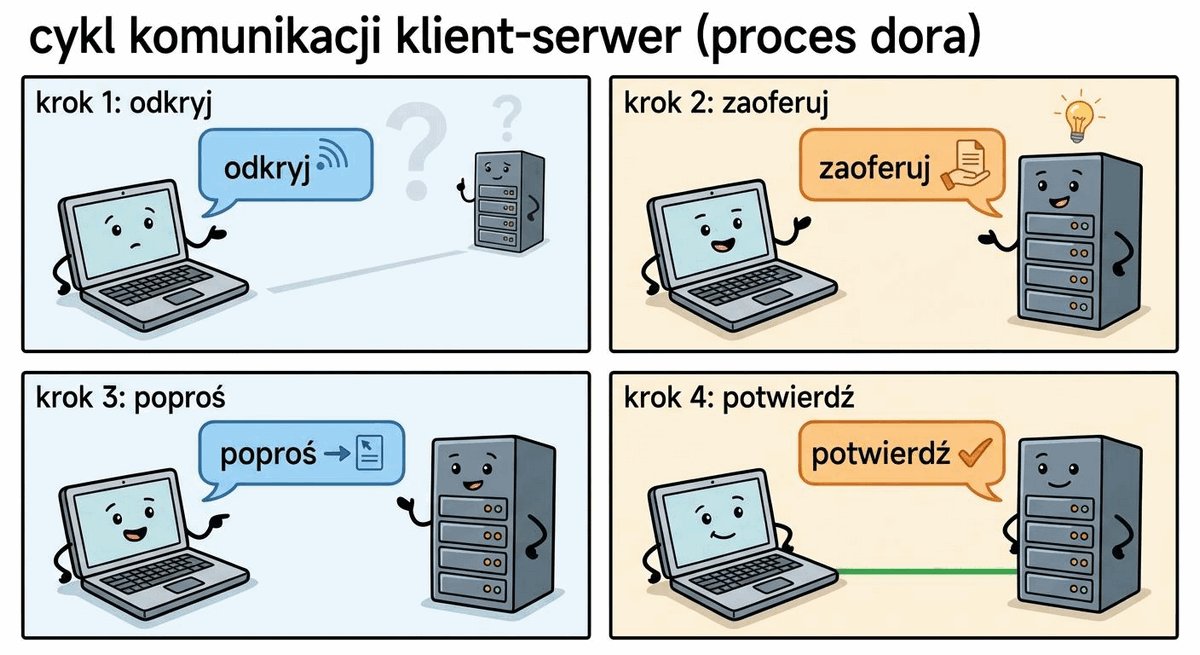
  • Krok 1: DHCP Discover (klient wysyła broadcast na 255.255.255.255): stacja rozgłasza zapytanie poszukujące serwera DHCP w sieci.
  • Krok 2: DHCP Offer (serwer odpowiada unicastem lub broadcastem): serwer rezerwuje adres z puli i proponuje go stacji wraz z parametrami.
  • Krok 3: DHCP Request (klient wysyła broadcast): stacja akceptuje ofertę wybranego serwera (powiadomienie broadcast informuje inne serwery o odrzuceniu ich ofert).
  • Krok 4: DHCP Acknowledge / DHCP ACK (serwer odpowiada unicastem lub broadcastem): ostateczne potwierdzenie przydziału, wpisanie stacji do bazy dzierżaw.
  • Wszystkie komunikaty są przesyłane protokołem UDP na port 67 (serwer) oraz port 68 (klient).
Cykl DORA (Discover, Offer, Request, Acknowledge) to czterofazowa sekwencja wymiany pakietów UDP inicjująca dzierżawę adresu, kontrolowana przez liczniki czasu odnowienia T1 (50%) oraz T2 (87,5%).
Ilustracja techniczna do slajdu 21: Czteroetapowy cykl wymiany komunikatów DHCP: proces DORA

Proces uzyskiwania konfiguracji DHCPv4 opiera się na czterofazowym cyklu wymiany komunikatów UDP, znanym jako sekwencja DORA: Discover (stacja wysyła broadcast na port UDP 67), Offer (serwer proponuje adres), Request (klient akceptuje ofertę) oraz Acknowledge (serwer potwierdza dzierżawę).

W trakcie dzierżawy stacja monitoruje dwa liczniki czasu: T1 (Renewal Timer, domyślnie 50% czasu dzierżawy, odnowienie unicastem do serwera źródłowego) oraz T2 (Rebinding Timer, 87,5% czasu, próba odnowienia broadcastem do dowolnego serwera). Zapobiega to utracie łączności przy chwilowej niedostępności węzła.

Warto zauważyć, że komunikaty DHCPDISCOVER i DHCPREQUEST są rozsyłane przez klienta jako pakiety rozgłoszeniowe (Broadcast z adresem docelowym 255.255.255.255), ponieważ na tym etapie stacja nie posiada jeszcze przypisanego adresu IP ani wiedzy o adresie serwera. Z kolei serwer odpowiada komunikatami DHCPOFFER i DHCPACK w zależności od implementacji i flagi Broadcast Flag klienta w formie rozgłoszeniowej lub unicastowej, co ma istotne konsekwencje dla obciążenia łączy przełączanych.

W trakcie trwania dzierżawy stacja robocza nie czeka na wygaśnięcie całego przydzielonego okresu, lecz po upływie 50% czasu (licznik T1 - Renewal Timer) podejmuje próbę odnowienia konfiguracji, wysyłając pakiet unicastowy DHCPREQUEST bezpośrednio do serwera, który wydał adres. Jeśli serwer nie odpowie do momentu osiągnięcia 87,5% czasu dzierżawy (licznik T2 - Rebinding Timer), stacja przechodzi w stan reasocjacji i zaczyna rozsyłać pakiety DHCPREQUEST w formie rozgłoszeniowej do dowolnego dostępnego serwera w sieci.

Skróty użyte w tym slajdzie:
Lease (DHCP Lease Time) - Czas dzierżawy adresu IP przydzielony klientowi przez serwer DHCP.
T1 (Renewal Timer) - Czas (domyślnie 50% dzierżawy), po którym klient wysyła żądanie odnowienia adresu bezpośrednio do serwera DHCP.
T2 (Rebinding Timer) - Czas (domyślnie 87,5% dzierżawy), po którym klient rozsyła rozgłoszeniowe żądanie odnowienia do dowolnego serwera DHCP.
22/54

Struktura i parametry puli adresowej DHCP

Konfiguracja zakresów adresowych na serwerze DHCP.

Wykład 6: Struktura i parametry puli adresowej DHCP

  • Składniki definicji puli DHCP:
  • Identyfikator podsieci i maska sieciowa (np. `network 10.1.10.0 255.255.255.0`).
  • Zakres wykluczeń (Excluded Addresses): adresy zarezerwowane dla bramy, przełączników, drukarek i serwerów (np. 10.1.10.1 - 10.1.10.20).
  • Brama domyślna: parametr Default Router (opcja 3).
  • Serwery DNS: adresy IP lokalnych serwerów nazw (opcja 6).
  • Nazwa domeny: parametr Domain Name (opcja 15, np. `eti.pg.edu.pl`).
  • Czas dzierżawy: dobór w zależności od charakteru podsieci (długi dla biur: 7 dni; krótki dla Wi-Fi i sal wykładowych: 2-4 godziny w celu rotacji adresów).
Pula adresowa DHCP definiuje zakres dostępnych adresów dynamicznych, rezerwacje statyczne dla wybranych adresów MAC oraz wykluczenia (Excluded Addresses) dla urządzeń infrastrukturalnych.
Ilustracja techniczna do slajdu 22: Struktura i parametry puli adresowej DHCP

Struktura puli adresowej DHCP na serwerze kampusowym (np. ISC Kea, Windows Server DHCP lub Cisco IOS) definiuje zakres adresów dostępnych, listę wykluczeń (Excluded Addresses) dla urządzeń ze stałą adresacją (przełączniki, bramy SVI, drukarki) oraz czas trwania dzierżawy (Lease Time).

W kampusach akademickich czas dzierżawy dobiera się dynamicznie w zależności od charakteru segmentu: w laboratoriach stacjonarnych wynosi on zazwyczaj od 8 do 24 godzin, natomiast w dynamicznych sieciach bezprzewodowych Wi-Fi skraca się go do 1-2 godzin w celu szybkiego odzyskiwania adresów.

Czas dzierżawy (Lease Time) to kluczowy parametr optymalizacyjny dobierany w zależności od profilu użytkowników danej podsieci. W salach laboratoryjnych i biurach pracowniczych, gdzie komputery są stale podłączone do sieci, czas dzierżawy ustala się na kilka dni lub tygodni, co zmniejsza ruch sygnalizacyjny. W otwartych sieciach Wi-Fi dla gości i studentów czas dzierżawy skraca się do 1-2 godzin, co zapobiega zablokowaniu puli przez rotujące urządzenia, które dawno opuściły teren kampusu.

Skróty użyte w tym slajdzie:
Pool (DHCP Address Pool) - Zdefiniowany na serwerze zakres adresów IP przeznaczony do dynamicznego przydziału klientom.
Exclusion (DHCP Excluded Addresses) - Pula adresów IP wyłączonych z dynamicznego przydziału, zarezerwowanych dla serwerów i urządzeń sieciowych.

23/54

Zaawansowane opcje protokołu DHCP

Dostarczanie specjalistycznych parametrów dla urządzeń sieciowych.

Wykład 6: Zaawansowane opcje protokołu DHCP

  • Mechanizm opcji DHCP (DHCP Options według RFC 2132): rozszerzanie funkcjonalności konfiguracji stacji.
  • Opcja 43 (Vendor-Specific Info): przekazywanie punktom dostępowym adresu IP kontrolera sieci bezprzewodowej WLC w celu automatycznego zestawienia tunelu CAPWAP.
  • Opcja 66 i 67: adres serwera TFTP i nazwa pliku rozruchowego dla bezdyskowego startu stacji przez sieć (PXE Boot w laboratoriach komputerowych).
  • Opcja 150: lista adresów IP serwerów Call Manager dla telefonów telefonii internetowej Cisco VoIP.
  • Opcja 82 (Relay Agent Information Option, RFC 3046): wstrzykiwanie przez przełącznik pośredniczący podopcji Agent Circuit ID (port, VLAN) oraz Agent Remote ID (MAC przełącznika), co umożliwia precyzyjną lokalizację gniazdka abonenta i zasilanie bazy DHCP Snooping.
Zaawansowane opcje DHCP dostarczają specyficzne parametry konfiguracyjne: Opcja 43 (adres kontrolera WLC dla AP), Opcje 66/67 (serwery PXE dla laboratoriów) oraz Opcja 82 (RFC 3046) kodująca fizyczny port i VLAN klienta.
Ilustracja techniczna do slajdu 23: Zaawansowane opcje protokołu DHCP

Zaawansowane opcje protokołu DHCP (RFC 2132) pozwalają na automatyczną dystrybucję parametrów dla wyspecjalizowanych systemów sieciowych: Opcja 43 dostarcza adresy kontrolerów WLC dla punktów AP, Opcje 66 i 67 konfigurują serwery TFTP/PXE dla instalacji bezdyskowych, a Opcja 150 dostarcza adresy serwerów telefonii VoIP.

Kluczowe znaczenie dla bezpieczeństwa ma Opcja 82 (Relay Agent Information Option, RFC 3046). Wstrzykiwana przez przełącznik pośredniczący, zawiera podopcje Circuit ID (numer portu i VLAN) oraz Remote ID (adres MAC przełącznika), co pozwala serwerowi na precyzyjną identyfikację fizycznego gniazda abonenta w budynku.

Zaawansowane opcje DHCP są motorem napędowym automatyzacji urządzeń brzegowych. Opcja 150 (lub 66) pozwala telefonom VoIP automatycznie pobrać adres serwera TFTP z plikami konfiguracyjnymi i oprogramowaniem układowym zaraz po wpięciu do gniazda sieciowego. Z kolei opcja 43 umożliwia punktom dostępowym Wi-Fi odkrycie adresu kontrolera WLC znajdującego się w innej podsieci L3, co realizuje koncepcję wdrożenia typu Zero-Touch Provisioning (ZTP).

Skróty użyte w tym slajdzie:
Option 82 (DHCP Relay Agent Information Option) - Standard (RFC 3046) dołączający metadane o porcie fizycznym i przełączniku klienta.
Circuit ID (Agent Circuit ID Sub-option) - Podopcja Option 82 identyfikująca lokalny interfejs i numer VLAN-u zgłaszającego się klienta.
Remote ID (Agent Remote ID Sub-option) - Podopcja Option 82 niosąca unikalny identyfikator przełącznika dostępowego (np. adres MAC bazy).

24/54

Problem działania DHCP w środowisku wielu podsieci

Charakter komunikatów rozgłoszeniowych a granice warstwy 3.

Wykład 6: Problem działania DHCP w środowisku wielu podsieci

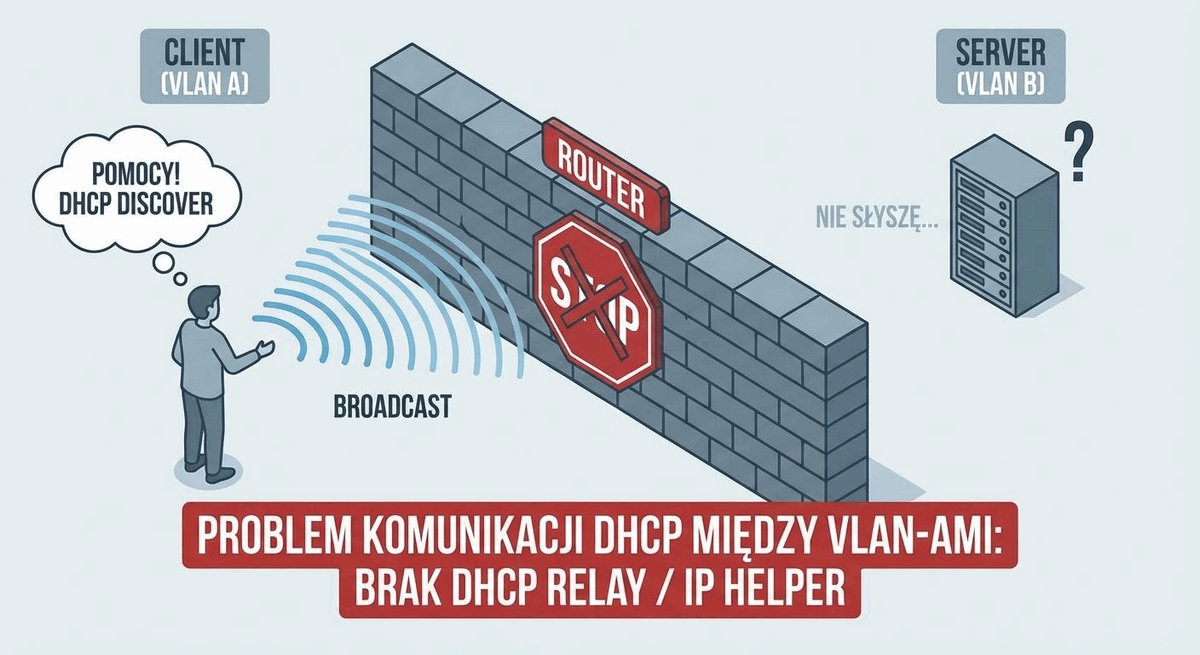
  • Problem fizyczny: stacja robocza rozpoczyna proces DORA wysyłając pakiet DHCP Discover jako broadcast w warstwie 2 (MAC docelowy FF:FF:FF:FF:FF:FF) oraz w warstwie 3 (IP 255.255.255.255).
  • Zasada działania routera: routery i przełączniki L3 z definicji nie przekazują pakietów rozgłoszeniowych między podsieciami.
  • Konsekwencja: serwer DHCP musiałby fizycznie znajdować się w każdym VLAN-ie i w każdym budynku, co oznaczałoby konieczność instalacji i utrzymania setek serwerów DHCP w kampusie.
  • Konieczność zastosowania mechanizmu przekazywania zapytań przez barierę L3.
Blokowanie rozgłoszeń przez przełączniki warstwy L3 uniemożliwia bezpośrednie dotarcie pakietów DHCP Discover do centralnego serwera w innej sieci VLAN bez wsparcia agenta pośredniczącego.
Ilustracja techniczna do slajdu 24: Problem działania DHCP w środowisku wielu podsieci

Podstawowym problemem wdrożeniowym protokołu DHCP w sieci z wieloma sieciami VLAN jest fakt, że pakiety inicjujące DHCP Discover są ramkami rozgłoszeniowymi (Broadcast L2 / Limited Broadcast 255.255.255.255). Zgodnie z zasadami sieci pakiety te nie są przekazywane przez routery ani przełączniki L3.

Umieszczanie fizycznego serwera DHCP w każdym z setek VLAN-ów w kampusie byłoby niepraktyczne ekonomicznie i organizacyjnie. Rozwiązaniem tego ograniczenia jest wdrożenie agenta pośredniczącego (DHCP Relay Agent).

Ponieważ ramki rozgłoszeniowe warstwy 2 nie są domyślnie przekazywane przez routery i przełączniki warstwy 3 (brak przekazywania ruchu BUM między podsieciami), zapytanie DHCP klienta zostaje zatrzymane w lokalnym segmencie VLAN. Bez dedykowanego mechanizmu translacji uczelnia musiałaby instalować fizyczny serwer DHCP w każdym skrzydle budynku i dla każdej podsieci z osobna, co byłoby skrajnie nieefektywne pod względem wdrożeniowym i ekonomicznym.

Skróty użyte w tym slajdzie:
Broadcast Domain (Broadcast Domain) - Domena rozgłoszeniowa ograniczona przez interfejsy routera lub wirtualne sieci VLAN.
Unicast (Unicast Transmission) - Transmisja pakietu skierowana bezpośrednio do pojedynczego, unikalnego odbiorcy sieciowego.

25/54

Rozwiązanie: agent pośredniczący DHCP Relay

Koncepcja konwersji pakietów rozgłoszeniowych na pakiety unicast.

Wykład 6: Rozwiązanie: agent pośredniczący DHCP Relay

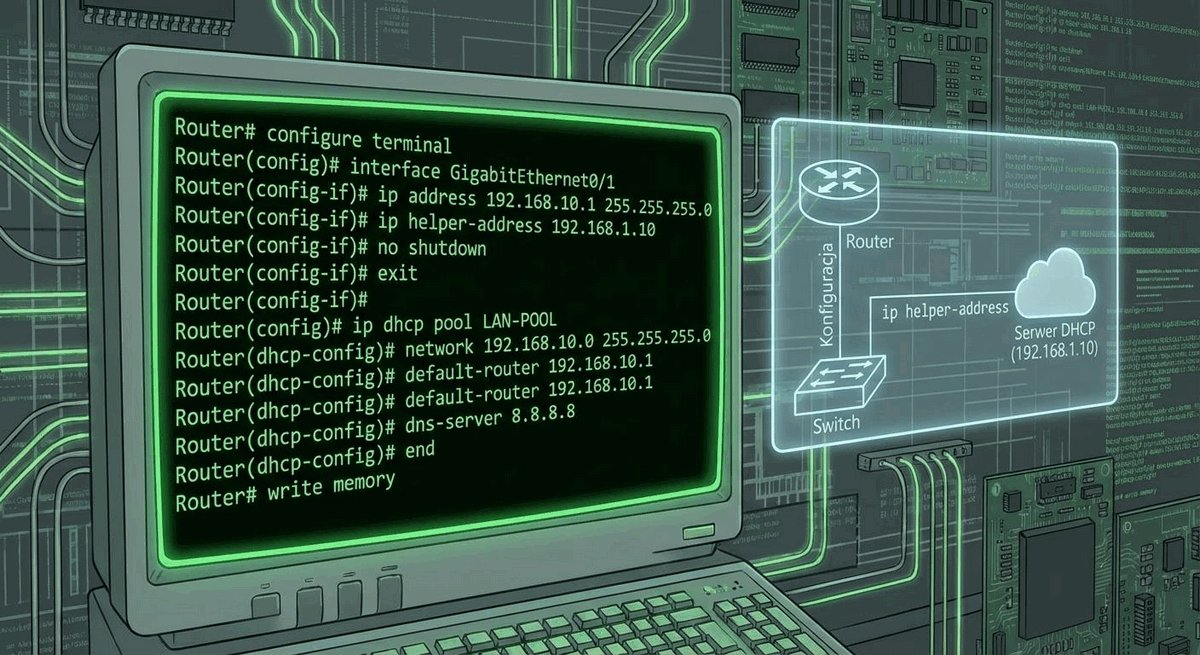
  • Agent pośredniczący (DHCP Relay Agent): funkcja uruchamiana na przełączniku wielowarstwowym lub routerze pełniącym rolę bramy domyślnej dla danej podsieci.
  • Polecenie konfiguracyjne (Cisco IOS): ip helper-address <ip_serwera_dhcp> ustawiane na interfejsie SVI danego VLAN-u.
  • Zasada działania: przełącznik przechwytuje lokalny broadcast DHCP Discover na porcie UDP 67.
  • Konwersja pakietu: przełącznik przekształca pakiet w standardowy pakiet unicast, wpisując w nagłówku IP swój własny adres SVI jako źródło oraz adres centralnego serwera DHCP jako cel.
  • Wypełnienie pola GIADDR (Gateway IP Address): przełącznik wpisuje adres IP swojego interfejsu SVI, informując serwer DHCP, z której dokładnie podsieci pochodzi zapytanie.
  • Optymalizacja i zabezpieczenie ip helper-address: wyłączenie zbędnego przekazywania rozgłoszeń UDP poleceniami: `no ip forward-protocol udp 37` (Time), `49` (TACACS), `69` (TFTP), `137` i `138` (NetBIOS).
  • Dołączanie Opcji 82 (RFC 3046): przekazywanie Circuit ID i Remote ID do serwera DHCP.
Agent DHCP Relay (konfigurowany poleceniem ip helper-address) przechwytuje lokalny broadcast DHCP i przekazuje go unicastem do serwera centralnego; jego wdrożenie wymaga wyłączenia zbędnego przekazywania UDP (no ip forward-protocol udp).
Ilustracja techniczna do slajdu 25: Rozwiązanie: agent pośredniczący DHCP Relay

Funkcja DHCP Relay Agent uruchamiana jest na interfejsie L3 (SVI lub podinterfejsie routera) pełniącym rolę bramy domyślnej dla danego VLAN-u za pomocą dyrektywy ip helper-address <IP_serwera>. Przełącznik przechwytuje lokalny broadcast DHCP i konwertuje go na pakiet Unicast kierowany do serwera centralnego.

Przełącznik wypełnia w nagłówku DHCP pole GIADDR (Gateway IP Address) adresem swojego interfejsu SVI, informując serwer o źródłowej podsieci. Inżynier musi pamiętać o wyłączeniu zbędnego przekazywania UDP (no ip forward-protocol udp 37, 49, 69, 137, 138), które domyślnie włącza polecenie helper-address.

Mechanizm DHCP Relay (konfigurowany poleceniem ip helper-address na interfejsach SVI w przełącznikach Cisco) interceptuje pakiety rozgłoszeniowe UDP wysyłane na port 67 i enkapsuluje je w pakiety unicastowe kierowane do centralnego klastra serwerów DHCP. W nagłówku pakietu agent uzupełnia pole giaddr (Gateway IP Address) adresem własnego interfejsu SVI, dzięki czemu serwer DHCP natychmiast wie, z której puli adresowej przydzielić wolny adres IP dla wnioskującego klienta.

Skróty użyte w tym slajdzie:
DHCP Relay (DHCP Relay Agent) - Usługa sieciowa przekształcająca rozgłoszeniowe pakiety DHCP klientów na pakiety unicast kierowane do serwera.
Helper Address (IP Helper-Address) - Polecenie na interfejsie L3 Cisco przekazujące ruch rozgłoszeniowy UDP na wskazany serwer unicast.

26/54

Zasada działania DHCP Relay w wielobudynkowym kampusie

Centralizacja zarządzania adresacją w serwerowni głównej MDF.

Wykład 6: Zasada działania DHCP Relay w wielobudynkowym kampusie

  • Schemat komunikacji: komputer w Budynku C wysyła broadcast; przełącznik dystrybucyjny L3 przechwytuje ramkę, tworzy pakiet unicast i przesyła go szkieletem OSPF do serwerowni MDF. Centralny klaster DHCP odczytuje pole GIADDR, przydziela adres z odpowiedniej puli i odsyła ofertę unicastem do przełącznika dystrybucyjnego, który przekazuje pakiet do studenta.
  • Korzyści: centralna administracja adresacją, wysoka dostępność serwerów DHCP w klastrze, łatwe tworzenie kopii zapasowych, precyzyjne śledzenie lokalizacji dzięki Opcji 82 i pełna integracja z systemami zarządzania tożsamością.
Wdrożenie DHCP Relay w kampusie pozwala na centralizację zarządzania adresacją w serwerowni głównej MDF, ułatwiając tworzenie kopii zapasowych, klastrowanie serwerów oraz audyt dzierżaw.
Ilustracja techniczna do slajdu 26: Zasada działania DHCP Relay w wielobudynkowym kampusie

Zastosowanie agentów DHCP Relay umożliwia centralizację całej infrastruktury adresowej kampusu w głównym centrum danych (MDF). Pojedynczy, wysokodostępny klaster serwerów DHCP zarządza pulami adresowymi dla dziesiątek budynków wydziałowych i akademików.

Centralizacja upraszcza tworzenie kopii zapasowych, synchronizację dzierżaw, integrację z systemami zarządzania tożsamością (Active Directory, RADIUS/LDAP) oraz pozwala na dynamiczne bilansowanie obciążenia pomiędzy serwerami w trybie Failover lub Load Sharing.

W środowiskach kampusowych wysokiej dostępności agenci DHCP Relay są konfigurowani z kilkoma adresami docelowymi pomocniczymi (ang. multiple helper addresses). Pozwala to na równoległe wysyłanie zapytań do głównego i zapasowego serwera DHCP zlokalizowanych w odrębnych centrach danych kampusu. Serwery synchronizują stan dzierżaw za pośrednictwem protokołu failover (np. ISC DHCP Failover lub Windows Server DHCP Failover), eliminując pojedynczy punkt awarii (SPOF).

Skróty użyte w tym slajdzie:
MDF (Main Distribution Frame) - Główny punkt dystrybucyjny kampusu łączący serwerownię z siecią szkieletową.
IDF (Intermediate Distribution Frame) - Pośredni punkt dystrybucyjny w budynku skupiający przełączniki warstwy dostępu.

27/54

Zagrożenia bezpieczeństwa protokołu DHCP: atak DHCP Starvation

Atak typu odmowa usługi na pulę adresową podsieci.

Wykład 6: Zagrożenia bezpieczeństwa protokołu DHCP: atak DHCP Starvation

  • Mechanizm ataku DHCP Starvation (wyczerpanie puli): złośliwe oprogramowanie (np. Yersinia) generuje tysiące fałszywych zapytań DHCP Discover z losowo wygenerowanymi adresami MAC w nagłówku.
  • Skutek: serwer DHCP wyczerpuje całą dostępną pulę adresów IP w podsieci w ciągu kilkunastu sekund.
  • Konsekwencja dla użytkowników: żaden uprawniony komputer podłączający się do sieci nie może uzyskać adresu IP i traci dostęp do usług (Denial of Service).
  • Konieczność zastosowania ograniczeń na portach przełącznika dostępowego.
Atak DHCP Starvation polega na masowym wysyłaniu fałszywych zapytań Discover ze sztucznymi adresami MAC w celu szybkiego wyczerpania puli adresowej i doprowadzenia do odmowy usługi (DoS).
Ilustracja techniczna do slajdu 27: Zagrożenia bezpieczeństwa protokołu DHCP: atak DHCP Starvation

Brak wbudowanych mechanizmów uwierzytelniania w protokole DHCP czyni go podatnym na ataki. Atak wyczerpania puli (DHCP Starvation) polega na generowaniu przez intruza tysięcy fałszywych zapytań DHCP Discover ze zmyślonymi adresami MAC (np. za pomocą narzędzia Yersinia).

W ciągu kilkunastu sekund cała dostępna pula adresowa zostaje zarezerwowana, co uniemożliwia uprawnionym stacjom roboczym uzyskanie konfiguracji sieciowej i prowadzi do odmowy usługi (Denial of Service - DoS) w danym segmencie kampusu.

Atak DHCP Starvation (wyczerpanie puli adresowej) jest przeprowadzany za pomocą zautomatyzowanych skryptów (np. narzędzia dhcpstarv lub scapy), które generują w ciągu kilkunastu sekund tysiące fałszywych zapytań DHCPDISCOVER z losowymi adresami źródłowymi MAC. Po wyczerpaniu wszystkich wolnych adresów w puli nowi użytkownicy tracą możliwość podłączenia się do sieci, a napastnik może przejść do kolejnej fazy ataku, uruchamiając fałszywy serwer DHCP i przejmując kontrolę nad ruchem użytkowników.

Skróty użyte w tym slajdzie:
DHCP Starvation (DHCP Starvation Attack) - Atak polegający na wyczerpaniu puli adresowej serwera DHCP przez wysyłanie tysięcy fałszywych zapytań.
Spoofing (MAC Address Spoofing) - Technika fałszowania adresu fizycznego karty sieciowej w celu ominięcia zabezpieczeń.

28/54

Zagrożenia bezpieczeństwa: atak Rogue DHCP Server

Podstawienie fałszywego serwera DHCP i przejęcie kontroli nad ruchem.

Wykład 6: Zagrożenia bezpieczeństwa: atak Rogue DHCP Server

  • Mechanizm ataku: intruz uruchamia w sieci własny, nieautoryzowany serwer DHCP (Rogue DHCP Server).
  • Wyścig odpowiedzi: fałszywy serwer odpowiada na zapytania klientów szybciej niż serwer autoryzowany.
  • Zafałszowanie parametrów sieciowych: fałszywy serwer przydziela komputerom studentów adres IP, ale jako bramę domyślną oraz serwer DNS wskazuje adres IP komputera atakującego.
  • Skutek: atak typu Man-in-the-Middle (MitM); cały ruch internetowy ofiary przechodzi przez komputer intruza, umożliwiając podsłuch haseł i manipulację danymi.
Rogue DHCP Server to nieautoryzowany serwer DHCP wpięty do sieci przez użytkownika lub intruza, rozsyłający błędne parametry sieciowe w celu przeprowadzenia ataku podsłuchu Man-in-the-Middle (MitM).
Ilustracja techniczna do slajdu 28: Zagrożenia bezpieczeństwa: atak Rogue DHCP Server

Kolejnym zagrożeniem jest uruchomienie w sieci nieautoryzowanego serwera DHCP (Rogue DHCP Server), np. przez przypadkowe podłączenie domowego routera Wi-Fi w pokoju akademika lub celowe działanie atakującego.

Nieautoryzowany serwer odpowiada na pakiety Discover szybciej niż serwer centralny, przydzielając stacjom błędną adresację lub konfigurując własny adres jako bramę domyślną i serwer DNS. Umożliwia to przeprowadzenie ataku podsłuchu i modyfikacji ruchu typu Man-in-the-Middle (MitM).

Uruchomienie fałszywego serwera DHCP (Rogue DHCP) może być wynikiem celowego ataku hakerskiego lub zwykłego błędu ludzkiego (np. wpięcia przez studenta domowego routera Wi-Fi portem LAN do gniazda w akademiku). Ponieważ fałszywy serwer zazwyczaj odpowiada szybciej niż centralny serwer uczelniany, przydziela klientom zafałszowaną bramę domyślną i adresy DNS, umożliwiając intruzowi przeprowadzenie ataku podsłuchu Man-in-the-Middle (MitM) oraz phishingu.

Skróty użyte w tym slajdzie:
Rogue DHCP (Rogue DHCP Server) - Nieautoryzowany serwer DHCP wpięty do sieci rozsyłający błędne parametry sieciowe i fałszywą bramę domyślną.
MitM (Man-in-the-Middle) - Atak polegający na przechwytywaniu i modyfikowaniu ruchu pomiędzy ofiarą a siecią z użyciem fałszywej bramy.

29/54

Ochrona w warstwie 2: mechanizm DHCP Snooping

Sprzętowa zapora dla pakietów DHCP wbudowana w przełącznik.

Wykład 6: Ochrona w warstwie 2: mechanizm DHCP Snooping

  • Koncepcja DHCP Snooping: przełącznik analizuje przepływające pakiety DHCP i dzieli swoje porty fizyczne na dwie kategorie:
  • Porty zaufane (Trusted Ports): porty podłączone do autoryzowanych serwerów DHCP lub łączy dosyłowych (trunk) do szkieletu sieci.
  • Porty niezaufane (Untrusted Ports): wszystkie porty dostępowe, do których podłączeni są użytkownicy końcowi.
  • Reguła blokowania: przełącznik blokuje i odrzuca pakiety oferujące adresy (DHCP Offer, DHCP ACK) pojawiające się na portach niezaufanych.
  • Skuteczne blokowanie fałszywych serwerów DHCP (Rogue DHCP).
DHCP Snooping to mechanizm warstwy 2 dzielący porty przełącznika na zaufane (Trusted) i niezaufane (Untrusted), blokujący nieautoryzowane pakiety serwerowe oraz ograniczający częstotliwość zapytań stacji.
Ilustracja techniczna do slajdu 29: Ochrona w warstwie 2: mechanizm DHCP Snooping

Skuteczną obroną przed atakami na DHCP jest wdrożenie sprzętowej funkcji DHCP Snooping na przełącznikach warstwy dostępu. Funkcja ta dzieli porty przełącznika na zaufane (Trusted) oraz niezaufane (Untrusted).

Porty podłączone do stacji roboczych są definiowane jako niezaufane; przełącznik blokuje na nich pakiety serwerowe (Offer, Acknowledge). Ponadto na portach niezaufanych wdraża się ograniczanie liczby pakietów DHCP na sekundę (Rate Limiting), neutralizując ataki typu DHCP Starvation.

Mechanizm DHCP Snooping działa w przełącznikach dostępowych jako zapora ogniowa warstwy 2 dla protokołu DHCP. Dzieli on interfejsy na zaufane (Trusted) - połączone z serwerami DHCP lub przełącznikami nadrzędnymi, oraz niezaufane (Untrusted) - do których podłączone są stacje robocze użytkowników. Przełącznik bezwzględnie blokuje komunikaty DHCPOFFER i DHCPACK napływające na porty niezaufane, uniemożliwiając rozgłaszanie nieautoryzowanych konfiguracji sieciowych.

Skróty użyte w tym slajdzie:
DHCP Snooping (DHCP Snooping) - Mechanizm bezpieczeństwa warstwy 2 filtrujący nieautoryzowane komunikaty DHCP i weryfikujący zaufanie portów.
Trusted Port (DHCP Trusted Port) - Port przełącznika podłączony do autoryzowanego serwera DHCP lub uplink, na którym dozwolone są odpowiedzi DHCP Offer/ACK.
Untrusted Port (DHCP Untrusted Port) - Port brzegowy podłączony do stacji użytkowników, na którym odpowiedzi serwera DHCP są natychmiast blokowane.

30/54

Budowanie i rola bazy wiązań DHCP Snooping Binding Table

Podstawa bezpieczeństwa warstwy dostępu.

Wykład 6: Budowanie i rola bazy wiązań DHCP Snooping Binding Table

  • Przełącznik z włączonym DHCP Snooping obserwuje prawidłową wymianę komunikatów DORA i buduje w pamięci dynamiczną tablicę wiązań.
  • Struktura wpisu w tablicy wiązań: adres MAC klienta, przydzielony adres IP, czas dzierżawy, numer VLAN i numer portu fizycznego.
  • Ochrona przed atakiem Starvation: ograniczanie liczby pakietów DHCP na sekundę (Rate Limiting) na portach niezaufanych.
  • Tablica wiązań DHCP Snooping stanowi niezbędną bazę danych dla kolejnych mechanizmów bezpieczeństwa: Dynamic ARP Inspection (DAI) oraz IP Source Guard (IPSG); mechanizmy te wykorzystują metadane Circuit ID i Remote ID wprowadzone przez Opcję 82.
DHCP Snooping Binding Table to sprzętowa baza wiązań rejestrująca prawidłowe powiązania MAC, IP, VLAN i portu fizycznego, stanowiąca fundament działania ochrony Dynamic ARP Inspection (DAI) i IP Source Guard.
Ilustracja techniczna do slajdu 30: Budowanie i rola bazy wiązań DHCP Snooping Binding Table

Efektem działania mechanizmu DHCP Snooping jest dynamiczne budowanie w pamięci przełącznika bazy wiązań - DHCP Snooping Binding Table. Tablica ta wiąże ze sobą adres MAC klienta, przydzielony adres IP, czas dzierżawy, identyfikator VLAN oraz fizyczny numer portu.

Baza wiązań jest wykorzystywana przez mechanizmy ochrony warstwy 2: inspekcji pakietów ARP (Dynamic ARP Inspection - DAI, eliminacja ARP Spoofing) oraz filtrowania adresów źródłowych IP (IP Source Guard - IPSG, eliminacja IP Spoofing).

Baza wiązań DHCP Snooping (przechowująca korelacje: MAC, IP, numer VLAN, port fizyczny, czas dzierżawy) staje się fundamentem dla innych zaawansowanych mechanizmów bezpieczeństwa warstwy 2. Wykorzystuje ją technologia Dynamic ARP Inspection (DAI) do eliminowania zatruwania tablic ARP oraz funkcja IP Source Guard (IPSG), która sprzętowo w pamięci TCAM blokuje pakiety o sfałszowanym adresie źródłowym IP wysyłane ze stacji klienckich.

Skróty użyte w tym slajdzie:
Binding Table (DHCP Snooping Binding Database) - Dynamiczna tablica powiązań przełącznika zawierająca adresy MAC, IP, czas dzierżawy, port i VLAN.
IPSG (IP Source Guard) - Mechanizm sprzętowy warstwy 2 blokujący ruch z nieautoryzowanych adresów IP na podstawie bazy DHCP Snooping.

31/54

System nazw domenowych DNS (Domain Name System)

Kluczowa usługa translacji nazw mnemonicznych na adresy sieciowe.

Wykład 6: System nazw domenowych DNS (Domain Name System)

  • Standardy IETF RFC 1034 i RFC 1035.
  • Rola DNS: użytkownicy i aplikacje posługują się łatwymi do zapamiętania nazwami domenowymi (np. `usos.uczelnia.pl`), podczas gdy routery operują wyłącznie na adresach IP (`10.20.4.15` lub `2001:db8::15`).
  • Awaria DNS w kampusie jest odbierana przez użytkowników jako całkowita awaria sieci (brak możliwości otwarcia stron WWW pomimo sprawnej warstwy routingu).
  • Protokół transportowy: tradycyjnie port 53 UDP dla standardowych zapytań oraz port 53 TCP dla odpowiedzi przekraczających 512 bajtów i dla transferu stref (Zone Transfer).
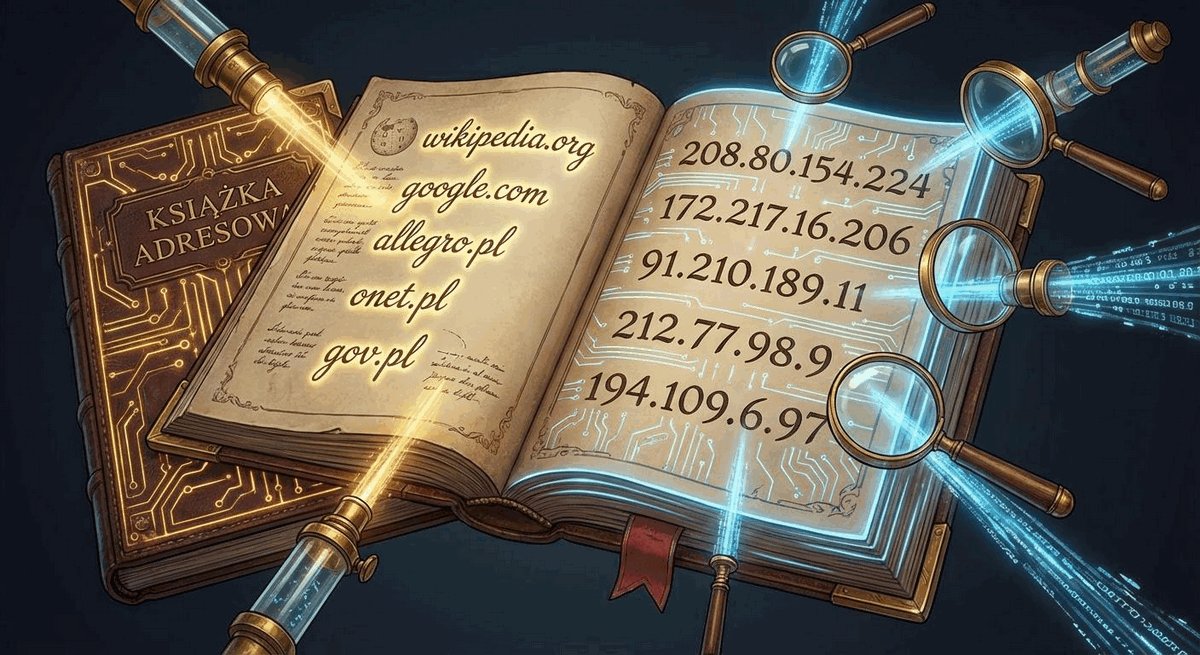
Domain Name System (DNS) to rozproszona baza danych tłumacząca mnemoniczne nazwy domenowe na adresy IP, stanowiąca kluczową usługę warstwy aplikacji warunkującą działanie sieci kampusowej.
Ilustracja techniczna do slajdu 31: System nazw domenowych DNS (Domain Name System)

System nazw domenowych (DNS - Domain Name System, RFC 1034/1035) to hierarchiczna, rozproszona baza danych tłumacząca mnemoniczne nazwy domenowe (np. www.agh.edu.pl) na binarne adresy IP (IPv4 i IPv6). Stanowi kluczową usługę, bez której działanie sieci kampusowej jest niemożliwe.

Z punktu widzenia inżynierskiego awaria serwerów DNS jest tożsama z całkowitą niedostępnością sieci dla użytkowników końcowych, dlatego architektura DNS na uczelni musi cechować się najwyższym poziomem redundancji i odporności na cyberataki.

System DNS stanowi nerw operacyjny kampusu akademickiego: bez jego sprawnego działania użytkownicy tracą dostęp do poczty elektronicznej, serwisów bibliotecznych, systemów uwierzytelniania SSO oraz repozytoriów kodu źródłowego. Protokół wykorzystuje tradycyjnie port 53 protokołu UDP dla szybkich zapytań o rozmiarze do 512 bajtów oraz port 53 protokołu TCP w przypadku zapytań powiększonych (EDNS0), transferów stref (AXFR/IXFR) lub transmisji szyfrowanych.

W procesie rekurencyjnego rozwiązywania nazw serwer DNS wykorzystuje wbudowany plik podpowiedzi strefy głównej (Root Hints, zawierający adresy IP 13 globalnych klastrów serwerów głównych oznaczonych literami od A do M). Zapytanie przekazywane jest kolejno od węzła głównego, przez serwery domen najwyższego poziomu (TLD, np. dla domeny .pl rejestr prowadzony przez NASK), aż po autorytatywne serwery uczelniane, co gwarantuje jednoznaczność i globalną spójność adresacji domenowej w Internecie.

Skróty użyte w tym slajdzie:
FQDN (Fully Qualified Domain Name) - Pełna kanoniczna nazwa domenowa jednoznacznie identyfikująca węzeł w hierarchii DNS.
Resolver (DNS Resolver) - Komponent systemu operacyjnego lub serwera odpowiedzialny za wysyłanie zapytań DNS i buforowanie odpowiedzi.

32/54

Hierarchiczna struktura przestrzeni nazw DNS

Drzewiasta organizacja globalnej bazy domenowej.

Wykład 6: Hierarchiczna struktura przestrzeni nazw DNS

  • Poziom główny (Root Zone): oznaczany kropką `.`, obsługiwany przez 13 klastrów serwerów głównych (Root Servers od A do M) rozproszonych globalnie z wykorzystaniem Anycast.
  • Domeny najwyższego poziomu (TLD - Top-Level Domains): krajowe (ccTLD, np. `.pl`, `.uk`) oraz generyczne (gTLD, np. `.edu`, `.com`, `.org`).
  • Domeny drugiego poziomu (Second-Level Domains): domeny zarejestrowane przez instytucje (np. `pg.edu.pl`, `uw.edu.pl`).
  • Poddomeny uczelniane (Subdomains): struktury wydziałowe i funkcyjne tworzone wewnętrznie przez administratorów kampusu (np. `eti.pg.edu.pl`, `wznos.pg.edu.pl`).
Hierarchia DNS opiera się na drzewie domen: strefie głównej (Root), domenach najwyższego poziomu (TLD, np. .pl, .com, .org) oraz domenach drugiego poziomu (np. .edu.pl) delegowanych do uczelnianych serwerów nazw.
Ilustracja techniczna do slajdu 32: Hierarchiczna struktura przestrzeni nazw DNS

Przestrzeń nazw DNS zorganizowana jest w strukturę drzewa: na szczycie znajduje się domena główna (strefa root, reprezentowana przez kropkę ., obsługiwana przez 13 klastrów Root Servers), pod nią domeny najwyższego poziomu (TLD, np. krajowe .pl), a następnie domeny drugiego i kolejnych poziomów (np. .edu.pl).

Każda domena może być delegowana do niezależnych serwerów nazw za pomocą rekordów NS (Name Server), co zapewnia autonomiczną administrację zasobami uczelni przy zachowaniu globalnej spójności całego Internetu.

Hierarchiczna delegacja stref w systemie DNS pozwala uczelni na pełną autonomię w zarządzaniu własną przestrzenią adresową (np. agh.edu.pl czy pw.edu.pl). Administratorzy kampusu mogą delegować uprawnienia do podstref wydziałowych (np. cs.pollub.pl) do lokalnych serwerów nazw prowadzonych przez instytuty informatyki, zachowując spójność globalnego drzewa nazw dzięki rekordom NS wskazywanym w strefie nadrzędnej.

Skróty użyte w tym slajdzie:
TLD (Top-Level Domain) - Domeny najwyższego poziomu w hierarchii DNS (np. .pl, .com, .org).
Authoritative (Authoritative DNS Server) - Serwer DNS przechowujący oficjalną, ostateczną kopię bazy rekordów dla danej strefy domenowej.

33/54

Typy rekordów zasobów DNS

Katalog podstawowych wpisów w strefach domenowych.

Wykład 6: Typy rekordów zasobów DNS

  • Rekord A: mapowanie nazwy hosta na 32-bitowy adres IPv4.
  • Rekord AAAA (Quad-A): mapowanie nazwy hosta na 128-bitowy adres IPv6.
  • Rekord CNAME (Canonical Name): alias wskazujący na inną nazwę kanoniczną (np. `www.uczelnia.pl` wskazuje na `serwer-glowny.uczelnia.pl`).
  • Rekord MX (Mail Exchange): wskazuje serwery poczty elektronicznej odpowiedzialne za przyjmowanie wiadomości dla danej domeny wraz z priorytetami.
  • Rekord PTR (Pointer): rekord translacji odwrotnej (Reverse DNS) mapujący adres IP na nazwę domenową w strefach `in-addr.arpa` i `ip6.arpa`.
  • Rekord TXT: wpisy tekstowe wykorzystywane do zabezpieczeń poczty (SPF, DKIM, DMARC) oraz weryfikacji własności domen.
Rekordy zasobów DNS obejmują podstawowe rekordy mapowania (A dla IPv4, AAAA dla IPv6), rekordy odwrotne PTR, aliasy CNAME, wskazania serwerów pocztowych MX oraz rekordy bezpieczeństwa TXT (SPF, DKIM, DMARC).
Ilustracja techniczna do slajdu 33: Typy rekordów zasobów DNS

Podstawową jednostką informacji w systemie DNS jest rekord zasobów (Resource Record - RR). W sieci kampusowej kluczowe znaczenie mają rekordy: A (mapowanie nazwy na IPv4), AAAA (mapowanie na IPv6), PTR (odwrotne tłumaczenie adresu IP na nazwę), CNAME (alias kanoniczny) oraz MX (wskazanie serwerów poczty elektronicznej).

Dodatkowo stosuje się rekordy TXT wykorzystywane przez mechanizmy bezpieczeństwa poczty e-mail (SPF, DKIM, DMARC) oraz rekordy SRV definiujące lokalizację specyficznych usług sieciowych (np. kontrolerów domeny Active Directory czy serwerów SIP).

Obok podstawowych rekordów mapowania adresów (A dla IPv4 i AAAA dla IPv6) oraz rekordów wskaźnika PTR dla stref odwrotnych (Reverse DNS), krytyczną rolę odgrywają rekordy TXT wykorzystywane w mechanizmach zabezpieczenia poczty e-mail: SPF (Sender Policy Framework), DKIM oraz DMARC. Ich prawidłowa konfiguracja zapobiega podszywaniu się spamerów pod uczelniane domeny pocztowe i chroni reputację uczelnianych serwerów SMTP w globalnej sieci.

Skróty użyte w tym slajdzie:
A Record (IPv4 Address Record) - Podstawowy rekord DNS mapujący nazwę domenową na 32-bitowy adres IPv4.
AAAA Record (IPv6 Address Record) - Rekord DNS mapujący nazwę domenową na 128-bitowy adres IPv6.
CNAME (Canonical Name Record) - Rekord DNS tworzący alias logiczny wskazujący na inną kanoniczną nazwę domenową.
MX (Mail Exchange Record) - Rekord DNS wskazujący serwery poczty elektronicznej odpowiedzialne za przyjmowanie wiadomości w danej domenie.
PTR (Pointer Record) - Rekord strefy odwrotnej (Reverse DNS) służący do mapowania adresu IP na nazwę domenową FQDN.

34/54

Architektura DNS w sieci kampusowej: model Split-DNS

Rozdzielenie widoczności stref wewnętrznych i zewnętrznych.

Wykład 6: Architektura DNS w sieci kampusowej: model Split-DNS

  • Koncepcja Split-DNS (Split-Horizon DNS): rozdzielenie infrastruktury DNS na dwa niezależne widoki:
  • Zewnętrzny serwer DNS (Public DNS): umieszczony w strefie DMZ, autorytatywny dla publicznych zasobów uczelni (widoczny z całego Internetu, zawiera tylko rekordy serwerów WWW, poczty i bram VPN).
  • Wewnętrzny serwer DNS (Internal DNS): zlokalizowany w serwerowni MDF, dostępny wyłącznie z sieci kampusowej; zawiera pełną bazę adresów stacji roboczych, serwerów bazodanowych, kontrolerów domen Active Directory i przełączników.
  • Korzyść bezpieczeństwa: uniemożliwienie intruzom z Internetu rozpoznania wewnętrznej topologii oraz adresacji IP kampusu.
Architektura Split-Horizon DNS utrzymuje dwa odrębne widoki strefy domenowej: zewnętrzny dla publicznego Internetu oraz wewnętrzny chroniący prywatną adresację zasobów uczelni.
Ilustracja techniczna do slajdu 34: Architektura DNS w sieci kampusowej: model Split-DNS

W kampusach akademickich standardem projektowym jest architektura Split-Horizon DNS (Split-DNS). Polega ona na utrzymywaniu dwóch odmiennych widoków tej samej strefy domenowej: zewnętrznego (widocznego z publicznego Internetu) oraz wewnętrznego (dostępnego wyłącznie z sieci uczelnianej).

Zewnętrzny serwer DNS anonsuje wyłącznie publiczne adresy IP serwisów dostępnych z zewnątrz (serwery WWW, poczta, bramy VPN). Wewnętrzny serwer DNS anonsuje prywatną adresację serwerów dziekanatowych, baz danych i stacji roboczych, uniemożliwiając obcym rozpoznanie infrastruktury kampusu.

Model Split-DNS (nazywany również Split-Horizon DNS) separuje widok infrastruktury dla użytkowników zewnętrznych i wewnętrznych. Serwery publiczne anonsują wyłącznie oficjalne serwisy uczelni (portal główny, serwery WWW wydziałów, bramki VPN), ukrywając wewnętrzne adresy IP serwerów bazodanowych, macierzy dyskowych i stacji roboczych. Z kolei wewnętrzne serwery DNS rozwiązują nazwy lokalne na adresy prywatne RFC 1918, uniemożliwiając rekonesans sieciowy potencjalnym napastnikom z zewnątrz.

Skróty użyte w tym slajdzie:
Split-DNS (Split-Horizon DNS) - Architektura serwerów DNS zwracająca odmienne adresy IP dla tych samych nazw w zależności od źródła zapytania (wewnętrzne i publiczne).
DMZ (Demilitarized Zone) - Strefa zdemilitaryzowana dla publicznych serwerów usługowych kampusu.

35/54

Uczelniane serwery autorytatywne

Zarządzanie oficjalnymi bazami danych stref uczelni.

Wykład 6: Uczelniane serwery autorytatywne

  • Rola serwera autorytatywnego (Authoritative Name Server): serwer przechowujący oficjalny, wzorcowy plik strefy dla danej domeny i udzielający wiążących odpowiedzi.
  • Redundancja: wymóg posiadania co najmniej dwóch niezależnych serwerów autorytatywnych (Primary Master oraz Secondary Slave).
  • Mechanizm transferu strefy (AXFR / IXFR): bezpieczna replikacja zmian w bazie rekordów z serwera nadrzędnego na serwery zapasowe zabezpieczona kluczami transakcyjnymi TSIG (RFC 2845).
  • Rozproszenie geograficzne serwerów Secondary (często lokowanych na partnerskich uczelniach w sieci PIONIER).
Uczelniane serwery autorytatywne przechowują wzorcowe pliki strefy dla domeny uczelnianej; wdrożenie wymaga geograficznej dywersyfikacji serwerów Primary i Secondary.
Ilustracja techniczna do slajdu 35: Uczelniane serwery autorytatywne

Uczelniane serwery autorytatywne (Authoritative Name Servers) przechowują oryginalne, wzorcowe pliki strefy dla domeny uniwersytetu i odpowiadają za strefę z flagą Authoritative Answer (AA). Zgodnie z wymogami IETF uczelnia musi posiadać co najmniej dwa niezależne serwery: Primary (Master) oraz Secondary (Slave).

Dobrą praktyką inżynierską jest geograficzna dywersyfikacja serwera Secondary - umieszczenie go poza terenem kampusu (np. w partnerskim węźle sieci miejskiej MAN lub u operatora krajowego), co zapewnia dostępność domeny nawet w przypadku awarii łączy uczelni.

Dobrą praktyką inżynierską jest rozproszenie geograficzne serwerów autorytatywnych (Primary i Secondary DNS) w odmiennych klasach adresowych oraz w różnych centrach danych lub u zewnętrznych operatorów akademickich (np. PIONIER). Synchronizacja stref odbywa się za pomocą mechanizmu AXFR/IXFR zabezpieczonego kluczami kryptograficznymi TSIG (Transaction Signature, RFC 2845), co zapobiega manipulacji zawartością strefy przez nieuprawnione węzły sieciowe.

Skróty użyte w tym slajdzie:
SOA (Start of Authority) - Podstawowy rekord strefy DNS zawierający informacje o strefie, serwerze nadrzędnym i numerze seryjnym wersji.
NS Record (Name Server Record) - Rekord DNS wskazujący autorytatywne serwery nazw delegowane dla określonej strefy domenowej.

36/54

Wewnętrzne serwery buforujące i rekurencyjne (DNS Caching Recursor)

Obsługa setek tysięcy zapytań użytkowników kampusu.

Wykład 6: Wewnętrzne serwery buforujące i rekurencyjne (DNS Caching Recursor)

  • Pojęcie rekurencji: proces, w którym serwer DNS w imieniu stacji roboczej odpytuje kolejne serwery w globalnym drzewie DNS w celu ustalenia adresu zewnętrznego (np. adresu portalu naukowego).
  • Pamięć podręczna (DNS Cache): zapamiętywanie uzyskanych odpowiedzi na czas określony parametrem TTL (Time To Live).
  • Znaczne skrócenie opóźnień: kolejne zapytanie o tę samą domenę od dowolnego innego studenta w kampusie jest obsługiwane lokalnie w czasie poniżej 1 ms bez wysyłania ruchu do Internetu.
  • Odciążenie łączy internetowych uczelni.
Wewnętrzne serwery buforujące (DNS Caching Recursors) obsługują zapytania stacji roboczych i przechowują odpowiedzi w lokalnej pamięci podręcznej na czas określony parametrem TTL, redukując ruch szkieletowy.
Ilustracja techniczna do slajdu 36: Wewnętrzne serwery buforujące i rekurencyjne (DNS Caching Recursor)

Wewnętrzne serwery rekurencyjne i buforujące (DNS Caching Recursors, np. BIND9, Unbound, PowerDNS Recursor) obsługują bezpośrednie zapytania stacji roboczych studentów i pracowników. Ich zadaniem jest przejście przez całe drzewo DNS w celu odnalezienia odpowiedzi na pytania o domeny zewnętrzne.

Pobrane odpowiedzi są zapisywane w lokalnej pamięci podręcznej (Cache) na czas określony parametrem TTL (Time-To-Live). Znacznie przyspiesza to ładowanie stron internetowych, odciąża łącza szkieletowe i redukuje zapytania kierowane do globalnych serwerów root.

Wydajne serwery rekurencyjne (takie jak Unbound czy BIND9) redukują ruch na łączu do Internetu nawet o 70-80% dzięki lokalnemu buforowaniu często powtarzających się zapytań o popularne serwisy zewnętrzne. Kluczowym zagadnieniem bezpieczeństwa jest ograniczenie dostępu rekurencyjnego wyłącznie do uczelnianych podsieci IP (funkcja allow-recursion), co zapobiega wykorzystaniu uczelnianych serwerów jako wzmacniaczy w atakach wolumetrycznych DNS Amplification DDoS.

Skróty użyte w tym slajdzie:
TTL (Time to Live) - Czas w sekundach określający ważność rekordu DNS w lokalnej pamięci podręcznej resolwera buforującego.
Recursion (DNS Recursion) - Proces sekwencyjnego odpytywania serwerów w hierarchii DNS przez resolwer w imieniu klienta.

37/54

Filtrowanie zapytań DNS: strefy polityki odpowiedzi (DNS RPZ)

DNS jako pierwsza linia obrony przed cyberzagrożeniami.

Wykład 6: Filtrowanie zapytań DNS: strefy polityki odpowiedzi (DNS RPZ)

  • Koncepcja DNS RPZ (Response Policy Zones) / DNS Firewall.
  • Integracja z bazami Threat Intelligence (np. CERT Polska, bazy NASK, komercyjne źródła analityczne).
  • Zasada działania: gdy zainfekowany komputer studenta lub pracownika próbuje połączyć się z domeną znanego serwera Command and Control (C2) lub domeną wyłudzającą dane (phishing), lokalny serwer DNS przechwytuje zapytanie.
  • Modyfikacja odpowiedzi w locie: serwer zamiast prawdziwego IP zwraca błąd NXDOMAIN lub kieruje przeglądarkę na uczelnianą stronę ostrzegawczą (tzw. DNS Sinkhole).
  • Zablokowanie komunikacji ze złośliwym oprogramowaniem zanim dojdzie do wycieku danych lub zaszyfrowania dysków przez ransomware.
Response Policy Zone (DNS RPZ) to mechanizm zapory ogniowej DNS umożliwiający automatyczne blokowanie zapytań do domen przejętych przez cyberprzestępców, serwerów C2 złośliwego oprogramowania i witryn phishingowych.
Ilustracja techniczna do slajdu 37: Filtrowanie zapytań DNS: strefy polityki odpowiedzi (DNS RPZ)

Ochronę użytkowników w kampusie zapewnia wdrożenie stref polityki odpowiedzi - DNS RPZ (Response Policy Zone), nazywanych DNS Firewall. Technologia ta pozwala serwerowi rekurencyjnemu na modyfikację odpowiedzi DNS w locie na podstawie list zagrożeń (źródeł Threat Intelligence).

Gdy zainfekowany komputer studenta próbuje połączyć się ze zidentyfikowaną domeną złośliwego oprogramowania (Command & Control, phishing, serwery ransomware), resolwer DNS blokuje zapytanie (zwraca NXDOMAIN) lub przekierowuje przeglądarkę na uczelnianą stronę ostrzegawczą.

Mechanizm DNS RPZ (Response Policy Zones) przekształca serwer rekurencyjny w aktywny punkt kontroli bezpieczeństwa sieciowego. Na podstawie dynamicznie aktualizowanych list zagrożeń (Threat Intelligence feeds) serwer może modyfikować odpowiedzi DNS dla zapytań kierowanych do domen rozpowszechniających złośliwe oprogramowanie lub serwerów dowodzenia botnetami (C2), zwracając kod błędu NXDOMAIN lub przekierowując użytkownika na bezpieczną stronę ostrzegawczą.

Skróty użyte w tym slajdzie:
RPZ (Response Policy Zones) - Standard IETF pozwalający na modyfikowanie odpowiedzi DNS w celu blokowania złośliwych domen i phishingu.
Threat Intel (Threat Intelligence) - Dane wywiadowcze o zagrożeniach, adresach C2 i domenach dystrybuujących złośliwe oprogramowanie.

38/54

Zastosowanie DNS Sinkhole w analizie incydentów

Wykrywanie zainfekowanych stacji roboczych w sieci.

Wykład 6: Zastosowanie DNS Sinkhole w analizie incydentów

  • Monitorowanie zapytań trafiających do DNS Sinkhole przez zespół bezpieczeństwa uczelni (CSIRT/SOC).
  • Natychmiastowa identyfikacja adresu IP stacji roboczej w kampusie, która odpytuje o zablokowaną domenę.
  • Powiadomienie administratora o konieczności odizolowania danego komputera i przeprowadzenia procedury dekontaminacji.
  • Precyzyjne określenie wektora infekcji.
Technologia DNS Sinkhole przekierowuje zapytania do złośliwych domen na adres serwera-pułapki, umożliwiając zespołom bezpieczeństwa CSIRT precyzyjną identyfikację i izolację zainfekowanych hostów.
Ilustracja techniczna do slajdu 38: Zastosowanie DNS Sinkhole w analizie incydentów

Mechanizm DNS Sinkhole jest rozszerzeniem ochrony DNS RPZ wykorzystywanym w analizie i zwalczaniu incydentów bezpieczeństwa. Zamiast blokować złośliwą domenę, serwer DNS fałszuje odpowiedź, podając adres IP specjalnego uczelnianego serwera-pułapki (Sinkhole Server).

Wszystkie próby nawiązania połączenia przez zainfekowane hosty trafiają do serwera-pułapki, co pozwala zespołowi bezpieczeństwa (CSIRT/SOC) na precyzyjną identyfikację skompromitowanych maszyn w sieci, analizę wektora infekcji i natychmiastową izolację portu przełącznika.

Technika DNS Sinkhole stanowi nieocenione narzędzie dla uczelnianych zespołów CSIRT/SOC. Zamiast blokować złośliwy ruch bez powiadomienia, zapytania o zidentyfikowane domeny przestępcze są przekierowywane na dedykowany serwer telemetryczny (tzw. zlew - Sinkhole). Pozwala to na precyzyjną identyfikację zainfekowanych stacji roboczych w kampusie na podstawie logów połączeń HTTP/HTTPS trafiających do serwera pułapki i natychmiastowe skierowanie ich do kwarantanny.

Skróty użyte w tym slajdzie:
Sinkhole (DNS Sinkhole) - Technika przekierowywania zapytań do niebezpiecznych domen na kontrolowany adres IP w celu analizy zainfekowanych stacji.
C2 (Command and Control) - Serwer kontroli wykorzystywany przez cyberprzestępców do zdalnego zarządzania botnetem.

39/54

Resolwery zewnętrzne i standardy szyfrowania zapytań DNS

Ewolucja protokołu DNS w stronę ochrony prywatności.

Wykład 6: Resolwery zewnętrzne i standardy szyfrowania zapytań DNS

  • Podatność tradycyjnego DNS: wszystkie zapytania są przesyłane jawnym tekstem przez port 53 UDP/TCP; każdy węzeł pośredni, dostawca usług internetowych lub intruz w sieci Wi-Fi może podejrzeć, jakie strony odwiedza użytkownik.
  • Ryzyko manipulacji: ataki typu DNS Spoofing / Cache Poisoning (wprowadzanie fałszywych adresów IP do pamięci podręcznej serwera).
  • Wprowadzenie standardów szyfrowania kanału zapytań pomiędzy klientem a serwerem rekurencyjnym:
  • DNS over TLS (DoT - RFC 7858).
  • DNS over HTTPS (DoH - RFC 8484).
  • Zabezpieczenie przed podsłuchem i manipulacją zapytaniami.
Wybór zewnętrznych resolwerów DNS i wdrożenie szyfrowania chronią przed podsłuchem w sieciach publicznych, lecz wewnątrz kampusu wymagają ścisłej integracji z systemami monitoringu bezpieczeństwa.
Ilustracja techniczna do slajdu 39: Resolwery zewnętrzne i standardy szyfrowania zapytań DNS

Tradycyjny protokół DNS przesyła zapytania w postaci jawnego tekstu (Cleartext) za pośrednictwem pakietów UDP na porcie 53, co umożliwia ich łatwy podsłuch, profilowanie użytkowników oraz ataki fałszowania odpowiedzi (DNS Spoofing). W odpowiedzi powstały standardy szyfrowania ruchu DNS.

Wybór zewnętrznych resolwerów buforujących (np. resolwery operatora PIONIER, Quad9 czy Cloudflare) oraz implementacja protokołów kryptograficznych na styku z Internetem podnoszą bezpieczeństwo, lecz wewnątrz kampusu wymagają precyzyjnego zarządzania politykami audytowymi.

Wysyłanie nieszyfrowanych zapytań DNS w postaci otwartego tekstu (Cleartext) naraża użytkowników na podsłuch profilu przeglądania przez dostawców Internetu lub lokalnych intruzów oraz umożliwia fałszowanie odpowiedzi (DNS Spoofing). Wdrożenie szyfrowania pomiędzy stacjami roboczymi a serwerami DNS podnosi poziom prywatności, jednak stawia przed administratorami wyzwanie zachowania widoczności ruchu w celach ochrony przed zagrożeniami wewnętrznymi.

Skróty użyte w tym slajdzie:
Plaintext DNS (Unencrypted DNS) - Tradycyjne przesyłanie zapytań DNS jawnym tekstem przez port UDP/TCP 53 narażone na podsłuch i manipulację.
TLS (Transport Layer Security) - Kryptograficzny protokół zapewniający poufność i integralność transmisji danych (RFC 8446).

40/54

DNS over TLS (DoT) oraz DNS over HTTPS (DoH)

Porównanie dwóch wiodących standardów kryptograficznych.

Wykład 6: DNS over TLS (DoT) oraz DNS over HTTPS (DoH)

  • DNS over TLS (DoT - RFC 7858): szyfrowanie zapytań DNS protokołem TLS na dedykowanym porcie TCP 853.
  • Zaleta DoT: wyraźna separacja architektoniczna, łatwość monitorowania i zarządzania przez administratorów zapór sieciowych w kampusie.
  • DNS over HTTPS (DoH - RFC 8484): pakowanie zapytań DNS w standardowe ramki protokołu HTTP/2 lub HTTP/3 na porcie TCP 443, tym samym, który obsługuje ruch WWW.
  • Cechy DoH: ukrycie zapytań DNS w strumieniu standardowego ruchu HTTPS, brak możliwości łatwego zablokowania przez zapory ogniowe.
  • Wyzwanie inżynierskie - kontrola szyfrowanego DNS (DoH/DoT) w kampusie: blokowanie portu TCP 853 (DoT) oraz publicznych resolwerów DoH na zaporze NGFW, wraz z wdrożeniem domeny kanarkowej (Canary Domain: `use-application-dns.net` zwracającej NXDOMAIN), co zmusza przeglądarki do korzystania z uczelnianego resolwera chronionego przez DNS RPZ i Sinkhole.
Protokoły szyfrowania DNS (DoT - RFC 7858 oraz DoH - RFC 8484) chronią prywatność użytkowników; w kampusie wdraża się domenę kanarkową (use-application-dns.net) w celu wymuszenia korzystania z chronionego DNS uczelni.
Ilustracja techniczna do slajdu 40: DNS over TLS (DoT) oraz DNS over HTTPS (DoH)

Dwa wiodące standardy szyfrowania DNS to DNS over TLS (DoT - RFC 7858, dedykowany port TCP 853) oraz DNS over HTTPS (DoH - RFC 8484, port TCP 443 w strumieniu standardowego ruchu WWW). DoH ukrywa zapytania użytkownika, uniemożliwiając ich prostą inspekcję przez zapory sieciowe.

W sieci kampusowej powszechne stosowanie publicznego DoH w przeglądarkach stwarza ryzyko ominięcia uczelnianych filtrów DNS RPZ. Inżynierowie blokują port 853, filtrują znane publiczne IP resolwerów DoH oraz wdrażają domenę kanarkową (use-application-dns.net), wymuszając korzystanie przez stacje z chronionego DNS uczelni.

Z punktu widzenia inżynierii sieciowej DoT (RFC 7858) korzysta z dedykowanego portu TCP 853, co umożliwia łatwe monitorowanie i zarządzanie ruchem na zaporach sieciowych, podczas gdy DoH (RFC 8484) miksuje ruch DNS ze standardowym ruchem HTTPS na porcie TCP 443. W sieciach kampusowych administratorzy często blokują publiczne serwery DoH na brzegu sieci, wymuszając korzystanie z wewnętrznych uczelnianych resolwerów DoT/DoH, co pozwala połączyć szyfrowanie z lokalnym filtrowaniem zagrożeń RPZ.

Skróty użyte w tym slajdzie:
HTTPS (Hypertext Transfer Protocol Secure) - Szyfrowana wersja protokołu HTTP działająca na podstawie TLS (port TCP 443).
Canary Domain - Specjalna domena (np. use-application-dns.net) sprawdzana przez aplikacje w celu weryfikacji blokady DoH w sieci lokalnej.

41/54

Integralność i uwierzytelnianie danych: protokół DNSSEC

Kryptograficzne podpisywanie rekordów strefy domenowej.

Wykład 6: Integralność i uwierzytelnianie danych: protokół DNSSEC

  • Standard DNSSEC (DNS Security Extensions według RFC 4033, 4034, 4035).
  • Zasada działania: każdy rekord w strefie DNS jest podpisywany cyfrowo kluczem asymetrycznym administratora strefy (rekord RRSIG).
  • Łańcuch zaufania (Chain of Trust): weryfikacja podpisów od strefy głównej (root), przez domenę TLD `.pl`, aż do rekordu domeny uczelni.
  • Walidacja na serwerze buforującym: serwer odrzuca odpowiedź, jeśli podpis kryptograficzny jest niepoprawny lub został zmodyfikowany w locie.
  • Ochrona przed atakami podszywania się pod banki, systemy płatności i portale uczelniane.
Rozszerzenia DNSSEC (RFC 4033) zapewniają autentyczność i integralność odpowiedzi DNS za pomocą podpisów cyfrowych RRSIG, chroniąc przed atakami DNS Cache Poisoning.
Ilustracja techniczna do slajdu 41: Integralność i uwierzytelnianie danych: protokół DNSSEC

Standard DNSSEC (DNS Security Extensions, RFC 4033) rozwiązuje problem integralności i autentyczności danych w systemie DNS za pomocą kryptografii asymetrycznej. Każdy rekord w strefie DNS zostaje cyfrowo podpisany kluczem prywatnym administratora (rekordy RRSIG).

Serwer rekurencyjny weryfikuje podpis przy użyciu klucza publicznego (DNSKEY) na podstawie łańcucha zaufania (Chain of Trust) prowadzącego do klucza strefy głównej (Root). Chroni to użytkowników przed atakiem zatruwania pamięci podręcznej DNS (DNS Cache Poisoning / Kaminsky Attack).

Protokół DNSSEC wprowadza łańcuch zaufania (Chain of Trust) oparty na asymetrycznej kryptografii klucza publicznego, rozpoczynający się od podpisanej strefy głównej (Root Zone). Rekordy RRSIG przechowują cyfrowe podpisy zestawów rekordów, rekordy DNSKEY zawierają klucze publiczne, a rekordy DS (Delegation Signer) powiązują kryptograficznie strefę podrzędną z nadrzędną, co gwarantuje, że otrzymana odpowiedź DNS nie została sfałszowana przez atakującego w locie (DNS Cache Poisoning).

Jednym z kluczowych wyzwań inżynierskich w protokole DNSSEC było zapewnienie kryptograficznego uwierzytelnienia faktu, że dana nazwa domenowa nie istnieje (Authenticated Denial of Existence). Zamiast dynamicznego podpisywania odpowiedzi o błędzie NXDOMAIN, co przeciążyłoby procesory serwerów autorytatywnych, wprowadzono rekordy NSEC oraz ich bezpieczniejszą, kryptograficznie zabezpieczoną funkcją skrótu wersję NSEC3 (RFC 5155), które dowodzą braku szukanego wpisu bez ujawniania pełnej zawartości strefy DNS.

Skróty użyte w tym slajdzie:
DNSSEC (DNS Security Extensions) - Zestaw rozszerzeń kryptograficznych (RFC 4033) zapewniających uwierzytelnianie pochodzenia i integralność danych w DNS.
RRSIG (Resource Record Signature) - Rekord DNS zawierający podpis cyfrowy dla powiązanego zestawu rekordów RRset.
DNSKEY (DNS Public Key) - Rekord zawierający klucz publiczny strefy DNS służący do weryfikacji podpisów cyfrowych RRSIG.

42/54

Podstawowe aplikacyjne usługi kampusowe: serwery WWW

Wymagania infrastrukturalne dla uczelnianych portali internetowych.

Wykład 6: Podstawowe aplikacyjne usługi kampusowe: serwery WWW

  • Oprogramowanie serwerowe: Apache HTTP Server, Nginx, LiteSpeed.
  • Rola serwerów WWW: publikacja strony głównej uczelni, stron wydziałowych, serwisów rekrutacyjnych, platform e-learningowych (Moodle).
  • Wymogi wysokiej dostępności: praca w klastrach za systemami równoważenia obciążenia (Load Balancing).
  • Bezpieczeństwo połączeń: konieczność stosowania protokołu HTTPS (TLS 1.3) z certyfikatami publicznymi (np. certyfikaty akademickie GEANT TCS / Sectigo lub Let's Encrypt).
Uczelniane portale WWW umieszcza się w dedykowanej strefie DMZ, zapewniając bezpieczną komunikację szyfrowaną protokołem HTTPS (TLS 1.3) oraz sprzętowe równoważenie obciążenia na kontrolerach ADC.
Ilustracja techniczna do slajdu 42: Podstawowe aplikacyjne usługi kampusowe: serwery WWW

Podstawowymi aplikacjami sieciowymi kampusu są uczelniane portale WWW (systemy dziekanatowe, serwery USOS, platformy e-learningowe Moodle, strony wydziałowe). Ich projektowanie wymaga rozdzielenia warstwy prezentacji (frontend: NGINX, Apache) od warstwy logiki biznesowej i baz danych.

Serwery WWW umieszcza się w dedykowanej strefie zdemilitaryzowanej (DMZ). Dostęp z zewnątrz realizowany jest wyłącznie z wykorzystaniem szyfrowanego protokołu HTTPS (TLS 1.3) ze sprzętowym odciążaniem kryptograficznym na kontrolerach Application Delivery Controller (ADC) lub zaporach NGFW.

Nowoczesne serwery WWW w kampusie (np. oparte na Nginx lub Apache) funkcjonują w architekturze Reverse Proxy, terminując szyfrowane sesje TLS 1.3 i buforując zasoby statyczne przed farmami serwerów aplikacyjnych. Wykorzystanie protokołów HTTP/2 i HTTP/3 (bazującego na protokole transportowym QUIC/UDP) pozwala na multipleksowanie wielu strumieni danych w ramach jednego połączenia, co drastycznie skraca czas ładowania serwisów uczelnianych na urządzeniach mobilnych.

Skróty użyte w tym slajdzie:
HTTP (Hypertext Transfer Protocol) - Protokół przesyłania dokumentów hipertekstowych w sieci WWW (RFC 9110).
SSL (Secure Sockets Layer) - Historyczny protokół szyfrowania zastąpiony standardem TLS.
HSTS (HTTP Strict Transport Security) - Mechanizm bezpieczeństwa (RFC 6797) wymuszający na przeglądarce łączenie się wyłącznie przez szyfrowany protokół HTTPS.

43/54

Bezpieczny transfer plików na uczelni: protokoły SFTP i FTPS

Wycofanie nieszyfrowanego protokołu FTP z infrastruktury akademickiej.

Wykład 6: Bezpieczny transfer plików na uczelni: protokoły SFTP i FTPS

  • Niebezpieczeństwo tradycyjnego protokołu FTP (RFC 959): nazwy użytkowników i hasła oraz przesyłane pliki transmitowane jawnym tekstem przez port 21 TCP.
  • Protokół SFTP (SSH File Transfer Protocol): bezpieczny podsystem protokołu SSH (port 22 TCP) zapewniający silne szyfrowanie i uwierzytelnianie kluczami publicznymi; standard dla administratorów i laboratoriów programistycznych.
  • Protokół FTPS (FTP over SSL/TLS): tradycyjny protokół FTP opakowany w warstwę kryptograficzną TLS.
  • Rekomendacja inżynierska: całkowita blokada nieszyfrowanego portu 21 FTP na brzegowych zaporach ogniowych uczelni.
Bezpieczny transfer plików na uczelni opiera się na protokole SFTP (SSH File Transfer Protocol) działającym w tunelu SSH (port TCP 22), eliminując podatności przestarzałych protokołów FTP i TFTP.
Ilustracja techniczna do slajdu 43: Bezpieczny transfer plików na uczelni: protokoły SFTP i FTPS

W uczelnianej infrastrukturze przestarzałe, nieszyfrowane protokoły FTP i TFTP zostały zastąpione przez SFTP (SSH File Transfer Protocol). Jest on podstawowym protokołem działającym wewnątrz bezpiecznego tunelu SSH (port TCP 22) z silnym uwierzytelnianiem kluczami asymetrycznymi.

Alternatywnym rozwiązaniem w środowiskach wieloplatformowych jest FTPS (FTP over TLS/SSL), który enkapsuluje klasyczny protokół FTP w sesji TLS. Wybór SFTP jest preferowany ze względu na prostotę konfiguracji zapór sieciowych (pojedynczy port TCP).

Fundamentalną różnicą inżynierską pomiędzy SFTP a FTPS jest wykorzystywany stos protokołów: SFTP jest podsystemem protokołu SSH działającym w ramach pojedynczego strumienia TCP na porcie 22, co czyni go wyjątkowo przyjaznym dla zapór sieciowych i translacji NAT. Z kolei FTPS to klasyczny protokół FTP opakowany w warstwę TLS, który podobnie jak FTP wymaga otwierania wielu losowych portów danych (tryb Passive FTP), co komplikuje konfigurację reguł filtrowania na brzegowych firewallach.

Skróty użyte w tym slajdzie:
SFTP (SSH File Transfer Protocol) - Protokół bezpiecznego transferu plików działający wewnątrz szyfrowanej sesji SSH (port TCP 22).
FTPS (FTP over SSL/TLS) - Protokół FTP rozszerzony o warstwę kryptograficzną TLS wykorzystujący oddzielne kanały sterowania i danych.
SSH (Secure Shell) - Kryptograficzny protokół zdalnego dostępu i zarządzania systemami operacyjnymi (RFC 4253).

44/54

Architektura uczelnianych serwerów plików: protokół SMB/CIFS

Udostępnianie zasobów dyskowych dla środowisk Windows i laboratoriów.

Wykład 6: Architektura uczelnianych serwerów plików: protokół SMB/CIFS

  • Protokół SMB (Server Message Block, wersje SMB 2.1, SMB 3.0, SMB 3.1.1) działający na porcie 445 TCP.
  • Zastosowanie: montowanie dysków sieciowych użytkowników (katalogi domowe, profile mobilne, współdzielone zasoby katedr i dziekanatów).
  • Integracja z Active Directory: uprawnienia do folderów oparte na listach kontroli dostępu NTFS i grupach domenowych.
  • Szyfrowanie SMB Encryption (SMB 3.x): ochrona przesyłanych plików przed podsłuchem wewnątrz sieci lokalnej bez konieczności stosowania tuneli IPsec.
Protokół SMBv3 (Server Message Block) stanowi standard udostępniania plików w środowiskach biurowych, oferując wbudowane szyfrowanie transmisji oraz mechanizm wielokanałowości SMB Multichannel.
Ilustracja techniczna do slajdu 44: Architektura uczelnianych serwerów plików: protokół SMB/CIFS

W środowiskach biurowych i laboratoriach opartych na systemach Microsoft Windows dominującym standardem udostępniania plików jest protokół Server Message Block (SMB/CIFS, port TCP 445). Nowoczesne wdrożenia bazują wyłącznie na protokole SMBv3.

Protokół SMBv3 wprowadza pełne szyfrowanie danych w locie (SMB Encryption), mechanizm wielokanałowości (SMB Multichannel) zwiększający przepustowość oraz integrację z klastrami plików wysokiej dostępności (Scale-Out File Server). Przestarzałe wersje SMBv1 i SMBv2 są blokowane ze względów bezpieczeństwa.

W środowiskach kampusowych zintegrowanych z usługą katalogową Microsoft Active Directory protokół SMB3 stanowi standard wymiany plików biurowych i profili mobilnych. Nowoczesne wersje SMB (od wersji 3.0) wprowadzają natywne, sprzętowo akcelerowane szyfrowanie AES całego ruchu plikowego oraz mechanizm SMB Multichannel, który pozwala na jednoczesne wykorzystanie wielu kart sieciowych w serwerze plików, podwajając lub czterokrotnie zwiększając przepustowość transferu danych bez konieczności konfiguracji agregacji LACP.

Skróty użyte w tym slajdzie:
SMB (Server Message Block) - Protokół sieciowy współdzielenia plików, drukarek i portów szeregowych w środowiskach Microsoft Windows (port TCP 445).
CIFS (Common Internet File System) - Historyczny dialekt protokołu SMB1 zastąpiony nowoczesnymi protokołami SMBv2/SMBv3.

45/54

Architektura serwerów plików: protokół NFS w środowiskach badawczych

Sieciowy system plików dla laboratoriów Linux i klastrów obliczeniowych.

Wykład 6: Architektura serwerów plików: protokół NFS w środowiskach badawczych

  • Standard IETF RFC 7530 (NFSv4) oraz RFC 5661 (NFSv4.1): Network File System.
  • Zastosowanie w kampusie: laboratoria studenckie pracujące pod kontrolą systemów Linux, montowanie wspólnych katalogów `/home`, węzły klastrów obliczeniowych HPC.
  • Zalety NFSv4: praca na pojedynczym porcie TCP 2049 (łatwiejsza konfiguracja zapór sieciowych niż w NFSv3, który wymagał portmappera).
  • Bezpieczeństwo: integracja z protokołem Kerberos (RPCSEC_GSS) zapewniająca silne uwierzytelnianie użytkowników i szyfrowanie transmisji.
Protokół Network File System (NFSv4) to sieciowy system plików dla środowisk badawczych i klastrów linuksowych HPC, działający na porcie TCP 2049 z integracją uwierzytelniania Kerberos.
Ilustracja techniczna do slajdu 45: Architektura serwerów plików: protokół NFS w środowiskach badawczych

W środowiskach klastrów obliczeniowych HPC (High Performance Computing) oraz laboratoriach uniksowych i linuksowych podstawowym standardem wymiany plików jest protokół Network File System (NFS). Wersja NFSv4 (RFC 7530) eliminuje konieczność stosowania demona rpcbind i portmappera.

NFSv4 działa na pojedynczym porcie TCP 2049, oferuje zintegrowane szyfrowanie i uwierzytelnianie Kerberos (RPCSEC_GSS) oraz umożliwia budowę rozproszonych klastrów pamięci masowej dla zaawansowanych symulacji naukowych i przetwarzania danych Big Data.

Protokół NFS (Network File System) jest fundamentem środowisk uniksowych oraz klastrów obliczeniowych HPC. Wersja NFSv4 (RFC 7530) wprowadziła jednolitą komunikację stanową przez port TCP 2049, eliminując zależność od historycznej usługi portmap/rpcbind oraz integrując uwierzytelnianie Kerberos (RPCSEC_GSS). Pozwala to badaczom na bezpieczny i wydajny montaż zdalnych katalogów z danymi eksperymentalnymi na tysiącach węzłów obliczeniowych jednocześnie.

Skróty użyte w tym slajdzie:
NFS (Network File System) - Protokół rozproszonego systemu plików powszechnie stosowany w środowiskach uniksowych i klastrach HPC (RFC 7530).
HPC (High-Performance Computing) - Wysokowydajne klastry obliczeniowe wykorzystywane w uczelnianych badaniach naukowych.

46/54

Pamięć masowa SAN i protokoły blokowe iSCSI w centrum danych kampusu

Infrastruktura dyskowa dla klastrów wirtualizacji.

Wykład 6: Pamięć masowa SAN i protokoły blokowe iSCSI w centrum danych kampusu

  • Różnica między pamięcią plikową (NAS - SMB/NFS) a pamięcią blokową (SAN).
  • Protokół iSCSI (Internet Small Computer Systems Interface - RFC 7143): enkapsulacja blokowych poleceń SCSI w pakiety TCP/IP (port 3260 TCP).
  • Zastosowanie: podłączanie macierzy dyskowych do serwerów wirtualizacji (VMware ESXi, Proxmox VE, Hyper-V) przez standardową sieć Ethernet 10G/25G.
  • Wymóg inżynierski: wydzielenie dedykowanego, odizolowanego VLAN-u Storage z podwyższonym MTU (Jumbo Frames, 9000 bajtów) bez dostępu do Internetu.
Sieci pamięci masowych SAN w centrum danych kampusu wykorzystują protokół iSCSI enkapsulujący polecenia blokowe SCSI w pakietach TCP/IP, wymagając wsparcia dla Jumbo Frames (MTU 9000) i kontroli przepływu PFC.
Ilustracja techniczna do slajdu 46: Pamięć masowa SAN i protokoły blokowe iSCSI w centrum danych kampusu

Zaplecze pamięci masowych centrum danych kampusu opiera się na sieciach pamięci masowej (SAN - Storage Area Network). Obok kosztownych instalacji Fibre Channel (FC), dominującym standardem na uczelniach jest protokół iSCSI (Internet Small Computer System Interface, RFC 7143).

Protokół iSCSI enkapsuluje polecenia blokowe SCSI bezpośrednio w pakietach TCP/IP (port 3260), umożliwiając transmisję po standardowym okablowaniu Ethernet 10G/25G/100G. Wymaga to jednak dedykowanych sieci VLAN, włączenia ramek Jumbo Frames (MTU 9000) oraz mechanizmów kontroli przepływu (PFC / 802.3x).

Protokół iSCSI umożliwia budowę skalowalnych sieci pamięci masowych SAN z wykorzystaniem istniejącej, taniej infrastruktury ethernetowej (np. 10GbE / 25GbE) zamiast drogich przełączników Fibre Channel. W celu zapewnienia stabilności transmisji blokowej w sieciach iSCSI kluczowe jest wdrożenie technologii DCB (Data Center Bridging), w tym mechanizmu Priority-Based Flow Control (PFC, IEEE 802.1Qbb), który zapobiega gubieniu pakietów i retransmisjom TCP podczas chwilowego nasycenia buforów przełącznika.

Skróty użyte w tym slajdzie:
SAN (Storage Area Network) - Dedykowana sieć wysokiej przepustowości łącząca serwery z macierzami dyskowymi.
iSCSI (Internet Small Computer Systems Interface) - Protokół transportu poleceń blokowych SCSI przez standardowe pakiety TCP/IP (RFC 7143).
Jumbo Frames (Jumbo Frames) - Ramki Ethernet o powiększonej jednostce MTU (zazwyczaj 9000 bajtów) redukujące narzut CPU w transmisji pamięci masowych.

47/54

Konteneryzacja w infrastrukturze usług sieciowych: wprowadzenie

Ewolucja metod wdrażania usług: od serwerów fizycznych przez maszyny wirtualne do kontenerów.

Wykład 6: Konteneryzacja w infrastrukturze usług sieciowych: wprowadzenie

  • Ograniczenia tradycyjnych maszyn wirtualnych (VM): każda VM potrzebuje pełnego systemu operacyjnego, zużywa gigabajty pamięci RAM i ma długi czas rozruchu.
  • Koncepcja konteneryzacji: współdzielenie jądra systemu operacyjnego (Kernel Sharing) przy zachowaniu pełnej izolacji przestrzeni procesów, sieci i systemów plików.
  • Zalety platformy Docker w sieci kampusowej: uruchomienie usługi (np. serwera rekurencyjnego DNS, serwera NTP czy proxy) w ułamku sekundy przy zużyciu kilkudziesięciu megabajtów pamięci.
  • Wzorzec architektury mikrousług: rozbicie monolitycznych systemów uczelnianych na niezależne kontenery.
Konteneryzacja w środowisku Docker pozwala na uruchamianie mikrousług sieciowych (DNS, DHCP, proxy) w lekkich, odizolowanych środowiskach współdzielących jedno jądro systemu operacyjnego Linux.
Ilustracja techniczna do slajdu 47: Konteneryzacja w infrastrukturze usług sieciowych: wprowadzenie

Współczesna architektura usług sieciowych ewoluuje od ciężkich maszyn wirtualnych do lekkiej konteneryzacji w środowisku Docker. Konteneryzacja pozwala na uruchamianie mikrousług (serwerów DNS, DHCP, RADIUS, proxy NGINX) w odizolowanych środowiskach współdzielących jedno jądro systemu operacyjnego Linux.

Zaletami podejścia kontenerowego są: krótki czas startu (ułamki sekund), minimalne zużycie pamięci RAM, łatwość automatyzacji CI/CD oraz bezproblemowe wdrażanie aktualizacji bez ryzyka zakłócenia pracy innych usług na tym samym serwerze fizycznym.

W odróżnieniu od klasycznych maszyn wirtualnych zarządzanych przez hipernadzorcę (Hypervisor Type 1 lub Type 2), kontenery współdzielą jądro systemu operacyjnego gospodarza (Host OS Kernel). Eliminuje to narzut na wirtualizację sprzętu i pozwala na uruchomienie setek niezależnych mikrousług (serwerów DNS, proxy, aplikacji laboratoryjnych) na pojedynczym fizycznym serwerze kasetowym w kampusowym centrum danych, redukując zapotrzebowanie na pamięć RAM i energię elektryczną.

Architektura mikrousług oparta na kontenerach doskonale wpisuje się w nowoczesne środowiska uczelniane, gdzie zachodzi potrzeba dynamicznego powoływania i usuwania setek instancji laboratoryjnych dla studentów. W przeciwieństwie do maszyn wirtualnych, których uruchomienie wymaga załadowania pełnego systemu operacyjnego wraz ze sterownikami i jądrem (co zajmuje kilkadziesiąt sekund), kontener startuje w ułamku sekundy, korzystając ze współdzielonego jądra Linuksa i izolowanych przestrzeni nazw.

Skróty użyte w tym slajdzie:
Container (Application Container) - Lekkie środowisko uruchomieniowe izolujące aplikację wraz z jej zależnościami na poziomie jądra systemu OS.
Docker (Docker Engine) - Powszechnie stosowana platforma konteneryzacji aplikacji wykorzystująca mechanizmy cgroups i namespaces.

48/54

Izolacja zasobów w kontenerach Docker

Mechanizmy jądra Linux stanowiące fundament konteneryzacji.

Wykład 6: Izolacja zasobów w kontenerach Docker

  • Mechanizm Namespaces (przestrzenie nazw): izolacja procesów (PID), punktów montowania (MNT), użytkowników (USER) oraz stosu sieciowego (NET).
  • Network Namespace (netns): każdy kontener posiada własny, całkowicie niezależny stos sieciowy, własne interfejsy wirtualne, własną tablicę routingu i własne reguły filtrowania iptables.
  • Mechanizm Control Groups (cgroups): ścisłe ograniczanie zużycia zasobów fizycznych hosta (np. kontener serwera DNS nie może zużyć więcej niż 1 rdzenia CPU i 512 MB RAM).
  • Bezpieczeństwo: awaria lub kompromitacja usługi w kontenerze nie daje intruzowi dostępu do systemu operacyjnego serwera fizycznego.
Izolacja kontenerów Docker bazuje na przestrzeniach nazw jądra Linuksa (w tym przestrzeni nazw net przydzielającej niezależny stos sieciowy) oraz grupach kontrolnych (cgroups) ograniczających zużycie procesora i pamięci.
Ilustracja techniczna do slajdu 48: Izolacja zasobów w kontenerach Docker

Mechanizm izolacji kontenerów Docker bazuje na dwóch podstawowych strukturach jądra Linuksa: przestrzeniach nazw (Namespaces) oraz grupach kontrolnych (cgroups). Przestrzenie nazw (PID, NET, MNT, IPC, UTS) tworzą iluzję dedykowanego systemu operacyjnego dla każdego kontenera.

Przestrzeń nazw net (netns) przydziela kontenerowi własny, wirtualny stos sieciowy: niezależne interfejsy wirtualne, własną tablicę routingu IP oraz niezależne reguły zapory ogniowej iptables/nftables, zapewniając separację od procesów gospodarza.

Izolacja kontenerów w systemie Linux opiera się na dwóch mechanizmach jądra: przestrzeniach nazw (Namespaces: pid, net, ipc, mnt, uts), które zapewniają każdemu kontenerowi własny, odizolowany widok stosu sieciowego, procesów i systemu plików, oraz grupach kontrolnych (cgroups), które precyzyjnie limitują zużycie procesora, pamięci RAM i pasma I/O. Dzięki temu błąd lub celowe przeciążenie generowane w jednym kontenerze dydaktycznym nie wpływa na stabilność pozostałych usług uczelnianych.

Skróty użyte w tym slajdzie:
cgroups (Control Groups) - Mechanizm jądra Linuksa ograniczający i monitorujący zużycie zasobów (CPU, pamięć RAM, I/O) przez procesy.
Namespaces (Linux Namespaces) - Mechanizm jądra izolujący przestrzeń procesów, sieci (netns), punktów montowania oraz użytkowników.

49/54

Wirtualne sieci w środowisku Docker: sterownik bridge

Domyślny model sieciowy dla usług działających na jednym hoście.

Wykład 6: Wirtualne sieci w środowisku Docker: sterownik bridge

  • Sterownik bridge (mostek sieciowy): Docker tworzy w systemie wirtualny przełącznik programowy (zazwyczaj interfejs `docker0`).
  • Para interfejsów wirtualnych veth (Virtual Ethernet Pair): jeden koniec interfejsu jest wpięty do mostka `docker0`, drugi koniec trafia do wnętrza kontenera jako interfejs `eth0`.
  • Translacja adresów NAT: kontenery otrzymują prywatne adresy z puli mostka (np. 172.17.0.0/16); ruch wychodzący do sieci kampusowej jest maskowany adresem IP fizycznego serwera.
  • Mapowanie portów (Port Forwarding): przekierowanie portu fizycznego serwera na port kontenera (np. `-p 53:53/udp` dla serwera DNS).
Domyślny sterownik sieciowy Docker Bridge tworzy wirtualny przełącznik programowy (docker0), zapewniając kontenerom łączność ze światem za pomocą translacji adresów NAT i mapowania portów w regułach iptables.
Ilustracja techniczna do slajdu 49: Wirtualne sieci w środowisku Docker: sterownik bridge

Domyślnym sterownikiem sieciowym w środowisku Docker jest sterownik Bridge. Tworzy on wewnątrz systemu gospodarza wirtualny przełącznik programowy (standardowo interfejs docker0), do którego podłączane są kontenery za pomocą par wirtualnych interfejsów ethernetowych (veth pairs).

Sterownik bridge tworzy prywatną podsieć (np. 172.17.0.0/16). Dostęp kontenera do świata zewnętrznego realizowany jest przez maskaradę IP (Source NAT), natomiast wystawianie usług kontenera na zewnątrz polega na mapowaniu portów TCP/UDP (Destination NAT) w regułach iptables hosta.

Sterownik bridge tworzy wirtualny mostek ethernetowy w przestrzeni jądra linuksowego gospodarza (standardowo docker0). Do mostka podłączane są wirtualne pary interfejsów (veth pairs), gdzie jeden koniec pary znajduje się w przestrzeni sieciowej kontenera (jako interfejs eth0), a drugi w przestrzeni głównej hosta. Ruch wychodzący do fizycznej sieci kampusu jest automatycznie tłumaczony za pomocą reguł maskarady (iptables/nftables MASQUERADE), co pozwala kontenerom na bezproblemowy dostęp do zasobów zewnętrznych.

Skróty użyte w tym slajdzie:
Bridge (Docker Bridge Network) - Domyślny wirtualny przełącznik programowy w środowisku Docker realizujący prywatną podsieć dla kontenerów.
veth (Virtual Ethernet Pair) - Para wirtualnych interfejsów sieciowych łączących przestrzeń sieciową kontenera z mostkiem w systemie nadrzędnym.

50/54

Zaawansowane sieci Docker: sterowniki host, macvlan i overlay

Integracja kontenerów bezpośrednio z siecią kampusową.

Wykład 6: Zaawansowane sieci Docker: sterowniki host, macvlan i overlay

  • Sterownik host: kontener współdzieli stos sieciowy bezpośrednio z fizycznym serwerem (brak narzutu NAT, maksymalna wydajność, ale brak izolacji portów).
  • Sterownik macvlan: przypisanie kontenerowi unikalnego adresu MAC; kontener staje się bezpośrednio widoczny w fizycznym VLAN-ie sieci kampusowej jako odrębne urządzenie i może pobierać własny adres z uczelnianego DHCP.
  • Sterownik overlay: tworzenie rozproszonych sieci wirtualnych VXLAN łączących kontenery uruchomione na wielu serwerach fizycznych w klastrze Docker Swarm lub Kubernetes.
  • Zastosowanie macvlan w kampusie: uruchamianie wirtualnych sond monitorujących i serwerów usług bezpośrednio w dedykowanych VLAN-ach budynkowych.
Zaawansowane sterowniki sieciowe Docker (host, macvlan, overlay) umożliwiają bezpośrednie wpięcie kontenerów do fizycznych sieci VLAN oraz budowę rozproszonych klastrów mikrousług Swarm/Kubernetes.
Ilustracja techniczna do slajdu 50: Zaawansowane sieci Docker: sterowniki host, macvlan i overlay

Dla zaawansowanych usług sieciowych Docker oferuje alternatywne sterowniki sieciowe: sterownik host (kontener współdzieli stos sieciowy z systemem gospodarza, brak narzutu NAT, idealny dla wysokowydajnych serwerów DNS) oraz sterownik macvlan.

Sterownik macvlan przydziela każdemu kontenerowi unikalny adres MAC i pozwala na bezpośrednie wpięcie kontenera do fizycznej sieci VLAN kampusu. Z kolei sterownik overlay wykorzystuje enkapsulację VXLAN do budowy sieci rozproszonych pomiędzy wieloma fizycznymi serwerami w klastrze Docker Swarm lub Kubernetes.

Wybór odpowiedniego sterownika sieciowego wynika ze specyfiki wdrożenia: sterownik host eliminuje mostek i daje maksymalną przepustowość sieciową kosztem utraty izolacji portów, sterownik macvlan przydziela każdemu kontenerowi unikalny adres fizyczny MAC i adres IP z fizycznej podsieci kampusowej, natomiast sterownik overlay (oparty na enkapsulacji VXLAN w protokole UDP na porcie 4789) umożliwia tworzenie rozproszonych sieci wirtualnych spinających kontenery uruchomione na wielu różnych serwerach fizycznych w klastrze Docker Swarm lub Kubernetes.

Skróty użyte w tym slajdzie:
Macvlan (Macvlan Network Driver) - Sterownik sieciowy przypisujący kontenerom indywidualne adresy MAC i podłączający je bezpośrednio do fizycznej sieci L2.
Overlay (Docker Overlay Network) - Wirtualna sieć nakładkowa (oparta na tunelowaniu VXLAN) łącząca kontenery uruchomione na wielu węzłach fizycznych.

51/54

Zarządzanie trwałością danych i bezpieczeństwo kontenerów

Dobre praktyki wdrażania usług sieciowych w Dockerze.

Wykład 6: Zarządzanie trwałością danych i bezpieczeństwo kontenerów

  • Efemeryczność kontenerów: kontener z założenia jest bezstanowy; usunięcie kontenera usuwa jego warstwę zapisu.
  • Wolumeny Docker (Docker Volumes): montowanie trwałych katalogów z serwera fizycznego lub macierzy NFS do wnętrza kontenera (np. trwałe przechowywanie stref DNS, logów czy baz danych).
  • Zasada minimalnych uprawnień: uruchamianie kontenerów bez uprawnień roota (Rootless Docker / Non-Root User).
  • Automatyzacja wdrażania za pomocą plików Docker Compose: deklaratywny opis powiązań między serwerem WWW, bazą danych i serwerem pamięci podręcznej w jednym pliku konfiguracyjnym YAML.
Bezpieczeństwo kontenerów wymaga oddzielenia danych ulotnych od trwałych wolumenów dyskowych oraz uruchamiania procesów w trybie bez uprawnień roota z ograniczeniem uprawnień Linux Capabilities.
Ilustracja techniczna do slajdu 51: Zarządzanie trwałością danych i bezpieczeństwo kontenerów

Bezpieczeństwo i trwałość danych w kontenerach sieciowych wymagają oddzielenia ulotnego systemu plików kontenera od trwałych magazynów danych. Konfiguracje stref DNS czy bazy dzierżaw DHCP muszą być mapowane do wolumenów trwałych (Docker Volumes lub Bind Mounts).

W obszarze bezpieczeństwa kluczową zasadą jest uruchamianie kontenerów z uprawnieniami zwykłego użytkownika (Non-Root User), ograniczenie uprawnień jądra za pomocą mechanizmu Linux Capabilities (np. --cap-drop=ALL) oraz stosowanie profili AppArmor i Seccomp chroniących przed ucieczką z kontenera (Container Breakout).

Ponieważ warstwa zapisu kontenera (Container Layer) jest z natury ulotna i ulega zniszczeniu po jego usunięciu, dane krytyczne (takie jak bazy danych, logi serwerowe i certyfikaty) muszą być montowane za pośrednictwem wolumenów zarządzanych (Docker Volumes) lub podpięć katalogów (Bind Mounts). W obszarze bezpieczeństwa nieodzowne jest stosowanie profili AppArmor/SELinux, filtrowanie wywołań systemowych przez seccomp oraz odbieranie zbędnych uprawnień linuksowych (ang. Linux Capabilities, np. opcja --cap-drop=ALL).

Skróty użyte w tym slajdzie:
Volume (Docker Storage Volume) - Zarządzany przez platformę katalog na dysku gospodarza służący do trwałego przechowywania danych kontenera.
CIS (Center for Internet Security) - Organizacja publikująca rygorystyczne wytyczne bezpieczeństwa (CIS Docker Benchmark) dla systemów IT.

52/54

Wdrożenie mikrousług sieciowych w kontenerach: przykład praktyczny

Architektura nowoczesnego węzła usługowego w kampusie.

Wykład 6: Wdrożenie mikrousług sieciowych w kontenerach: przykład praktyczny

  • Środowisko: pojedynczy serwer fizyczny z systemem Linux w serwerowni wydziałowej.
  • Uruchomione niezależne kontenery:
  • Kontener 1: serwer buforujący DNS (np. Pi-hole / BIND9 / Unbound) filtrujący reklamy i złośliwe oprogramowanie.
  • Kontener 2: serwer czasu NTP (Chrony) synchronizujący zegary wszystkich przełączników w budynku.
  • Kontener 3: serwer logów Syslog (Rsyslog) zbierający komunikaty o zdarzeniach.
  • Kontener 4: agent telemetryczny (Prometheus Node Exporter) monitorujący stan serwera.
  • Wszystkie usługi są odizolowane i można je aktualizować jednym poleceniem bez przestoju całego systemu.
Narzędzie Docker Compose umożliwia deklaratywne wdrażanie stosu mikrousług sieciowych w modelu Infrastructure as Code (IaC), zapewniając powtarzalność konfiguracji i szybkie odzyskiwanie po awarii.
Ilustracja techniczna do slajdu 52: Wdrożenie mikrousług sieciowych w kontenerach: przykład praktyczny

Praktyczne wdrożenie mikrousług sieciowych w kampusie realizuje się za pomocą narzędzia Docker Compose. W zwięzłym pliku deklaratywnym docker-compose.yml inżynier definiuje powiązane kontenery: serwer DNS BIND9, panel statystyk, eksporter metryk Prometheus oraz agenta logowania.

Podejście Infrastructure as Code (IaC) pozwala na natychmiastowe odtworzenie całego środowiska usługowego po awarii sprzętowej serwera na nowej maszynie w ciągu kilkunastu sekund, znacznie skracając wskaźnik MTTR (Mean Time To Repair).

Zastosowanie narzędzia Docker Compose lub manifestów Kubernetes pozwala na zdefiniowanie kompletnego stosu aplikacyjnego uczelni (np. serwer WWW Nginx, silnik aplikacji PHP-FPM, baza danych PostgreSQL oraz pamięć podręczna Redis) w postaci deklaratywnego pliku konfiguracyjnego YAML. Podejście to, zgodne z paradygmatem Infrastructure as Code (IaC), gwarantuje pełną powtarzalność środowisk od stacji deweloperskiej studenta aż po produkcyjne centrum danych kampusu i umożliwia błyskawiczne odtworzenie usług po awarii sprzętowej.

Skróty użyte w tym slajdzie:
Microservices (Microservices Architecture) - Wzorzec projektowy dzielący system informatyczny na zestaw małych, autonomicznych i niezależnie wdrażanych usług.
Traefik (Traefik Reverse Proxy) - Nowoczesny serwer proxy i kontroler wejścia (Ingress) integrujący się dynamicznie ze środowiskiem kontenerowym.

53/54

Podsumowanie najważniejszych zagadnień wykładu

Synteza wiedzy o adresacji IP i usługach sieciowych.

Wykład 6: Podsumowanie najważniejszych zagadnień wykładu

  • Strategia adresowania IPv4 wymaga hierarchicznego stosowania techniki VLSM i sumaryzacji CIDR na podstawie puli prywatnej RFC 1918.
  • Wdrożenie IPv6 opiera się na przydziale prefiksu /48 dla uczelni i standardowych podsieci /64 na VLAN z wykorzystaniem mechanizmów SLAAC oraz stanowego i bezstanowego DHCPv6.
  • Centralizację adresacji DHCP w rozległym kampusie umożliwia agent pośredniczący DHCP Relay (ip helper-address), a bezpieczeństwo warstwy 2 zapewnia mechanizm DHCP Snooping.
  • System DNS w kampusie wymaga wdrożenia modelu Split-DNS, serwerów buforujących, stref filtrowania zagrożeń DNS RPZ oraz nowoczesnego szyfrowania DoT/DoH.
  • Podstawowe usługi aplikacyjne (WWW, SMB, NFS, SFTP) wymagają ścisłej separacji w dedykowanych strefach sieciowych.
  • Konteneryzacja w platformie Docker (sterowniki bridge, macvlan, overlay) stanowi współczesny standard wdrażania lekkich, izolowanych mikrousług sieciowych.
Zintegrowana infrastruktura adresowa i usługowa kampusu łączy hierarchiczne planowanie IPv4/IPv6, bezpieczny przydział DHCP Snooping, architekturę Split-DNS oraz elastyczną konteneryzację mikrousług.
Ilustracja techniczna do slajdu 53: Podsumowanie najważniejszych zagadnień wykładu

Podsumowując zagadnienia wykładu, sprawne funkcjonowanie sieci kampusowej opiera się na połączeniu przemyślanego planu adresacji IPv4/IPv6 oraz niezawodnych usług podstawowych. Prawidłowy projekt VLSM, wdrożenie masek /31 na łączach P2P oraz hierarchia IPv6 /64 tworzą solidny fundament.

Z kolei automatyzacja przydziału konfiguracji z wykorzystaniem bezpiecznego DHCP Snooping z Opcją 82, architektura Split-DNS z ochroną DNS RPZ i DNSSEC oraz nowoczesna konteneryzacja mikrousług zapewniają wysoką dostępność, odporność na cyberzagrożenia i łatwość skalowania infrastruktury.

Projektowanie adresacji i usług sieciowych wymaga całościowego spojrzenia na infrastrukturę teleinformatyczną: od matematycznej precyzji podziału prefiksów IPv4/IPv6, przez automatyzację konfiguracji stacji za pomocą protokołów DHCP i SLAAC, aż po stabilność i bezpieczeństwo systemu DNS oraz nowoczesne wzorce wdrażania usług w środowiskach skonteneryzowanych. Synergia tych elementów decyduje o niezawodności i skalowalności całego kampusu akademickiego.

Skróty użyte w tym slajdzie:
Dual-Stack Summary (Dual-Stack Campus Architecture) - Model wdrażania sieci kampusowej integrujący bezpieczną adresację IPv4/IPv6 z redundancją usług krytycznych.

54/54

Zapowiedź kolejnego wykładu: podstawy routingu w sieci kampusowej

Przejście do kolejnego kluczowego zagadnienia inżynierii sieciowej.

Wykład 6: Zapowiedź kolejnego wykładu: podstawy routingu w sieci kampusowej

  • Temat kolejnego spotkania: podstawy routingu w sieci kampusowej, czyli routing statyczny i dynamiczny.
  • Kluczowe zagadnienia: anatomia tablicy routingu, reguła najdłuższego dopasowania prefiksu (Longest Prefix Match), dystans administracyjny AD, metryki.
  • Porównanie: determinizm tras statycznych a elastyczność i odporność na awarie protokołów dynamicznych (IGP i EGP, wektor odległości i stan łącza).
  • Zadanie do przemyślenia: co decyduje o tym, którą trasę wybierze router, gdy w tablicy znajdują się wpisy o różnej długości masek prowadzące do tego samego serwera.
Kolejny moduł dydaktyczny (Wykład 7) przedstawi architekturę i protokoły routingu w sieci kampusowej: tablice RIB i FIB, routing statyczny i dynamiczny oraz algorytmy wektora odległości i stanu łącza.
Ilustracja techniczna do slajdu 54: Zapowiedź kolejnego wykładu: podstawy routingu w sieci kampusowej

Wykład 6 zamyka blok tematyczny poświęcony adresacji i usługom sieciowym warstwy 3 i warstw wyższych. Kolejny moduł programowy przenosi punkt ciężkości na algorytmy i mechanizmy podejmowania decyzji o przekazywaniu pakietów w sieci rozległej.

Wykład 7 poświęcony będzie architekturze i protokołom routingu w sieci kampusowej: analizie działania tablicy routingu (RIB/FIB), routingowi statycznemu i dynamicznemu, porównaniu protokołów wektora odległości (Distance Vector) i stanu łącza (Link-State) oraz metrykom wyboru najkrótszej ścieżki.

Wykład 7 poświęcony będzie fundamentom routingu dynamicznego w wieloobiektowych sieciach kampusowych. Studenci poznają mechanizmy działania protokołów stanu łącza (ze szczególnym uwzględnieniem protokołu OSPFv2 dla IPv4 i OSPFv3 dla IPv6), podział na obszary hierarchiczne (Multi-Area OSPF), reguły wyznaczania najkrótszej ścieżki za pomocą algorytmu Dijkstry (SPF) oraz mechanizmy bezpiecznego redystrybuowania tras na stykach domen routingowych.

Skróty użyte w tym slajdzie:
Routing (Network Routing) - Proces wyznaczania optymalnych ścieżek i przekazywania pakietów warstwy 3 pomiędzy odrębnymi sieciami.
Next Hop (Next Hop Router) - Adres IP kolejnego routera tranzytowego na trasie prowadzącej do sieci docelowej.

Podgląd okładki książki