1/53
Projektowanie i wymiarowanie sieci klasy „campus”
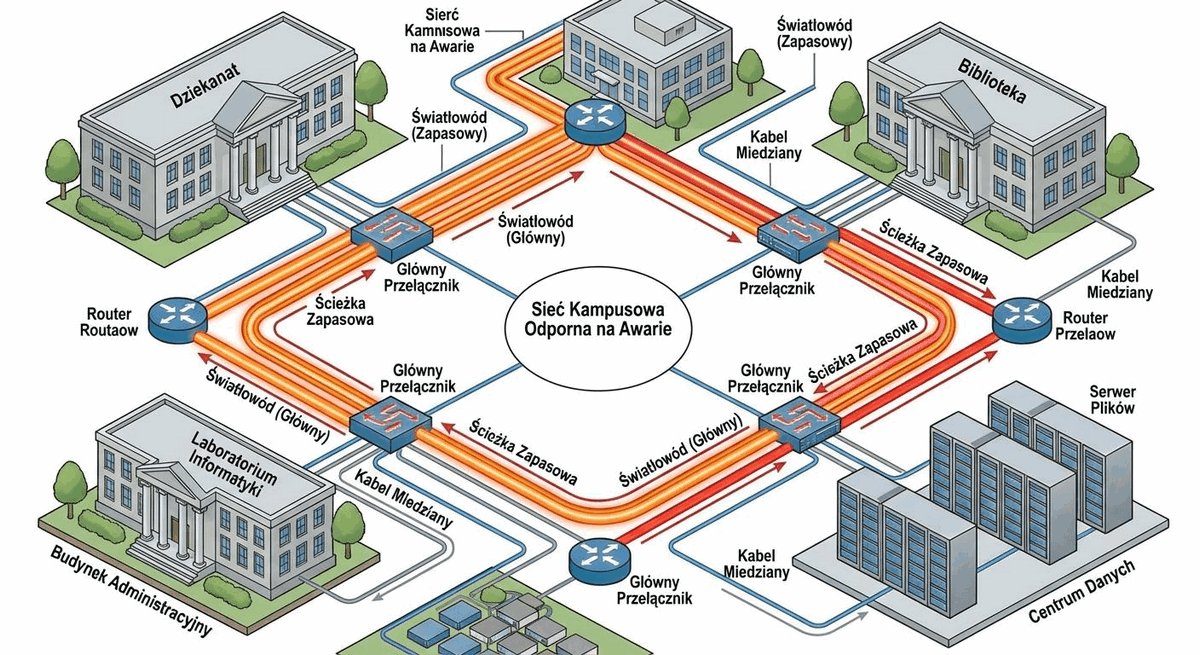
Cel slajdu: Wprowadzenie do inżynierii wysokiej dostępności (HA) w sieci kampusowej, uzasadnienie konieczności eliminacji pojedynczych punktów awarii (SPOF) oraz przedstawienie zakresu tematycznego Części 3.

Część 3: Wysoka dostępność i redundancja w kampusie

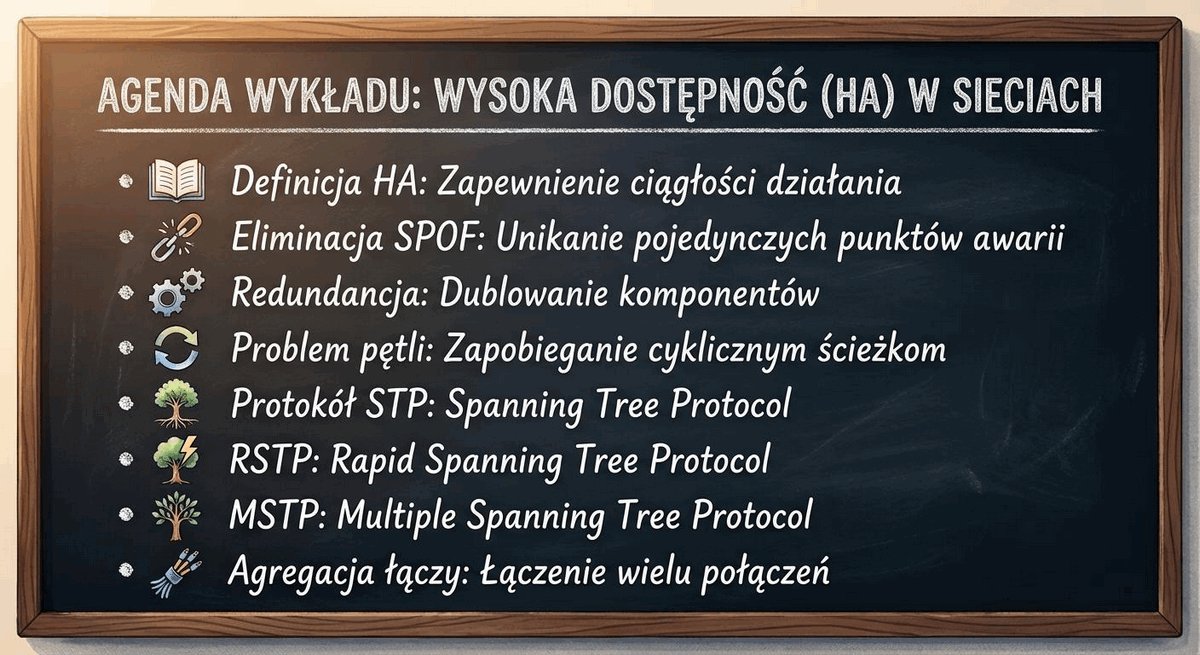
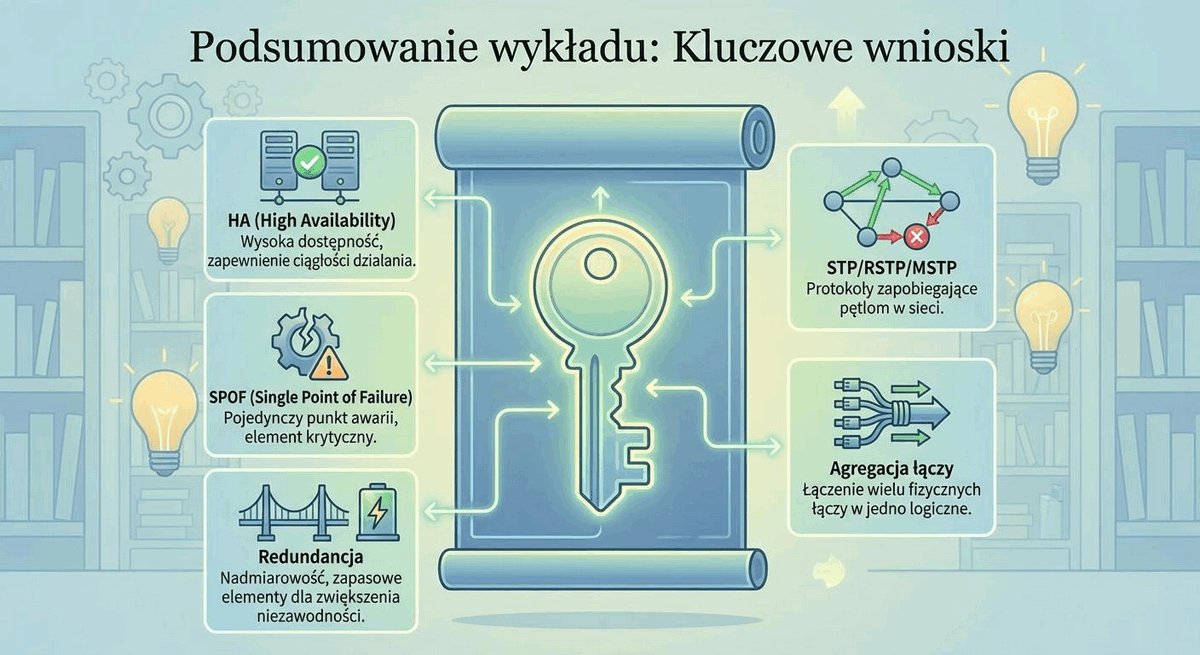
Trzecia część cyklu poświęcona jest projektowaniu sieci kampusowych o wysokiej dostępności (High Availability – HA):

  • Eliminacja pojedynczych punktów awarii (SPOF): inżynierskie metody dublowania krytycznych zasobów sieciowych.
  • Redundancja sprzętowa i zasilania: moduły hot-swap, podwójne zasilacze, technologie SSO i NSF w węzłach rdzeniowych.
  • Ochrona przed pętlami w warstwie 2: ewolucja protokołów drzewa rozpinającego (STP → RSTP → MSTP) oraz mechanizmy ochronne portów.
  • Agregacja łączy i wirtualizacja krosowa: protokoły LACP (IEEE 802.1AX) oraz techniki Multi-Chassis (M-LAG / vPC).
  • Redundancja pierwszej bramy w warstwie 3: protokoły FHRP (HSRP, VRRP wg RFC 5798) oraz koncepcja Routed Access.
Zasada inżynierska: Wysoka dostępność to kompleksowa architektura całego systemu, a nie pojedyncza funkcja w oprogramowaniu. Awaria pojedynczego kabla, portu, zasilacza czy przełącznika nie może przerwać działania usług użytkowników.
Architektura wysokiej dostępności (High Availability): Układ techniczny i logiczny systemu teleinformatycznego gwarantujący ciągłe i nieprzerwane świadczenie usług sieciowych na zdefiniowanym poziomie jakości (SLA) pomimo wystąpienia awarii pojedynczych komponentów sprzętowych lub programowych.
Projektowanie i wymiarowanie sieci klasy „campus”

Wysoka dostępność to kompleksowa filozofia projektowania infrastruktury. Każdy element sieci – od pojedynczego gniazda zasilającego, przez wentylatory, procesory routingu, aż po trasy światłowodowe – musi posiadać sprawny i w pełni automatyczny mechanizm przełączenia na element zapasowy.

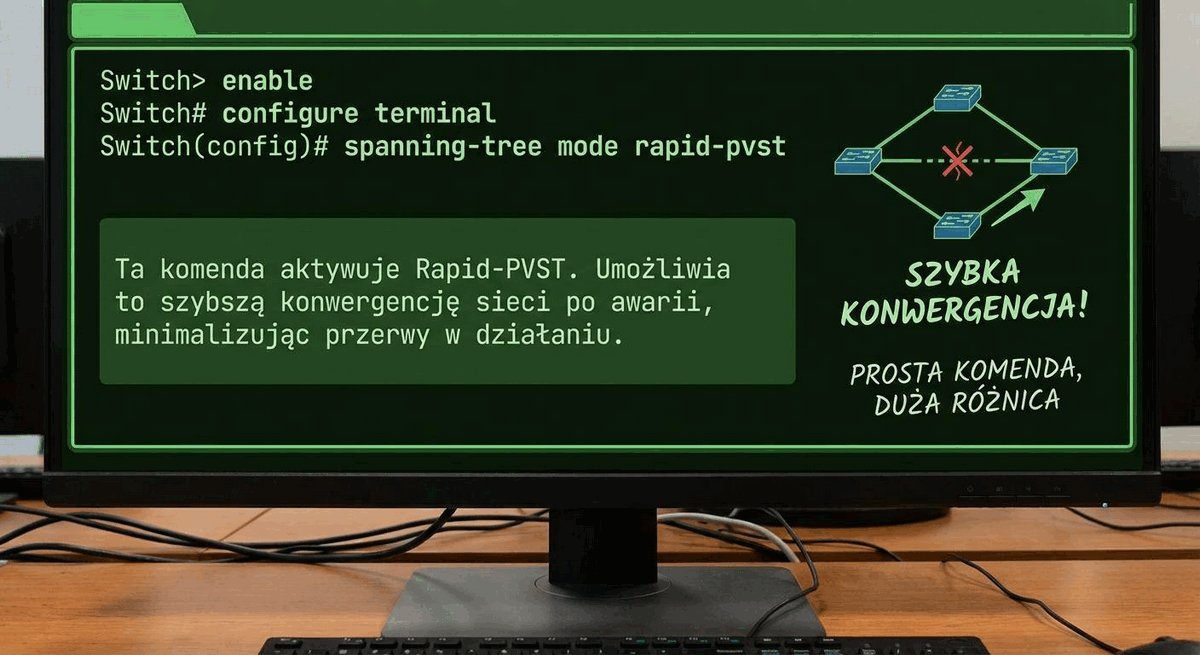
Kluczowym celem inżyniera projektanta jest skrócenie czasu konwergencji sieci po awarii (Failover Time) do wartości rzędu dziesiątek milisekund, co jest całkowicie niezauważalne dla użytkowników aplikacji głosowych VoIP, wideokonferencji i sesji bazodanowych.

Skróty użyte w tym slajdzie:
HA – High Availability – wysoka dostępność systemów teleinformatycznych.
SPOF – Single Point of Failure – pojedynczy punkt awarii w architekturze.
STP – Spanning Tree Protocol – protokół drzewa rozpinającego (IEEE 802.1D).
RSTP – Rapid Spanning Tree Protocol – protokół szybkiego drzewa rozpinającego (IEEE 802.1w/802.1Q).
LACP – Link Aggregation Control Protocol – protokół sterowania agregacją łączy (IEEE 802.1AX).
FHRP – First Hop Redundancy Protocol – rodzina protokołów redundancji bramy domyślnej.

2/53
Literatura i źródła normatywne
Cel slajdu: Przedstawienie kanonu norm międzynarodowych IEEE, RFC IETF oraz oficjalnych wytycznych inżynierskich regulujących mechanizmy redundancji i konwergencji.

Standardy branżowe i dokumenty IETF

Podstawę merytoryczną w zakresie wysokiej dostępności stanowią normy:

Standard IEEE 802.1Q: Fundamentalny standard sieci lokalnych Ethernet definiujący tagowanie ramek identyfikatorami VLAN, priorytetyzację QoS (802.1p) oraz zintegrowane mechanizmy kontroli topologii drzewa rozpinającego (RSTP i MSTP).

Standardy komitetu IEEE 802.1 definiują fundamentalne reguły rządzące mostkowaniem i przełączaniem ramek w sieciach lokalnych. Warto zauważyć, że pierwotne specyfikacje IEEE 802.1D (STP), IEEE 802.1w (RSTP) oraz IEEE 802.1s (MSTP) zostały włączone do jednolitej normy bazowej IEEE 802.1Q.

Z kolei standard IEEE 802.1AX zastąpił historyczny standard IEEE 802.3ad w zakresie agregacji łączy LACP, wyodrębniając tę funkcję jako niezależną od typu medium transmisyjnego.

Skróty użyte w tym slajdzie:
IEEE – Institute of Electrical and Electronics Engineers – instytut inżynierów elektryków i elektroników.
IETF – Internet Engineering Task Force – organizacja tworząca standardy internetowe RFC.
RFC – Request for Comments – oficjalny dokument techniczny publikowany przez IETF.
BFD – Bidirectional Forwarding Detection – protokół szybkiego wykrywania przerw w łączności.
VRRP – Virtual Router Redundancy Protocol – standardowy protokół redundancji routerów.

3/53
Agenda części 3
Cel slajdu: Przedstawienie struktury tematycznej wykładu obejmującej metryki niezawodności, ochronę przed pętlami L2, agregację łączy oraz redundancję bramy L3.

Szczegółowy plan zagadnień wysokiej dostępności

W trakcie tej części przeanalizujemy następujące zagadnienia inżynierskie:

  • Koncepcja High Availability (HA): metryki MTBF, MTTR oraz matematyczna skala „dziewiątek”.
  • Identyfikacja i eliminacja SPOF: redundancja sprzętowa, moduły hot-swap, architektura SSO/NSF.
  • Pętle w warstwie 2: mechanika burz rozgłoszeniowych i zjawisko MAC Table Thrashing.
  • Ewolucja drzewa rozpinającego: od klasycznego STP (802.1D), przez RSTP (802.1w), po MSTP (802.1s).
  • Mechanizmy ochronne STP: PortFast, BPDU Guard, Root Guard i Loop Guard.
  • Agregacja łączy i wirtualizacja krosowa: protokół LACP (IEEE 802.1AX) oraz techniki M-LAG/vPC.
  • Redundancja pierwszej bramy (FHRP): HSRP oraz otwarty standard VRRP wg RFC 5798.
Domena awaryjna (Failure Domain): Wydzielony obszar sieci teleinformatycznej, w którym wystąpienie awarii pojedynczego komponentu może negatywnie wpłynąć na dostępność usług, ograniczony celowo poprzez segmentację i redundancję.
Agenda części 3

Struktura tej części odzwierciedla drogę pakietu od stacji roboczej w głąb kampusu. Rozpoczynamy od analizy niezawodności urządzeń i łączy fizycznych, następnie rozwiązujemy problem pętli w warstwie drugiej, by wreszcie przejść do agregacji pasma i redundancji routingu na pierwszym przeskoku.

Pozwala to na zbudowanie spójnego modelu myślowego, w którym redundancja nie generuje chaosu, lecz zapewnia przewidywalne i bezpieczne ścieżki zapasowe.

Skróty użyte w tym slajdzie:
SPOF – Single Point of Failure – pojedynczy punkt awarii.
MTBF – Mean Time Between Failures – średni czas bezawaryjnej pracy.
MTTR – Mean Time to Repair – średni czas naprawy / przywrócenia sprawności.
M-LAG – Multi-Chassis Link Aggregation Group – agregacja łączy do dwóch odrębnych przełączników.
SSO – Stateful Switchover – stanowe przełączenie na zapasowy procesor sterujący.

4/53
Koncepcja wysokiej dostępności (High Availability – HA) w kampusie
Cel slajdu: Przedstawienie celów, filarów i założeń projektowych architektury High Availability w wielobudynkowej sieci kampusowej.

Cel: nieprzerwane świadczenie usług teleinformatycznych

Wysoka dostępność to zdolność infrastruktury do ciągłego realizowania zadań pomimo wystąpienia awarii pojedynczych komponentów:

  • Odporność na uszkodzenia (Fault Tolerance): automatyczne wykrycie usterki i przełączenie ruchu na tory rezerwowe bez konieczności ingerencji administratora.
  • Determinizm czasowy: minimalizacja czasu konwergencji sieci po awarii do ułamków sekund (sub-second failover).
  • Przezroczystość dla aplikacji: komputery użytkowników, telefony VoIP, transmisje wideokonferencyjne i sesje bazodanowe nie mogą zrywać połączeń podczas przełączenia.
  • Projektowanie całościowe: uwzględnienie redundancji zasilania, chłodzenia, traktów kablowych, przełączników oraz łączy do operatorów WAN/ISP.
Paradygmat inżynierski: W nowoczesnej sieci awarie traktuje się jako stan naturalny i nieunikniony: każdy sprzęt w końcu ulegnie uszkodzeniu, ale sieć jako całość musi działać w sposób nieprzerwany.
Odporność na uszkodzenia (Fault Tolerance): Właściwość systemu teleinformatycznego pozwalająca na kontynuowanie prawidłowego działania na założonym poziomie wydajności pomimo wystąpienia usterki jednego lub więcej jego elementów składowych.
Koncepcja wysokiej dostępności (High Availability – HA) w kampusie

W nowoczesnej organizacji przerwa w działaniu sieci generuje bezpośrednie straty finansowe i operacyjne. Zablokowanie rejestracji na zajęcia, paraliż laboratoriów badawczych czy brak dostępu do szpitalnego systemu HIS w kampusie medycznym stanowi zagrożenie krytyczne.

Dlatego inżynier projektant traktuje awarie jako stan normalny i nieunikniony: każde urządzenie w końcu ulegnie uszkodzeniu, ale sieć jako całość musi działać dalej.

Skróty użyte w tym slajdzie:
HA – High Availability – wysoka dostępność systemów.
SLA – Service Level Agreement – umowa o gwarantowanym poziomie świadczenia usług.
VoIP – Voice over IP – telefonia internetowa wrażliwa na utratę pakietów.
ISP – Internet Service Provider – dostawca usług internetowych.
WAN – Wide Area Network – rozległa sieć teleinformatyczna.

5/53
Metryki niezawodności systemów: MTBF, MTTR i dostępność
Cel slajdu: Przedstawienie inżynierskich wskaźników niezawodności urządzeń (MTBF, MTTR) oraz wyprowadzenie wzoru matematycznego na współczynnik dostępności.

Inżynierskie wskaźniki gotowości operacyjnej

Niezawodność i dyspozycyjność systemów teleinformatycznych opisują wskaźniki statystyczne:

  • MTBF (Mean Time Between Failures): średni czas bezawaryjnej pracy urządzenia pomiędzy kolejnymi usterkami, wyrażany w setkach tysięcy godzin (parametr podawany przez producenta sprzętu).
  • MTTR (Mean Time to Repair / Recover): średni czas potrzebny na zdiagnozowanie problemu, wymianę uszkodzonego podzespołu i przywrócenie pełnej funkcjonalności sieci.
  • Wzór matematyczny na dostępność (Availability - A):
    A = MTBF / (MTBF + MTTR) × 100%
Kluczowy wniosek: Aby podnieść dostępność systemu, inżynier może zwiększać MTBF (kupując droższy sprzęt klasy Enterprise) lub radykalnie skracać MTTR (wdrażając automatyczną redundancję i magazyn części zamiennych na miejscu). Skracanie MTTR jest wielokrotnie bardziej opłacalne!
Współczynnik dostępności (Availability - A): Stosunek czasu, w którym system teleinformatyczny jest w pełni zdatny do użytku i wykonuje swoje funkcje, do całkowitego czasu rozpatrywanego okresu eksploatacji, wyrażany w procentach.
Metryki niezawodności systemów: MTBF, MTTR i dostępność

Wpływ MTTR na dostępność jest fundamentalny. Jeżeli przełącznik ma MTBF na poziomie 500 000 godzin (ponad 50 lat pracy), ale w przypadku awarii zasilacza czas dostarczenia części zamiennej i jej montażu wynosi 24 godziny, dostępność węzła drastycznie spada.

Zastosowanie redundantnego zasilacza w architekturze 1+1 sprawia, że MTTR z punktu widzenia działania sieci skraca się do 0 sekund – zasilacz rezerwowy przejmuje obciążenie natychmiast bez restartu przełącznika.

Skróty użyte w tym slajdzie:
MTBF – Mean Time Between Failures – średni czas bezawaryjnej pracy urządzenia.
MTTR – Mean Time to Repair – średni czas naprawy i przywrócenia sprawności.
MTTF – Mean Time to Failure – średni czas do pierwszej awarii komponentu nienaprawialnego.
NMS – Network Management System – system monitorujący stany pracy węzłów.
SLA – Service Level Agreement – zdefiniowany w umowie próg dostępności.

6/53
Matematyczna miara dostępności: skala „dziewiątek” i koszty przestoju
Cel slajdu: Przedstawienie skali „dziewiątek” dostępności, kalkulacji dopuszczalnego czasu przestoju oraz ekonomicznych kosztów podnoszenia niezawodności.

Ile kosztuje minuta przestoju sieci w skali roku?

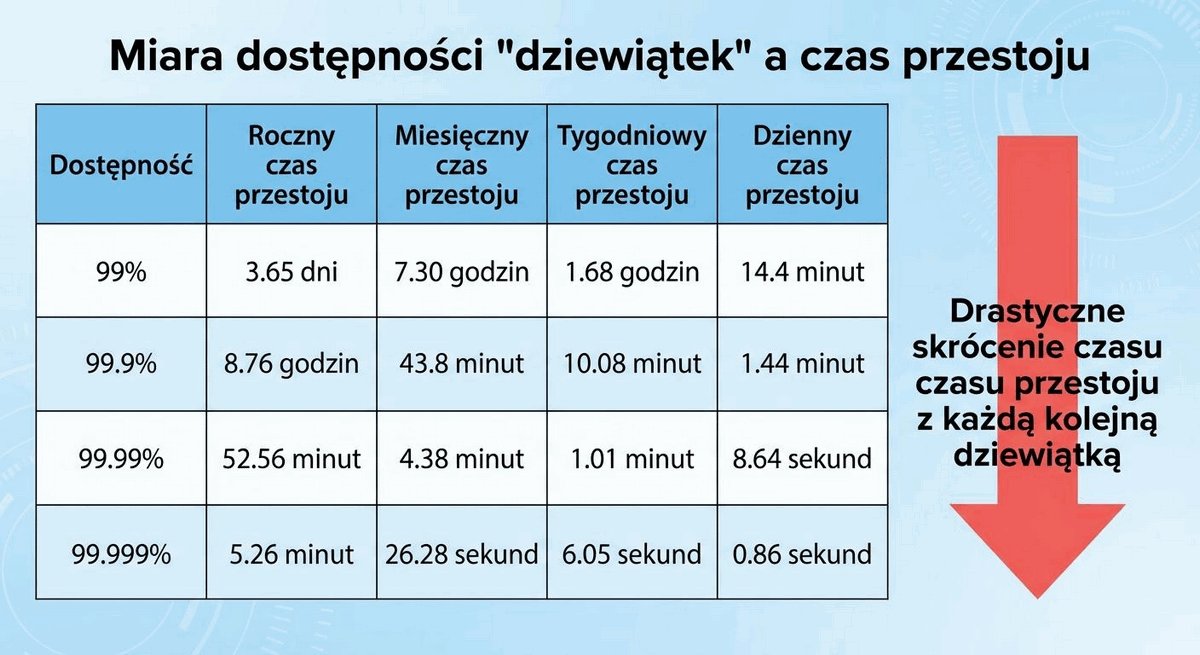
Poziomy dostępności w umowach SLA kategoryzuje się według liczby tzw. „dziewiątek”:

Wskaźnik dostępnościMaks. przestój / rokMaks. przestój / miesiącKlasa środowiska
99,0% (Dwie dziewiątki)87 godz. 36 min7 godz. 18 minSprzęt biurowy SOHO
99,9% (Trzy dziewiątki)8 godz. 45 min43 min 49 sStandardowy kampus LAN
99,99% (Cztery dziewiątki)52 min 35 s4 min 23 sŚrodowisko Enterprise
99,999% (Pięć dziewiątek)5 min 15 s26,3 sSystemy krytyczne i szpitale
Ekonomia redundancji: Uzyskanie każdej kolejnej „dziewiątki” wiąże się ze skokowym, geometrycznym wzrostem kosztów inwestycyjnych (CAPEX). Projektant musi zrównoważyć koszt budowy z realnym kosztem przestoju organizacji.
Reguła pięciu dziewiątek (Five Nines - 99,999%): Wzorzec najwyższej dostępności systemów klasy Mission-Critical, oznaczający, że łączny nieplanowany czas przestoju infrastruktury w ciągu całego roku nie może przekroczyć 5 minut i 15 sekund.
Matematyczna miara dostępności: skala „dziewiątek” i koszty przestoju

Uzyskanie każdego kolejnego poziomu „dziewiątek” wiąże się ze skokowym, geometrycznym wzrostem kosztów inwestycyjnych. Przejście z dostępności 99,9% (około 9 godzin przestoju rocznie) do 99,999% (zaledwie 5 minut przestoju) wymaga całkowitego zdublowania wszystkich torów transmisyjnych, zasilaczy UPS, agregatów prądotwórczych i urządzeń sieciowych.

Zadaniem inżyniera projektanta nie jest bezrefleksyjne dążenie do pięciu dziewiątek w każdym punkcie sieci, lecz precyzyjne dopasowanie poziomu redundancji do krytyczności poszczególnych stref kampusu.

Skróty użyte w tym slajdzie:
SLA – Service Level Agreement – formalna umowa gwarancji dostępności usług.
CAPEX – Capital Expenditures – nakłady inwestycyjne na zakup sprzętu.
OPEX – Operational Expenditures – bieżące koszty eksploatacji i serwisu.
SOHO – Small Office / Home Office – małe biuro / domowe środowisko IT.
ROI – Return on Investment – zwrot z nakładów inwestycyjnych.

7/53
Identyfikacja i eliminacja pojedynczych punktów awarii (SPOF)
Cel slajdu: Przedstawienie metodyki identyfikacji pojedynczych punktów awarii (SPOF) w strukturze sieciowej oraz stosowania analizy What-If.

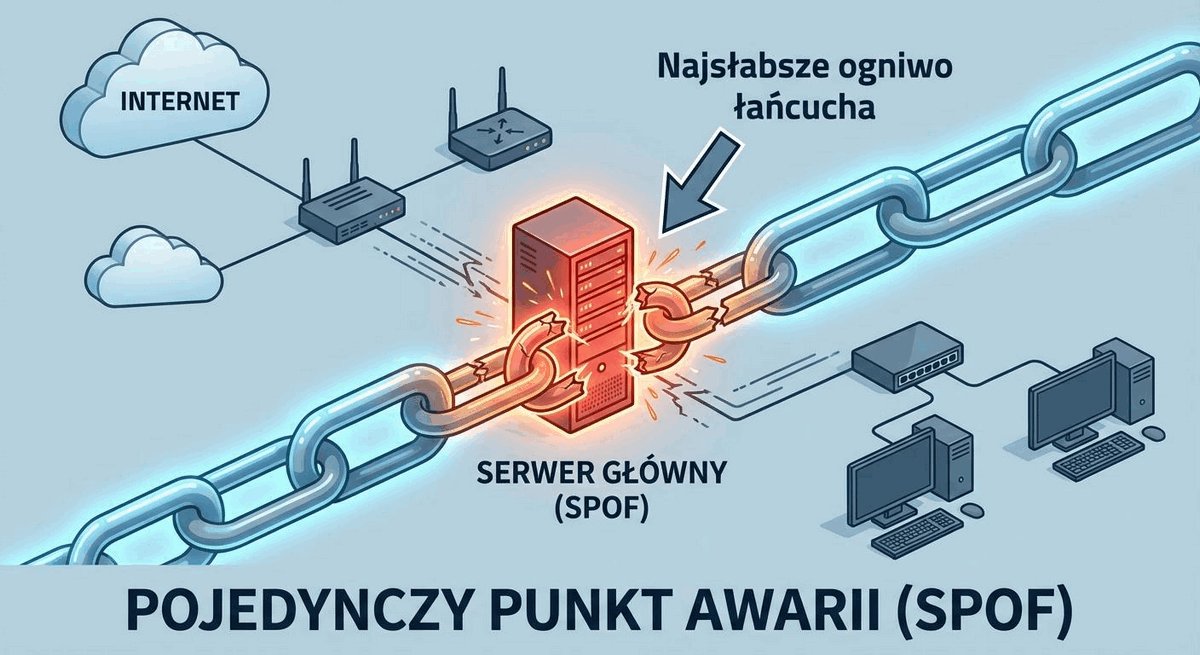
Najsłabsze ogniwo łańcucha teleinformatycznego

Pojedynczy punkt awarii (Single Point of Failure – SPOF) to dowolny komponent, którego uszkodzenie unieruchamia całą sieć lub jej znaczny segment:

  • Typowe punkty SPOF w infrastrukturze: pojedynczy przełącznik rdzeniowy, pojedyncze łącze światłowodowe w pionie, pojedynczy kabel zasilający, pojedynczy zasilacz w routerze brzegowym czy jedyny serwer DHCP/DNS.
  • Metodyka wykrywania SPOF: inżynierska analiza „co jeśli” (What-If Analysis) przeprowadzana dla każdego elementu topologii fizycznej i logicznej.
  • Zasada eliminacji SPOF: żaden pojedynczy defekt sprzętowy, błąd konfiguracyjny ani przerwanie kabla nie mogą odciąć użytkowników od zasobów krytycznych.
Zasada projektowa: Projektując sieć kampusową, inżynier zadaje pytanie: „Co stanie się z ruchem, jeśli w tym momencie to urządzenie lub to łącze ulegnie awarii?”. Jeśli odpowiedź brzmi: „użytkownicy stracą łączność”, zidentyfikowano SPOF, który należy wyeliminować.
Pojedynczy punkt awarii (SPOF - Single Point of Failure): Element składowy systemu teleinformatycznego, którego awaria lub wadliwe działanie bezpośrednio wywołuje zatrzymanie pracy całego systemu lub odcięcie dostępu do krytycznych usług.
Identyfikacja i eliminacja pojedynczych punktów awarii (SPOF)

W audycie sieci kampusowej inżynier stosuje technikę analizy „co jeśli” (What-If Analysis). Zadaje się pytanie: co stanie się z ruchem użytkowników, jeśli w tej chwili ulegnie awarii urządzenie X, port Y lub kabel Z? Jeśli odpowiedź wskazuje na całkowity brak łączności danej strefy kampusu, zidentyfikowano pojedynczy punkt awarii.

Eliminacja SPOF wymaga jednak ostrożności: dodanie zapasowego przełącznika lub łącza bez wdrożenia odpowiednich protokołów kontroli (np. STP lub LACP) może doprowadzić do katastrofalnych pętli transmisyjnych w warstwie 2.

Skróty użyte w tym slajdzie:
SPOF – Single Point of Failure – pojedynczy punkt awarii systemu.
FMEA – Failure Mode and Effects Analysis – analiza rodzajów i skutków zdatności/awarii.
DNS – Domain Name System – sieciowa usługa translacji nazw domenowych na adresy IP.
DHCP – Dynamic Host Configuration Protocol – protokół dynamicznego przydziału adresów IP.
LACP – Link Aggregation Control Protocol – protokół eliminacji SPOF na łączach.

8/53
Strategia wielopoziomowej redundancji w architekturze sieciowej
Cel slajdu: Przedstawienie czterech zintegrowanych płaszczyzn redundancji: zasilania, sprzętowej, łączy transmisyjnych oraz protokołów warstwy logicznej.

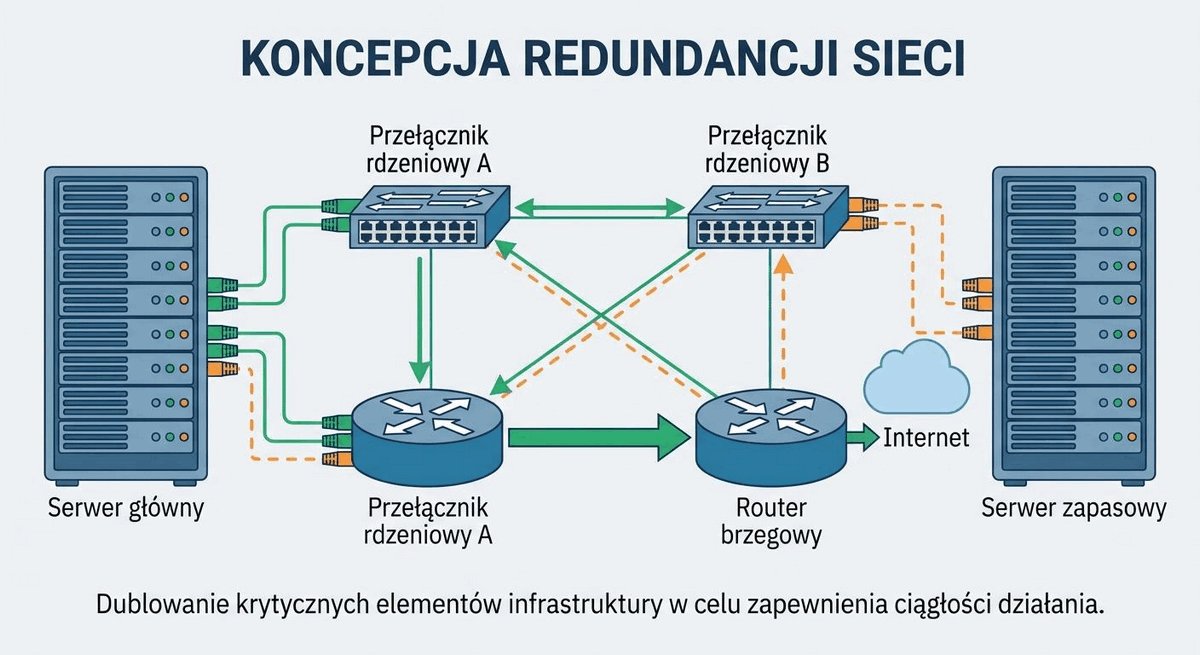
Dublowanie komponentów w celu zapewnienia ciągłości działania

Kompleksowe inżynierskie podejście do redundancji obejmuje cztery zintegrowane płaszczyzny:

  • Redundancja zasilania: dwa zasilacze w każdym przełączniku (PSU 1+1), zasilane z niezależnych torów PDU (Tor A i B) wspieranych przez odrębne UPS i agregat prądotwórczy.
  • Redundancja sprzętowa węzłów: dublowanie przełączników w warstwie dystrybucji i rdzenia oraz modułów kontrolnych (Supervisor) w obudowach kasetowych.
  • Redundancja tras kablowych: prowadzenie łączy zapasowych odrębnymi trasami budowlanymi i kanalizacyjnymi (separacja fizyczna traktów światłowodowych).
  • Redundancja logiczna i protokołowa: automatyczne protokoły konwergencji warstwy 2 (RSTP, MSTP, LACP) oraz warstwy 3 (OSPF, BFD, VRRP).
Uwaga na separację fizyczną: Samo ułożenie dwóch kabli światłowodowych w tej samej rurze kanalizacyjnej nie stanowi rzeczywistej redundancji – przypadkowe uderzenie łyżki koparki zniszczy oba kable jednocześnie!
Redundancja wielopoziomowa (Multi-Tier Redundancy): Strategia projektowa polegająca na równoległym zabezpieczeniu infrastruktury na poziomie zasilania elektrycznego, komponentów mechaniczno-elektronicznych, pasywnych traktów transmisyjnych oraz logicznych algorytmów routingu i przełączania.
Strategia wielopoziomowej redundancji w architekturze sieciowej

Niezwykle ważne jest skoordynowanie redundancji logicznej z redundancją fizyczną. Samo zdublowanie kabli światłowodowych w tym samym wykopie ziemnym daje złudne poczucie bezpieczeństwa – łyżka koparki podczas prac ziemnych przetnie oba kable w ułamku sekundy.

Dlatego standardy projektowe wymagają trasowania kabli zapasowych całkowicie odrębnymi traktami kanalizacji teletechnicznej (tzw. Diverse Routing), najlepiej wprowadzając je do budynków z przeciwnych stron świata.

Skróty użyte w tym slajdzie:
PSU – Power Supply Unit – wymienny moduł zasilacza przełącznika.
PDU – Power Distribution Unit – listwa dystrybucji zasilania w szafie RACK.
OSPF – Open Shortest Path First – protokół dynamicznego routingu stanu łącza.
VRRP – Virtual Router Redundancy Protocol – protokół redundancji bramy w warstwie 3.
UPS – Uninterruptible Power Supply – zasilacz bezprzerwowy.

9/53
Redundancja sprzętowa przełączników: podzespoły hot-swap i silniki sterujące
Cel slajdu: Omówienie mechanizmów redundancji wewnątrz przełączników modułowych: zasilaczy hot-swap, podwójnych kart procesorowych Supervisor oraz technologii SSO i NSF.

Ciągłość pracy na poziomie pojedynczego urządzenia modułowego

Węzły dystrybucyjne i rdzeniowe wyposaża się w podzespoły o wysokiej niezawodności:

  • Moduły Hot-Swap: możliwość bezpiecznej wymiany zasilaczy, kaset wentylatorów i kart liniowych podczas normalnej pracy urządzenia pod pełnym obciążeniem bez restartu systemu.
  • Podwójne silniki sterujące (Dual Supervisor Engines): dwie niezależne karty procesorowe w obudowie kasetowej pracujące w trybie Active/Standby.
  • Stanowe przełączenie procesorów (SSO - Stateful Switchover): zapasowa karta Supervisor utrzymuje w czasie rzeczywistym pełną synchronizację stanów protokołów i tablic przełączania; w razie awarii karty aktywnej przejmuje kontrolę w ułamku sekundy bez restartu interfejsów!
  • Bezprzerwowe przekazywanie ruchu (NSF - Non-Stop Forwarding): pakiety są bez zakłóceń przesyłane przez procesory ASIC w płaszczyźnie danych w trakcie restartu procesów routingu.
SSO + NSF: Połączenie technologii SSO i NSF sprawia, że fizyczne usunięcie głównej karty Supervisor z pracującego przełącznika rdzeniowego nie powoduje utraty ani jednego pakietu w transmisji użytkowników.
Stateful Switchover (SSO): Mechanizm wysokiej dostępności w przełącznikach modułowych, w którym zapasowa karta procesorowa (Supervisor) stale synchronizuje swój stan z kartą aktywną, umożliwiając natychmiastowe przejęcie kontroli nad urządzeniem po awarii bez restartu sesji sieciowych.
Redundancja sprzętowa przełączników: podzespoły hot-swap i silniki sterujące

Połączenie technologii SSO i NSF stanowi szczytowe osiągnięcie w dziedzinie wysokiej dostępności urządzeń modułowych. W przypadku fizycznego usunięcia głównej karty procesora z pracującego przełącznika modułowego, karta zapasowa przejmuje rolę główną w czasie poniżej 50 milisekund.

Dzięki technologii NSF sąsiednie routery OSPF/BGP nie zrywają relacji sąsiedztwa (Graceful Restart), a procesory sprzętowe ASIC na kartach liniowych kontynuują forwardowanie ramek na podstawie wcześniej załadowanych tablic FIB.

Skróty użyte w tym slajdzie:
SSO – Stateful Switchover – stanowe przełączenie na procesor zapasowy.
NSF – Non-Stop Forwarding – bezprzerwowe przekazywanie pakietów podczas przełączenia procesorów.
ASIC – Application-Specific Integrated Circuit – sprzętowe układy scalone przełączania pakietów.
FIB – Forwarding Information Base – tablica przekazywania pakietów w warstwie sprzętowej.
RIB – Routing Information Base – tablica routingu w pamięci procesora sterującego.

10/53
Technologie łączenia przełączników w jeden logiczny węzeł
Cel slajdu: Przedstawienie technologii wirtualizacji przełączników (StackWise, Virtual Chassis, VSS/StackWise Virtual) i ich roli w uproszczeniu topologii L2.

Wirtualizacja urządzeń w warstwie dostępu i dystrybucji

Wirtualizacja przełączników pozwala połączyć kilka fizycznych urządzeń w jeden logiczny węzeł sieciowy:

  • Stos przełączników dostępowych (Stacking – np. Cisco StackWise): połączenie do 8 przełączników dedykowaną magistralą kablową (przepustowość 480–960 Gb/s); jeden wspólny adres IP do zarządzania i jedna płaszczyzna sterowania.
  • Wirtualizacja w dystrybucji (np. Cisco StackWise Virtual / VSS): połączenie dwóch przełączników za pomocą standardowych łączy optycznych 10G/40G/100G (Virtual Switch Link – VSL); para przełączników widoczna jest w sieci jako jedno urządzenie L2/L3.
  • Zaleta architektoniczna: eliminacja zablokowanych portów STP pomiędzy warstwą dostępu a dystrybucji – możliwość zastosowania agregacji łączy LACP (Multi-Chassis EtherChannel).
Uproszczenie topologii: Zamiast złożonej topologii z blokującym protokołem STP, połączenie przełącznika dostępowego z parą przełączników wirtualnych tworzy prosty, w pełni wykorzystany kanał agregacyjny (Port-Channel) o podwojonej przepustowości.
Stos przełączników (Switch Stacking): Technologia łączenia grupy niezależnych fizycznych przełączników sieciowych za pomocą dedykowanych magistral sprzętowych w jeden logiczny węzeł o wspólnej tablicy przełączania, pojedynczym adresie IP do zarządzania i zunifikowanej konfiguracji.
Technologie łączenia przełączników w jeden logiczny węzeł

Konsolidacja urządzeń w jedną jednostkę logiczną diametralnie upraszcza topologię sieci. Z punktu widzenia przełączników dostępowych, para przełączników dystrybucyjnych spiętych w StackWise Virtual lub VSS stanowi dokładnie jeden przełącznik logiczny.

Dzięki temu połączenia z przełącznika dostępowego do obu urządzeń dystrybucyjnych można zgrupować w jeden logiczny kanał EtherChannel (LACP). W ten sposób oba łącza przesyłają ruch jednocześnie, a protokół STP widzi tylko jedno logiczne połączenie punkt-punkt, eliminując konieczność blokowania jakichkolwiek portów.

Skróty użyte w tym slajdzie:
VSS – Virtual Switching System – wirtualizacja przełączników kasetowych Cisco.
VSL – Virtual Switch Link – łącze międzysystemowe synchronizujące stan wirtualnego przełącznika.
LACP – Link Aggregation Control Protocol – dynamiczna agregacja łączy wg IEEE 802.1AX.
ToR – Top of Rack – architektura szafowa z przełącznikiem szczytowym.
MEC – Multi-Chassis EtherChannel – agregacja łączy dochodząca do różnych urządzeń fizycznych.

11/53
Redundancja łączy w warstwie dostępu: topologia Dual-Homing
Cel slajdu: Przedstawienie topologii Dual-Homing łączącej przełącznik dostępowy z dwoma węzłami dystrybucyjnymi oraz analiza jej zalet i wyzwań w warstwie 2.

Zapasowe ścieżki transmisyjne z przełącznika dostępowego

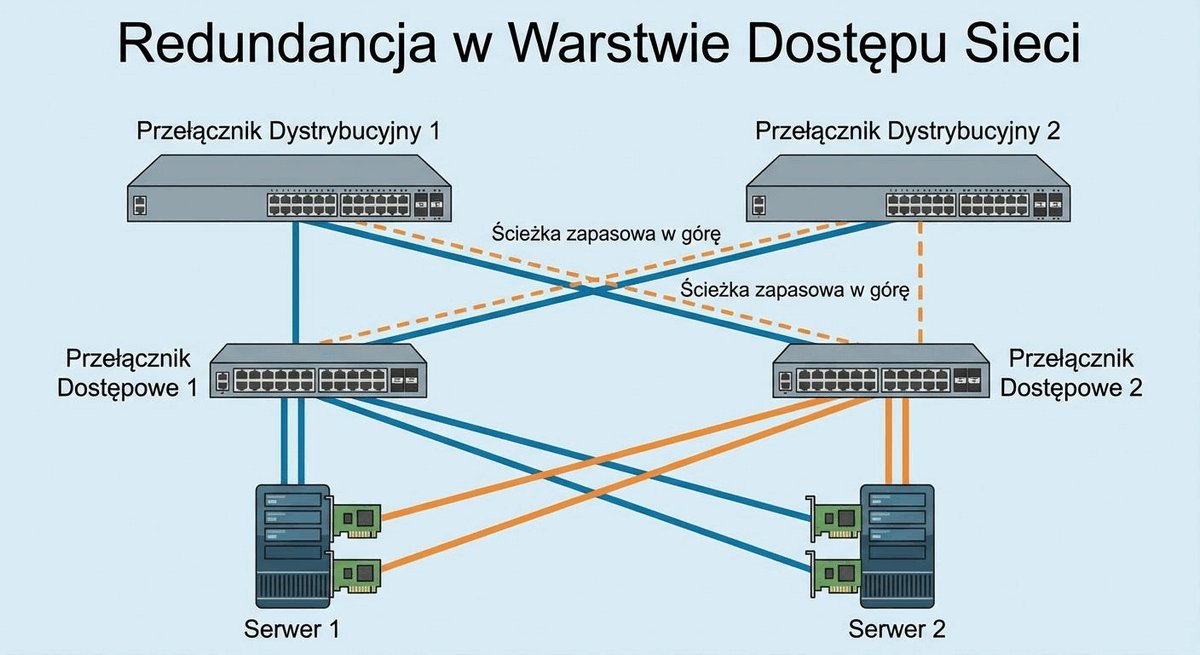
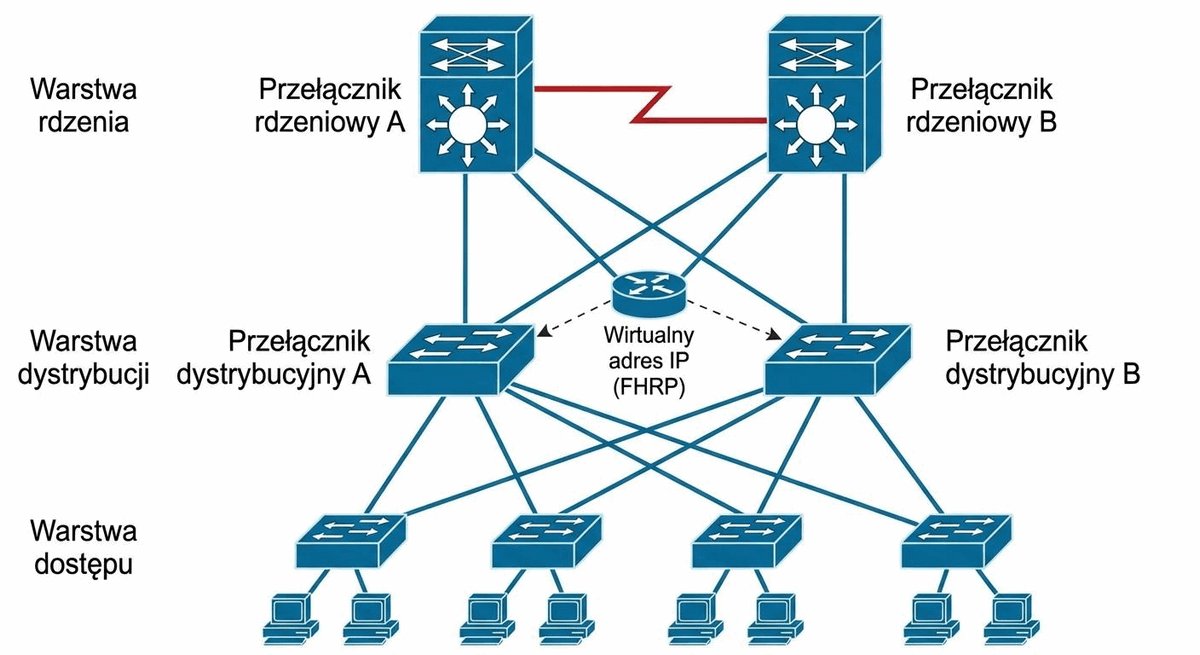
W strukturze kampusowej każdy przełącznik warstwy dostępu (Access) łączy się z dwoma odrębnymi przełącznikami warstwy dystrybucji (Distribution):

  • Topologia trójkąta (Triangle Topology): przełącznik Access posiada łącze główne do Dystrybucji 1 oraz łącze zapasowe do Dystrybucji 2. Przełączniki dystrybucyjne są połączone łączem międzysystemowym (Inter-Switch Link).
  • Zaleta niezawodnościowa: awaria jednego przełącznika dystrybucyjnego lub przerwanie jednego kabla pionowego nie odcina użytkowników podłączonych do przełącznika dostępowego.
  • Konsekwencja fizyczna: powstanie fizycznej pętli zamkniętej pomiędzy trzema przełącznikami w warstwie 2!
Kluczowy dylemat: Fizyczna redundancja połączeń jest konieczna dla niezawodności, ale w warstwie 2 Ethernet bezpośrednio wywołuje śmiertelne zagrożenie pętli przełączania. Wymaga to natychmiastowego wdrożenia mechanizmów logicznej kontroli topologii.
Topologia Dual-Homing: Architektura sieciowa, w której urządzenie podrzędne (przełącznik dostępowy lub serwer) jest podłączone co najmniej dwoma niezależnymi łączami transmisyjnymi do dwóch odrębnych urządzeń nadrzędnych w celu eliminacji SPOF.
Redundancja łączy w warstwie dostępu: topologia Dual-Homing

Podłączenie pojedynczym kablem (Single-Homing) jest dopuszczalne wyłącznie w budżetowych instalacjach o niskim priorytecie. W profesjonalnej sieci kampusowej standardem jest Dual-Homing: przełącznik dostępowy posiada dedykowane łącza optyczne do dwóch szaf dystrybucyjnych.

Jednak w środowisku Ethernet każde zamknięte koło transmisyjne stanowi potencjalną katastrofę. Ramki Ethernet nie posiadają mechanizmu samoczynnego wygasania, przez co fizyczna pętla bez odpowiedniego protokołu kontrolnego doprowadzi do natychmiastowego paraliżu sieci.

Skróty użyte w tym slajdzie:
SPOF – Single Point of Failure – pojedynczy punkt awarii.
ISL – Inter-Switch Link – łącze magistralne pomiędzy przełącznikami dystrybucyjnymi.
L2 – Layer 2 – warstwa łącza danych modelu OSI.
L3 – Layer 3 – warstwa sieciowa modelu OSI.
Uplink – łącze w górę łączące warstwę niższą z wyższą w hierarchii.

12/53
Problem redundancji w warstwie 2: pętle przełączania
Cel slajdu: Przedstawienie mechanizmu powstawania pętli przełączania w sieci Ethernet oraz wyjaśnienie, dlaczego nadmiar łączy bez kontroli logicznej paraliżuje sieć.

Kiedy nadmiar łączy transmisyjnych prowadzi do paraliżu sieci?

W warstwie 2 modelu OSI (Ethernet) obecność fizycznych ścieżek zapasowych rodzi zjawiska destrukcyjne:

  • Zasada działania przełącznika Ethernet: ramka o nieznanym adresie docelowym (Unknown Unicast) lub ramka rozgłoszeniowa (Broadcast) jest powielana i rozsyłana na wszystkie porty należące do danego VLAN-u (mechanizm Flooding).
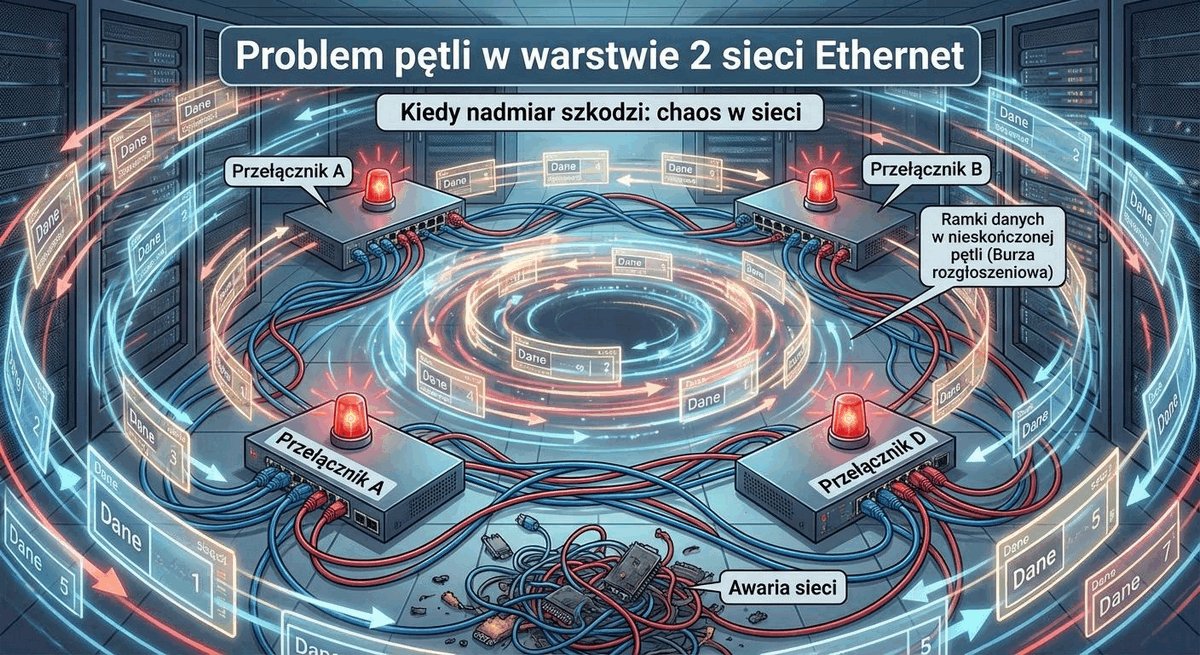
  • Mechanizm zapętlenia: jeśli w topologii istnieje zamknięta pętla, powielona ramka trafia na sąsiedni przełącznik, który ponownie rozsyła ją na wszystkie porty, w tym z powrotem do przełącznika źródłowego.
  • Eskalacja lawinowa: w każdej milisekundzie liczba krążących kopii rośnie w postępie wykładniczym, konsumując 100% pasma łączy i 100% mocy procesorów przełączników.
Fizyka pętli Ethernet: W warstwie 3 pakiet IP posiada pole TTL, które po pewnym czasie niszczy pakiet. W warstwie 2 ramka Ethernet nie posiada żadnego licznika życia – raz zapętlona ramka krąży w nieskończoność, aż do wyłączenia zasilania!
Pętla przełączania (L2 Switching Loop): Stan w sieci lokalnej Ethernet, w którym pomiędzy dwoma urządzeniami istnieją co najmniej dwie aktywne ścieżki w warstwie 2, powodujący niekontrolowane i nieskończone powielanie ramek rozgłoszeniowych i grupowych (multicast).
Problem redundancji w warstwie 2: pętle przełączania

Przełączniki sieciowe podejmują decyzje o przekazywaniu ramek na podstawie tablicy adresów MAC. Kiedy przełącznik otrzymuje ramkę o nieznanym adresie docelowym, nie ma innego wyjścia, jak tylko przesłać jej kopię na wszystkie pozostałe porty (mechanizm Flooding).

W topologii bez pętli każda kopia trafia do odbiorcy i proces się kończy. W topologii z pętlą ramka zaczyna krążyć po okręgu. Co gorsza, każdy przełącznik w pętli generuje kolejne kopie przy każdym okrążeniu, co prowadzi do zjawiska burzy rozgłoszeniowej w czasie poniżej kilkuset milisekund.

Skróty użyte w tym slajdzie:
OSI – Open Systems Interconnection – 7-warstwowy model odniesienia systemów otwartych.
MAC – Media Access Control – unikalny sprzętowy adres karty sieciowej w warstwie 2.
Flooding – rozsyłanie ramki na wszystkie porty w danej domenie rozgłoszeniowej.
TTL – Time to Live – czas życia pakietu w nagłówku IP.
VLAN – Virtual Local Area Network – wirtualna sieć lokalna.

13/53
Konsekwencje pętli w warstwie 2: burza rozgłoszeniowa
Cel slajdu: Przedstawienie zjawiska burzy rozgłoszeniowej (Broadcast Storm), jej przebiegu czasowego i niszczącego wpływu na ruch sieciowy.

Zniszczenie wydajności sieci w ułamku sekundy

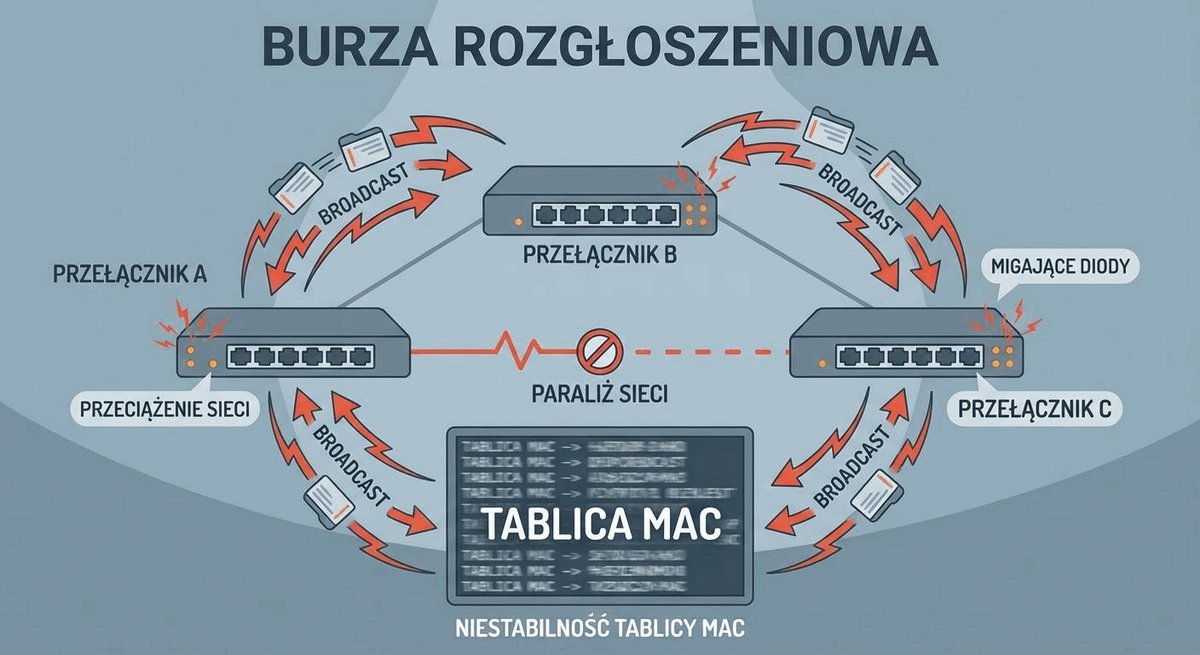
Burza rozgłoszeniowa (Broadcast Storm) to najgroźniejszy bezpośredni skutek powstania pętli w warstwie 2:

  • Geneza zjawiska: stacja robocza wysyła pojedynczą ramkę rozgłoszeniową (np. zapytanie ARP „Kto ma adres IP 192.168.1.1?” lub prośbę DHCP Discover).
  • Powielanie wykładnicze: przełączniki w pętli wielokrotnie kopiują tę samą ramkę; po kilkunastu milisekundach w łączach krążą miliony zduplikowanych pakietów na sekundę.
  • Objawy w sieci: natychmiastowe wysycenie łączy do 100% (diody portów świecą ciągłym światłem), obciążenie procesorów przełączników na poziomie 100%, całkowity brak możliwości nawiązania nowych sesji i paraliż pracy użytkowników.
Konieczność ochrony: Pojedyncza przypadkowa pętla wywołana np. przez wpięcie kabla patchcordowego oboma końcami do gniazdek na biurku potrafi sparaliżować sieć całego budynku w ciągu 2 sekund, jeśli sieć nie posiada aktywnych zabezpieczeń STP/BPDU Guard!
Burza rozgłoszeniowa (Broadcast Storm): Zjawisko lawinowego narastania liczby krążących w sieci lokalnej zduplikowanych ramek rozgłoszeniowych i wieloadresowych, prowadzące do pełnego wysycenia pasma łączy i zablokowania procesorów urządzeń sieciowych.
Konsekwencje pętli w warstwie 2: burza rozgłoszeniowa

W warunkach burzy rozgłoszeniowej natężenie ruchu transmisyjnego rośnie skokowo do wartości setek tysięcy ramek na sekundę (pps). Nawet potężne przełączniki rdzeniowe z procesorami sprzętowymi ulegają paraliżowi, ponieważ ramki rozgłoszeniowe muszą zostać przekazane do procesora sterującego (Control Plane) w celu analizy.

Administrator traci wówczas dostęp do zarządzania przełącznikami przez SSH czy konsolę Telnet, co uniemożliwia zdalną interwencję. Jedynym ratunkiem w niechronionej sieci jest fizyczne odłączanie kabli na ślepo w szafie teletechnicznej.

Skróty użyte w tym slajdzie:
ARP – Address Resolution Protocol – protokół mapowania adresów IP na adresy fizyczne MAC.
DHCP – Dynamic Host Configuration Protocol – protokół automatycznej konfiguracji sieciowej.
PPS – Packets Per Second – liczba pakietów / ramek przesyłanych w ciągu sekundy.
SSH – Secure Shell – bezpieczny szyfrowany protokół zdalnego zarządzania urządzeniami.
Control Plane – płaszczyzna sterowania odpowiedzialna za logikę i protokoły sieciowe.

14/53
Mechanizmy niszczące pętli L2: niestabilność tablicy MAC
Cel slajdu: Przedstawienie zjawiska MAC Table Thrashing, analizy ciągłego nadpisywania portów skojarzonych z adresem MAC oraz utraty możliwości poprawnego routingu i przełączania.

Zjawisko MAC Table Thrashing i duplikacja ramek

Oprócz burzy rozgłoszeniowej, pętla przełączania wywołuje zjawisko oscylacji tablicy adresów MAC (MAC Thrashing / Flapping):

  • Mechanizm uczenia się przełącznika: przełącznik kojarzy źródłowy adres MAC ramki z numerem portu fizycznego, na który ramka wpłynęła.
  • Ciągłe nadpisywanie wpisów: w obecności pętli ta sama ramka od użytkownika dociera do przełącznika co ułamek milisekundy raz z portu 1, a raz z portu 2.
  • Skutek funkcjonalny: procesor ASIC przełącznika nieustannie aktualizuje wpis w pamięci CAM setki razy na sekundę; przełącznik gubi pakiety unicastowe, ponieważ wysyła je w złym kierunku, po czym samoczynnie zalewa nimi całą sieć (Unicast Flooding).
Komunikat systemowy: Pojawienie się w logach systemowych Syslog komunikatu %SW_MATM-4-MACFLAP_NOTIF: Host xxxx.xxxx.xxxx in vlan 10 is flapping between port Gi1/0/1 and port Gi1/0/2 jest jednoznacznym dowodem na istnienie pętli w warstwie 2!
Oscylacja tablicy MAC (MAC Table Thrashing / Flapping): Zjawisko gwałtownego i naprzemiennego nadpisywania skojarzenia pojedynczego adresu MAC klienta z różnymi portami przełącznika, wywołane krążeniem zduplikowanych ramek w pętli warstwy 2.
Mechanizmy niszczące pętli L2: niestabilność tablicy MAC

Zjawisko MAC Flapping prowadzi do całkowitej dezorganizacji procesu przełączania ramek unicastowych. Kiedy stacja docelowa próbuje odpowiedzieć na zapytanie, przełącznik nie wie, na którym porcie rzeczywiście znajduje się odbiorca, ponieważ wpis w pamięci CAM zmienia się tysiące razy na sekundę.

W rezultacie przełącznik zaczyna traktować ruch typu Unicast jako Unknown Unicast i rozsyłać go na wszystkie porty, co dodatkowo potęguje burzę i przyspiesza wyczerpanie buforów pakietowych w układach scalonych.

Skróty użyte w tym slajdzie:
CAM – Content-Addressable Memory – pamięć asocjacyjna przechowująca tablicę MAC w przełączniku.
ASIC – Application-Specific Integrated Circuit – wyspecjalizowany układ scalony do przełączania ramek.
Syslog – standardowy protokół rejestracji zdarzeń systemowych urządzeń sieciowych.
Unicast – transmisja pakietów skierowana do dokładnie jednego odbiorcy.
Unknown Unicast – ramka jednostkowa, której adresu docelowego nie ma jeszcze w tablicy MAC.

15/53
Dlaczego warstwa 2 nie posiada mechanizmu TTL?
Cel slajdu: Wyjaśnienie przyczyn braku pola Time-to-Live w ramce Ethernet IEEE 802.3 i porównanie z mechanizmami bezpieczeństwa warstwy 3 (IPv4/IPv6).

Konstrukcja nagłówka ramki Ethernet wg IEEE 802.3

Fundamentalna różnica pomiędzy warstwą 2 a warstwą 3 modelu OSI dotyczy mechanizmu kontroli żywotności pakietu:

  • Warstwa 3 (IP): nagłówek pakietu IPv4 zawiera pole TTL (Time-to-Live), a nagłówek IPv6 pole Hop Limit (wartość początkowa np. 64 lub 128). Każdy kolejny router zmniejsza wartość o 1; gdy osiągnie 0, pakiet jest bezpowrotnie niszczony, a nadawca otrzymuje komunikat ICMP Time Exceeded. Pętla w warstwie 3 nie paraliżuje sieci!
  • Warstwa 2 (Ethernet): ramka zdefiniowana w normie IEEE 802.3 posiada prosty nagłówek (MAC docelowy, MAC źródłowy, EtherType) i nie posiada żadnego pola TTL!
  • Uzasadnienie historyczne: sieć Ethernet projektowano pierwotnie dla współdzielonego kabla koncentrycznego (topologia magistrali), gdzie pętle fizyczne z definicji nie mogły powstać.
Kluczowy wniosek: Skoro sam nagłówek Ethernet nie chroni przed zapętleniem, ochrona musi zostać zrealizowana na poziomie logiki portów przełączników – temu właśnie służy rodzina protokołów Spanning Tree (STP).
Czas życia pakietu (Time to Live - TTL): Pole w nagłówku pakietu warstwy sieciowej (IP) określające maksymalną dopuszczalną liczbę przeskoków przez routery, po przekroczeniu której pakiet jest odrzucany w celu zapobieżenia niekończącemu się krążeniu w pętli.
Dlaczego warstwa 2 nie posiada mechanizmu TTL?

Wprowadzenie pola TTL do nagłówka ramki Ethernet wymagałoby modyfikacji formatu ramki na poziomie całego świata i wymusiłoby przeliczanie sumy kontrolnej FCS (Frame Check Sequence) w locie przez każdy przełącznik przy każdym przeskoku. Zniweczyłoby to prostotę i ogromną wydajność sprzętową przełączania warstwy 2.

Z tego względu inżynierowie sieciowi muszą polegać na zewnętrznych algorytmach kontroli topologii, takich jak protokoły drzewa rozpinającego STP/RSTP lub protokoły routingu warstwy 3 (Routed Access).

Skróty użyte w tym slajdzie:
TTL – Time to Live – pole czasu życia pakietu w nagłówku IPv4.
Hop Limit – odpowiednik pola TTL w nagłówku protokołu IPv6.
FCS – Frame Check Sequence – 32-bitowa suma kontrolna CRC sprawdzająca integralność ramki.
ICMP – Internet Control Message Protocol – protokół komunikatów kontrolnych i diagnostycznych IP.
EtherType – dwubajtowe pole w ramce Ethernet określające protokół wyższej warstwy.

16/53
Protokół drzewa rozpinającego (STP, IEEE 802.1D): rola i idea
Cel slajdu: Przedstawienie matematycznej idei grafowego drzewa rozpinającego Radia Perlman, blokowania nadmiarowych portów i zachowania gotowych ścieżek zapasowych.

Logiczna topologia bez pętli na fizycznej siatce połączeń

Protokół drzewa rozpinającego (Spanning Tree Protocol – STP, standard IEEE 802.1D zintegrowany w Standard IEEE 802.1Q-2022 (Bridges and Bridged Networks) opracowany przez dr Radia Perlman) rozwiązuje konflikt pomiędzy redundancją a pętlami:

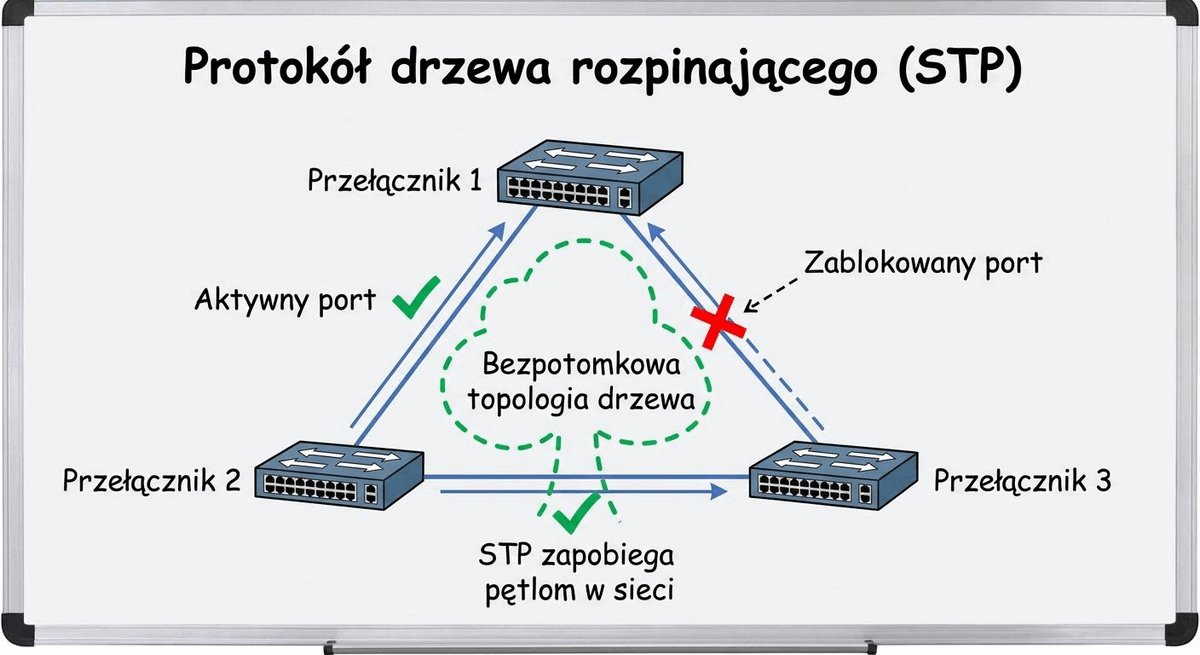
  • Zasada działania: przełączniki komunikują się między sobą specjalnymi ramkami BPDU, analizują wzajemne połączenia i matematycznie przekształcają fizyczny graf z pętlami w logiczne drzewo (drzewo rozpinające – Spanning Tree).
  • Blokowanie portów (Blocking): wybrane porty przełączników, które zamykałyby pętlę transmisyjną, zostają wprowadzone w stan logicznej blokady – nie przesyłają ramek użytkowników ani nie uczą się adresów MAC.
  • Automatyczny Failover: w przypadku awarii aktywnego łącza lub przełącznika protokół błyskawicznie odblokowuje wcześniej zablokowany port rezerwowy, przywracając łączność.
Istota STP: Zachowujemy pełną fizyczną redundancję okablowania (bezpieczeństwo sprzętowe), ale ruch w warstwie logicznej płynie wyłącznie po ścieżkach bezpętlowych (bezpieczeństwo transmisji).
Protokół drzewa rozpinającego (STP - Spanning Tree Protocol): Protokół warstwy łącza danych (warstwa 2) działający na przełącznikach sieciowych, zapobiegający powstawaniu pętli transmisyjnych w sieciach Ethernet poprzez dynamiczne blokowanie nadmiarowych ścieżek i odblokowywanie ich w razie awarii.
Protokół drzewa rozpinającego (STP, IEEE 802.1D): rola i idea

Matematyczną podstawą algorytmu STP (Spanning Tree Algorithm – STA) jest teoria grafów. Graf reprezentujący sieć przełączników musi zostać zredukowany do drzewa rozpinającego, czyli podgrafu, który łączy wszystkie wierzchołki (przełączniki), ale nie zawiera żadnego cyklu zamkniętego (pętli).

Klasyczny protokół IEEE 802.1D gwarantował pełne bezpieczeństwo sieci, jednak jego główną wadą był powolny czas konwergencji – odblokowanie ścieżki zapasowej trwało od 30 do 50 sekund, co we współczesnych kampusach jest czasem niedopuszczalnie długim.

Skróty użyte w tym slajdzie:
STP – Spanning Tree Protocol – protokół drzewa rozpinającego wg IEEE 802.1D.
BPDU – Bridge Protocol Data Unit – ramka konfiguracyjna protokołu STP.
STA – Spanning Tree Algorithm – matematyczny algorytm wyznaczania drzewa rozpinającego.
Failover – automatyczne przełączenie ruchu na komponent zapasowy po awarii.
Blocking – stan logicznego zablokowania portu przełącznika dla ruchu użytkownika.

17/53
Jednostki danych BPDU i identyfikator mostu (Bridge ID)
Cel slajdu: Przedstawienie struktury ramek kontrolnych BPDU oraz składowych unikalnego identyfikatora mostu Bridge ID (Priorytet, System ID Extension, Adres MAC).

Mechanizm komunikacji między przełącznikami w procesie elekcji

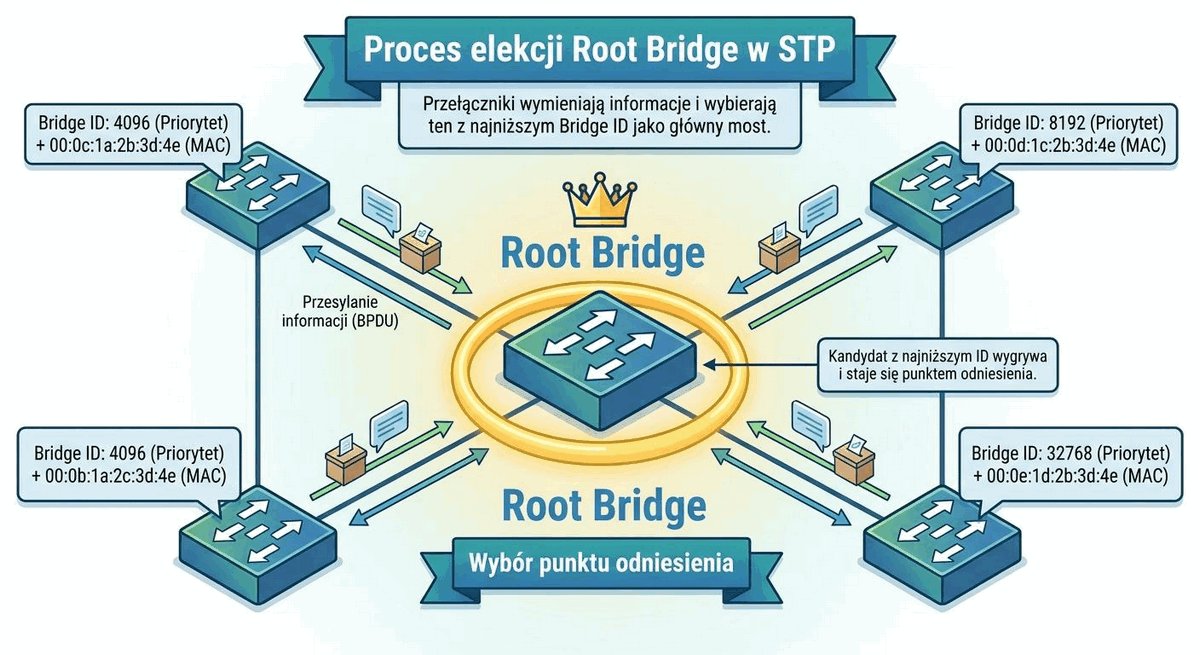
Przełączniki wymieniają informacje o topologii za pomocą specjalnych ramek kontrolnych nazywanych BPDU (Bridge Protocol Data Unit):

  • Format i transmisja: ramki BPDU nadawane są cyklicznie (domyślnie co 2 sekundy – parametr Hello Time) na zastrzeżony adres MAC multiemisji 01:80:C2:00:00:00.
  • Współczesny Bridge ID (zgodnie z rozszerzeniem IEEE 802.1t stosowanym w PVST+ i MSTP) składa się z 8 bajtów podzielonych na trzy pola:
    • Priorytet mostu (Bridge Priority): 4 bity najbardziej znaczące (wartości od 0 do 61440 konfigurowane wyłącznie z krokiem 4096, domyślnie 32768).
    • Rozszerzenie identyfikatora systemu (Extended System ID): 12 bitów przechowujących numer VLAN (od 1 do 4094).
    • Adres fizyczny MAC: 6 bajtów unikalnego adresu sprzętowego przełącznika (rozstrzyga elekcję przy identycznym priorytecie).
Kryterium wyboru: W protokole STP we wszystkich porównaniach obowiązuje zasada: im niższa wartość liczbowa, tym lepsza ścieżka / wyższy priorytet! Najniższy Bridge ID wygrywa wybory.
Identyfikator mostu (Bridge ID - BID): Ośmiobajtowa unikalna wartość składająca się z priorytetu mostu, identyfikatora VLAN (Extended System ID) oraz sprzętowego adresu MAC przełącznika, służąca do jednoznacznej identyfikacji urządzenia w procesie elekcji drzewa rozpinającego.
Jednostki danych BPDU i identyfikator mostu (Bridge ID)

Pola ramki BPDU zawierają pełny zestaw informacji niezbędnych do wyliczenia drzewa: identyfikator mostu głównego (Root BID), koszt ścieżki do korzenia (Root Path Cost), identyfikator przełącznika wysyłającego (Sender BID) oraz identyfikator portu nadawczego (Port ID).

Zastosowanie pola Extended System ID (zdefiniowanego w IEEE 802.1t) pozwoliło zredukować liczbę unikalnych adresów MAC wymaganych przez przełącznik obsługujący setki wirtualnych sieci VLAN – zamiast odrębnego MAC dla każdego VLAN-u stosuje się jeden adres bazowy, wstawiając numer VLAN bezpośrednio do pola priorytetu.

Skróty użyte w tym slajdzie:
BPDU – Bridge Protocol Data Unit – ramka danych protokołu drzewa rozpinającego.
BID – Bridge Identifier – unikalny identyfikator przełącznika w topologii STP.
MAC – Media Access Control – unikalny adres fizyczny interfejsu sieciowego.
Hello Time – domyślny interwał wysyłania ramek BPDU (2 sekundy).
PVST+ – Per-VLAN Spanning Tree Plus – implementacja STP uruchamiająca niezależne drzewo dla każdego VLAN-u.

18/53
Proces elekcji w STP: Root Bridge, Root Port i Designated Port
Cel slajdu: Przedstawienie trójetapowego algorytmu wyznaczania topologii drzewa rozpinającego: wyboru Root Bridge, wyznaczania Root Portów oraz Designated Portów.

Trzy etapy budowy logicznego drzewa rozpinającego

Budowa topologii STP przebiega w trzech ściśle zdefiniowanych etapach:

  • Etap 1: Wybór korzenia drzewa (Root Bridge): zostaje nim przełącznik posiadający najniższy Bridge ID w całej sieci. Wszystkie porty na Root Bridge stają się portami wyznaczonymi (Designated) i przesyłają ruch!
  • Etap 2: Wybór portu głównego (Root Port – RP): każdy przełącznik niebędący korzeniem wybiera dokładnie jeden swój port fizyczny o najniższym sumarycznym koszcie dotarcia do Root Bridge (Root Path Cost).
  • Etap 3: Wybór portów wyznaczonych (Designated Port – DP) i blokowanych (Alternate/Blocking): na każdym segmencie sieci (łączu) przełącznik o niższym koszcie do korzenia otwiera swój port DP; port na drugim końcu staje się portem blokowanym.
Kluczowa zasada inżynierska: Root Bridge nigdy nie może zostać wybrany przypadkowo na podstawie najniższego fabrycznego adresu MAC! Administrator musi świadomie skonfigurować najniższy priorytet (np. spanning-tree vlan 1-4094 priority 4096) na głównym przełączniku rdzeniowym.
Most główny (Root Bridge): Przełącznik w sieci STP o najniższej wartości Bridge ID, stanowiący logiczny punkt odniesienia (korzeń) całej topologii, względem którego wszystkie pozostałe przełączniki kalkulują najkrótsze bezpętlowe ścieżki transmisyjne.
Proces elekcji w STP: Root Bridge, Root Port i Designated Port

Przypadkowy wybór przełącznika Root Bridge to jeden z najczęstszych i najbardziej katastrofalnych błędów projektowych. Jeśli administratorem nie ustawi priorytetów ręcznie, o elekcji zdecyduje adres MAC. Wówczas najstarszy, najwolniejszy przełącznik dostępowy w piwnicy (mający historycznie najniższy adres MAC) może zostać wybrany korzeniem całej sieci kampusowej!

W efekcie cały ruch tranzytowy kampusu popłynie przez słaby przełącznik dostępowy i jego 1-gigabitowe łącza, doprowadzając do potężnego zatoru i załamania wydajności sieci.

Skróty użyte w tym slajdzie:
RB – Root Bridge – przełącznik główny stanowiący logiczny korzeń drzewa rozpinającego STP.
RP – Root Port – port przełącznika niebędącego korzeniem, charakteryzujący się najniższym kosztem dotarcia do Root Bridge.
DP – Designated Port – port wyznaczony w danym segmencie sieci odpowiedzialny za przekazywanie ramek w stronę korzenia.
BPDU – Bridge Protocol Data Unit – ramka sterująca protokołu STP wymieniana między przełącznikami w celu budowy topologii.

19/53
Stany portów w klasycznym STP i czas konwergencji
Cel slajdu: Przedstawienie pięciu stanów portów klasycznego protokołu IEEE 802.1D oraz wyjaśnienie przyczyn powolnej konwergencji (30–50 sekund).

Dlaczego klasyczny STP IEEE 802.1D jest zbyt wolny?

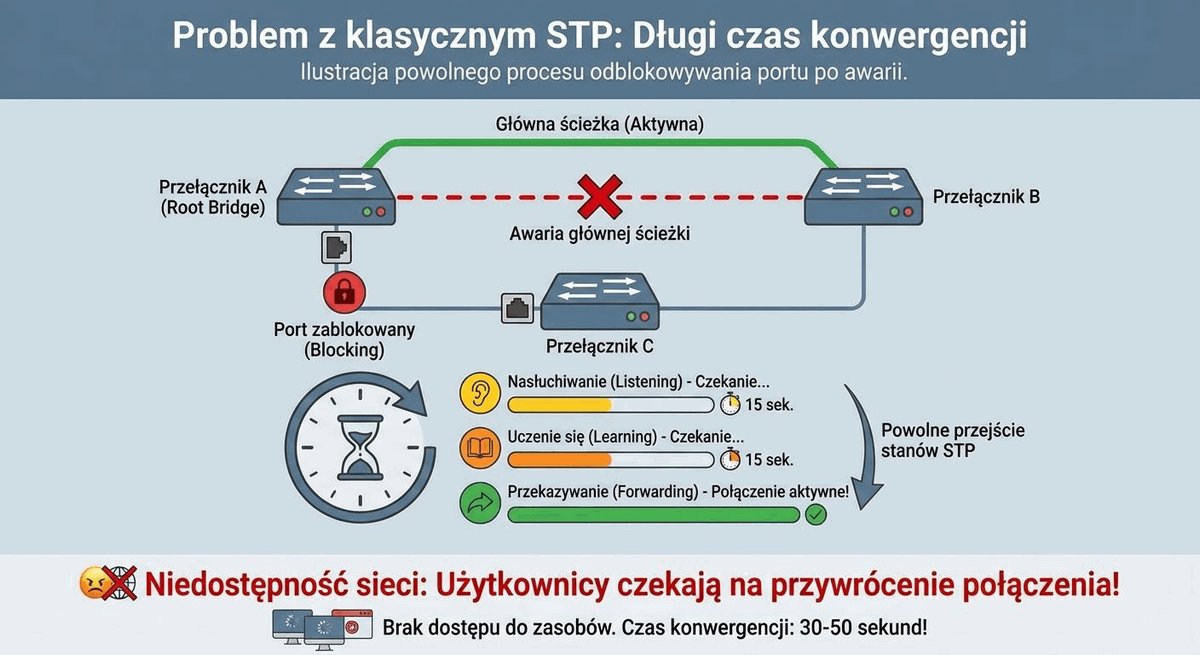
Klasyczny protokół STP przechodzi przez pięć stanów przed odblokowaniem transmisji:

  • Blocking (Blokowanie): port odrzuca ramki danych i nie uczy się adresów MAC; jedynie nasłuchuje i przetwarza ramki BPDU.
  • Listening (Nasłuchiwanie – 15 s): port przetwarza ramki BPDU i przygotowuje się do przejścia do stanu aktywnego; brak transmisji danych i nauki MAC.
  • Learning (Uczenie się – 15 s): port uczy się adresów MAC ze strumienia przychodzącego i wypełnia tablicę CAM, lecz nadal nie przesyła pakietów użytkowników.
  • Forwarding (Przekazywanie): port w pełni przesyła pakiety danych oraz ramki BPDU.
  • Disabled (Wyłączony): port wyłączony administracyjnie przez inżyniera.
Problem timerów: Czas przejścia z blokady do forwardowania wynosi domyślnie aż 30–50 sekund (Max Age 20 s + 2 × Forward Delay 15 s). W dzisiejszych sieciach taki przestój powoduje zerwanie połączeń VoIP i awarię systemów!
Forward Delay w protokole STP: Czas (domyślnie 15 sekund), jaki port przełącznika spędza kolejno w stanie Listening oraz Learning przed przejściem do stanu Forwarding, zapobiegający powstawaniu tymczasowych pętli podczas rekonfiguracji topologii.
Stany portów w klasycznym STP i czas konwergencji

Klasyczny algorytm 802.1D opierał się na sztywnych timerach (Hello Time = 2 s, Forward Delay = 15 s, Max Age = 20 s). W przypadku fizycznej awarii łącza przełącznik musiał najpierw odczekać wygaśnięcie Max Age (20 sekund), a następnie odczekać dwa okresy Forward Delay (2 × 15 sekund), zanim port zapasowy zaczął przesyłać ruch.

Dla nowoczesnych aplikacji biznesowych, wideokonferencji i telefonii VoIP 50-sekundowa przerwa w łączności jest równoznaczna z całkowitą katastrofą operacyjną.

Skróty użyte w tym slajdzie:
STP – Spanning Tree Protocol – klasyczny protokół drzewa rozpinającego (IEEE 802.1D).
BPDU – Bridge Protocol Data Unit – ramka konfiguracyjna protokołu STP.
CAM – Content-Addressable Memory – pamięć asocjacyjna tablicy adresów MAC.
Forward Delay – czas przebywania portu w stanie Listening i Learning (15 s).
Max Age – czas ważności informacji BPDU przed uznaniem awarii sąsiada (20 s).

20/53
Protokół Rapid Spanning Tree (RSTP, IEEE 802.1w / IEEE 802.1Q)
Cel slajdu: Przedstawienie architektury protokołu RSTP, redukcji stanów portów oraz nowych ról portów (Alternate i Backup) zapewniających subsekundową konwergencję.

Nowoczesna, błyskawiczna konwergencja warstwy 2

Standard IEEE 802.1w (RSTP, zintegrowany w Standard IEEE 802.1Q-2022 (Bridges and Bridged Networks)) zredukował czas reakcji na awarię do setek milisekund:

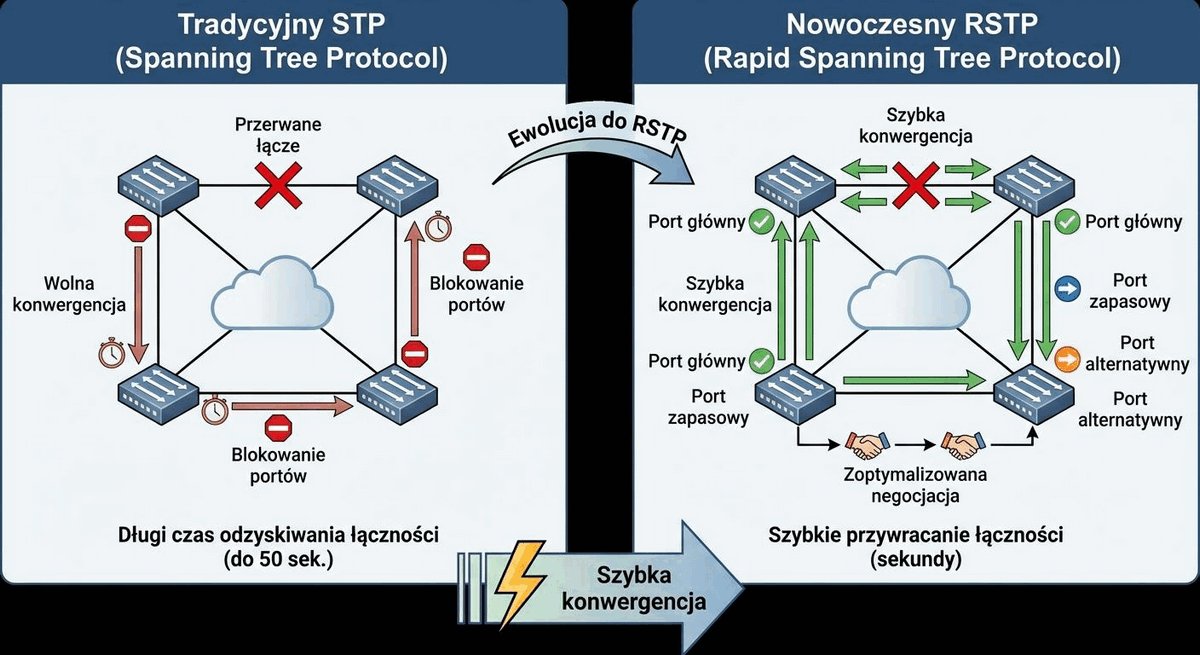
  • Trzy zredukowane stany portów: Discarding (odrzucanie – połączenie stanów Disabled, Blocking i Listening), Learning (uczenie się MAC) oraz Forwarding (przekazywanie danych).
  • Nowe role portów:
    • Alternate Port: port zapasowy dla portu głównego (Root Port), natychmiast gotowy do przejęcia roli RP po awarii łącza głównego!
    • Backup Port: port rezerwowy dla portu wyznaczonego (Designated Port) na segmencie współdzielonym.
  • Aktywne utrzymywanie łączności: każdy przełącznik generuje własne ramki BPDU co Hello Time; brak trzech kolejnych BPDU (6 sekund) oznacza natychmiastową awarię łącza bez czekania na Max Age!
Subsekundowa konwergencja: Dzięki rolom Alternate Port przełącznik zna swoją ścieżkę zapasową, zanim nastąpi awaria – przełączenie następuje w czasie poniżej kilkudziesięciu milisekund.
Protokół RSTP (Rapid Spanning Tree Protocol): Protokół drzewa rozpinającego zdefiniowany w normie IEEE 802.1w i zintegrowany w IEEE 802.1Q, zapewniający konwergencję topologii L2 w czasie rzędu setek milisekund dzięki aktywnemu mechanizmowi negocjacji Proposal/Agreement.
Protokół Rapid Spanning Tree (RSTP, IEEE 802.1w / IEEE 802.1Q)

W klasycznym STP przełącznik musiał biernie czekać na rozgłoszenie nowej topologii przez Root Bridge. W protokole RSTP każdy przełącznik działa proaktywnie – sam generuje ramki BPDU i stale weryfikuje obecność sąsiadów.

Wprowadzenie roli Alternate Port oznacza obecność wstępnie skalkulowanej ścieżki zapasowej do korzenia. W momencie zerwania łącza głównego port Alternate przechodzi do stanu Forwarding niemal natychmiast, bez konieczności przechodzenia przez etapy Listening i Learning.

Skróty użyte w tym slajdzie:
RSTP – Rapid Spanning Tree Protocol – protokół szybkiego drzewa rozpinającego (IEEE 802.1w).
IEEE 802.1Q – nadrzędny standard mostkowania, sieci VLAN i protokołów STP/RSTP/MSTP.
Discarding – zintegrowany stan portu w RSTP łączący brak transmisji i brak uczenia MAC.
Alternate Port – predefiniowana zapasowa ścieżka do Root Bridge w RSTP.
Backup Port – zapasowa ścieżka dla portu Designated na łączu współdzielonym.

21/53
Mechanizm synchronizacji Proposal/Agreement w RSTP
Cel slajdu: Przedstawienie mechanizmu uzgadniania stanu portów Proposal/Agreement na łączach punkt-punkt (Point-to-Point) i eliminacji konieczności odliczania timerów.

Aktywna negocjacja zamiast biernego odliczania timerów

RSTP osiąga subsekundową konwergencję na łączach punkt-punkt za pomocą procedury uzgadniania:

  • Wymóg łącza Point-to-Point: mechanizm działa wyłącznie na łączach pracujących w trybie Full Duplex łączących bezpośrednio dwa przełączniki.
  • Krok 1 (Proposal): po podniesieniu łącza przełącznik nadrzędny wysyła ramkę BPDU z ustawioną flagą Proposal, proponując przejście swojego portu w stan Designated Forwarding.
  • Krok 2 (Sync): przełącznik odbiorczy błyskawicznie blokuje tymczasowo wszystkie swoje porty niesłużące jako porty brzegowe (mechanizm Sync), gwarantując brak pętli.
  • Krok 3 (Agreement): przełącznik odbiorczy odsyła ramkę BPDU z flagą Agreement; port nadawcy natychmiast przechodzi w stan Forwarding – cały proces trwa ułamki milisekund!
Klucz do szybkości: Zamiast sztywnego czekania przez 30 sekund na wygaśnięcie timerów, przełączniki bezpośrednio potwierdzają brak zagrożenia pętlą i natychmiast otwierają ruch danych.
Mechanizm Proposal/Agreement: Proces szybkiej, dwukierunkowej negocjacji stanów portów pomiędzy bezpośrednio połączonymi przełącznikami RSTP na łączach Full Duplex, umożliwiający bezpieczne przejście portu w stan Forwarding w ułamku sekundy.
Mechanizm synchronizacji Proposal/Agreement w RSTP

Procedura Proposal/Agreement kaskadowo przemieszcza się w dół drzewa rozpinającego – od przełącznika Root Bridge w stronę przełączników warstwy dostępu. Na każdym łączu punkt-punkt proces ten zajmuje zaledwie czas propagacji ramki tam i z powrotem (Round-Trip Time).

W sieci kampusowej o średnicy 3–5 przeskoków całkowity czas konwergencji topologii po podłączeniu nowego przełącznika wynosi zazwyczaj poniżej 50 milisekund.

Błyskawiczna konwergencja mechanizmu Proposal/Agreement w protokole RSTP (IEEE 802.1Q) jest możliwa wyłącznie na łączach typu Punkt-Punkt pracujących w trybie pełnego dupleksu (Full-Duplex). Jeżeli przełącznik wykryje łącze współdzielone (np. port pracujący w trybie Half-Duplex podłączony do koncentratora HUB), mechanizm natychmiastowego uzgadniania zostaje zablokowany, a port powraca do odliczania klasycznych timerów (Forward Delay = 15 s) w celu uniknięcia pętli przełączania.

Skróty użyte w tym slajdzie:
RSTP – Rapid Spanning Tree Protocol – szybkie drzewo rozpinające.
P2P – Point-to-Point – bezpośrednie łącze dwupunktowe Full Duplex.
Sync – proces synchronizacji i tymczasowego zabezpieczenia portów w przełączniku.
Agreement – ramka potwierdzająca gotowość przejścia portu w stan Forwarding.
RTT – Round-Trip Time – czas obiegu sygnału w łączu w obie strony.

22/53
Optymalizacja portów brzegowych: funkcja PortFast (Edge Port)
Cel slajdu: Przedstawienie roli funkcji PortFast (Edge Port) na portach podłączonych do urządzeń końcowych, natychmiastowego przejścia w stan Forwarding i eliminacji generowania TCN.

Natychmiastowy dostęp dla stacji roboczych i serwerów

Funkcja PortFast (w terminologii normy IEEE: Edge Port) optymalizuje porty dostępowe dla urządzeń końcowych:

  • Zasada działania: port z włączonym PortFast pomija stany Listening i Learning, przechodząc natychmiast w stan Forwarding w ułamku sekundy po podłączeniu kabla.
  • Eliminacja problemu DHCP: stacja robocza otrzymuje adres IP natychmiast po włączeniu zasilania; brak opóźnień uniemożliwiających pobranie konfiguracji sieciowej i logowanie do domeny AD.
  • Brak generowania TCN (Topology Change Notification): podłączenie lub odłączenie laptopa nie wywołuje powiadomienia o zmianie topologii i nie resetuje tablic MAC w całej sieci kampusowej!
Kategoryczna reguła: Funkcję PortFast wolno konfigurować wyłącznie na portach podłączonych do urządzeń końcowych (komputery, drukarki, kamery). Włączenie jej na łączu między przełącznikami grozi natychmiastową pętlą!
Port brzegowy (Edge Port / PortFast): Port przełącznika sieciowego skonfigurowany do bezpośredniej obsługi urządzeń końcowych, który przechodzi w stan Forwarding natychmiast po wykryciu łącza fizycznego, nie generując przy tym powiadomień o zmianie topologii TCN.
Optymalizacja portów brzegowych: funkcja PortFast (Edge Port)

Bez włączenia funkcji PortFast system operacyjny komputera podłączonego do gniazdka sieciowego czeka do 30–50 sekund na odblokowanie portu przez przełącznik. W tym czasie klient DHCP wysyła kilka zapytań Discover bez odpowiedzi, po czym przydziela sobie losowy adres z puli APIPA (169.254.x.x).

Ponadto każde włączenie i wyłączenie komputera generowałoby ramkę TCN, zmuszając wszystkie przełączniki w kampusie do skracania czasu życia wpisów w tablicy MAC z 300 s do 15 s, wywołując niepotrzebny flooding unicastowy.

Skróty użyte w tym slajdzie:
Edge Port – port brzegowy wg terminologii standardu IEEE 802.1D/802.1Q.
TCN – Topology Change Notification – powiadomienie o zmianie topologii STP.
DHCP – Dynamic Host Configuration Protocol – protokół automatycznej konfiguracji sieci.
APIPA – Automatic Private IP Addressing – adresacja link-local 169.254.0.0/16 przy braku DHCP.
AD – Active Directory – usługa katalogowa Microsoftu w sieciach korporacyjnych.

23/53
Zabezpieczenie portów brzegowych: mechanizm BPDU Guard
Cel slajdu: Przedstawienie mechanizmu ochronnego BPDU Guard, zabezpieczenia portów brzegowych przed nieautoryzowanym podłączeniem przełączników oraz trybu err-disabled.

Ochrona przed nieuprawnionymi przełącznikami i pętlami użytkowników

Mechanizm BPDU Guard stanowi obowiązkowe uzupełnienie funkcji PortFast na portach dostępowych:

  • Zagrożenie w strefie użytkownika: pracownik lub student przynosi z domu prywatny tani przełącznik biurkowy, wpina go do dwóch gniazdek w ścianie lub łączy porty w pętlę.
  • Zasada działania BPDU Guard: port brzegowy z założenia nigdy nie powinien odebrać ramki BPDU. Jeśli na porcie z BPDU Guard pojawi się choć jedna ramka BPDU, przełącznik natychmiast wyłącza port do stanu błędu: err-disabled!
  • Skutek ochronny: potencjalna pętla zostaje zdławiona w zarodku w czasie < 1 ms, a sieć kampusowa pozostaje w 100% stabilna.
Złota zasada bezpieczeństwa: Na każdym porcie przełącznika dostępowego skonfigurowanym jako PortFast/Edge Port należy bezwzględnie włączyć funkcję BPDU Guard (np. spanning-tree portfast bpduguard default).
BPDU Guard: Mechanizm bezpieczeństwa warstwy 2, który natychmiast blokuje i wprowadza w stan err-disabled port brzegowy przełącznika w chwili odebrania na nim dowolnej ramki BPDU, chroniąc sieć przed obcymi przełącznikami i pętlami.
Zabezpieczenie portów brzegowych: mechanizm BPDU Guard

Wprowadzenie obcego przełącznika przez nieświadomego użytkownika do sieci korporacyjnej niesie ogromne ryzyko. Taki niezarządzalny przełącznik może wysyłać ramki BPDU z niższym Bridge ID, próbując przejąć rolę Root Bridge dla całego VLAN-u.

Dzięki BPDU Guard port, do którego podłączono obcy przełącznik, zostaje natychmiast wyłączony. W logach systemowych pojawia się zdarzenie: %SPANTREE-2-BLOCK_BPDUGUARD: Received BPDU on port Gi1/0/15 with BPDU Guard enabled. Disabling port. (zob. wytyczne konfiguracji: Cisco Support: Spanning Tree Protocol Enhancements (PortFast, BPDU Guard, Root Guard)).

Skróty użyte w tym slajdzie:
BPDU – Bridge Protocol Data Unit – ramka konfiguracyjna STP.
err-disabled – stan awaryjnego programowego zablokowania portu przez system IOS.
PortFast – tryb natychmiastowego przejścia portu w stan Forwarding.
SOHO – Small Office / Home Office – małe przełączniki biurkowe przynoszone przez użytkowników.
CLI – Command Line Interface – interfejs linii poleceń przełącznika.

24/53
Zaawansowana ochrona topologii STP: Root Guard i Loop Guard
Cel slajdu: Przedstawienie zaawansowanych mechanizmów ochronnych Root Guard i Loop Guard, stabilizujących pozycję Root Bridge i chroniących przed jednokierunkowością łączy.

Stabilizacja hierarchii drzewa rozpinającego i ochrona łączy

Zaawansowane mechanizmy chronią architekturę drzewa rozpinającego przed zaburzeniami:

  • Root Guard:
    • Konfigurowany na portach przełączników dystrybucyjnych skierowanych w dół (w stronę warstwy dostępu).
    • Zasada: port z Root Guard nie ma prawa stać się portem głównym (Root Port). Jeśli odbierze lepszą ramkę BPDU (z niższym BID), wprowadza port w stan root-inconsistent (brak przesyłu danych). Po ustaniu nieuprawnionych BPDU port samoczynnie wraca do pracy.
  • Loop Guard:
    • Konfigurowany na portach blokowanych (Alternate/Backup).
    • Zasada: chroni przed awarią jednokierunkową światłowodu (Uni-directional Link), gdy port przestaje odbierać BPDU i błędnie przechodzi w stan Forwarding. Wprowadza port w stan loop-inconsistent.
Rola Root Guard: Gwarantuje, że zaplanowany przez architekta przełącznik rdzeniowy nigdy nie utraci roli korzenia drzewa na rzecz nieautoryzowanego przełącznika podłączonego na niższym szczeblu hierarchii.
Root Guard: Funkcja ochronna protokołu STP konfigurowana na wyznaczonych portach przełącznika, uniemożliwiająca urządzeniom podłączonym do tych portów przejęcie roli mostu głównego (Root Bridge) w topologii drzewa rozpinającego.
Zaawansowana ochrona topologii STP: Root Guard i Loop Guard

Mechanizm Loop Guard rozwiązuje problem cichych awarii torów światłowodowych. Światłowód duplex składa się z dwóch niezależnych włókien: nadawczego (Tx) i odbiorczego (Rx). Przerwanie pojedynczego włókna Rx powoduje, że przełącznik przestaje odbierać ramki BPDU.

W standardowym STP po upływie Max Age port blokowany uznałby, że sąsiad zniknął, i samowolnie przeszedłby w stan Forwarding, wywołując potężną pętlę. Loop Guard wykrywa brak BPDU na porcie blokowanym i zamraża go w bezpiecznym stanie loop-inconsistent (szczegóły w dokumencie Cisco Support: Spanning Tree Protocol Enhancements).

Skróty użyte w tym slajdzie:
Root Guard – ochrona pozycji mostu głównego w topologii STP.
Loop Guard – ochrona przed powstawaniem pętli wywołanych przerwaniem odbioru BPDU.
UDLD – UniDirectional Link Detection – protokół wykrywania jednokierunkowości łączy.
BID – Bridge Identifier – unikalny identyfikator przełącznika.
Tx / Rx – Transmit / Receive – tory nadawczy i odbiorczy łącza optycznego.

25/53
Obsługa STP w środowiskach wielo-VLAN: Cisco PVST+ i Rapid-PVST+
Cel slajdu: Przedstawienie różnic pomiędzy CST (jednym wspólnym drzewem) a PVST+/Rapid-PVST+ (niezależnym drzewem dla każdego VLAN-u) oraz bilansu obciążenia CPU.

Niezależne drzewo rozpinające dla każdej sieci wirtualnej

W środowiskach z wieloma sieciami VLAN stosuje się dwa odmienne podejścia architektoniczne:

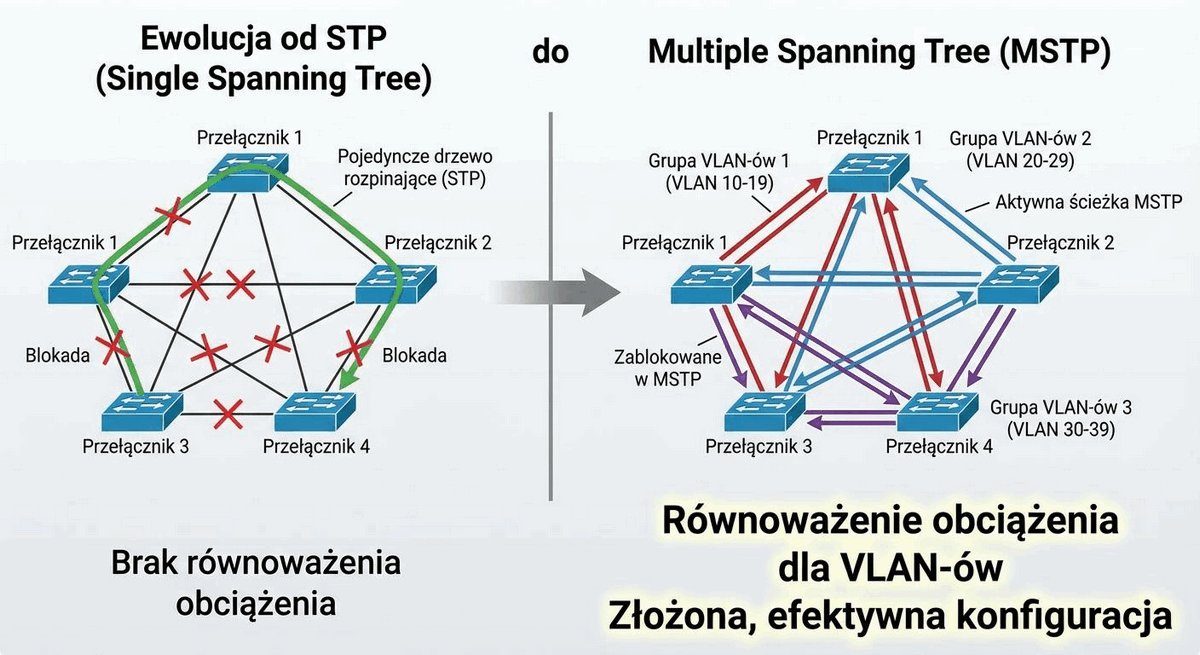
  • CST (Common Spanning Tree – standard IEEE 802.1D): jedno wspólne drzewo dla wszystkich VLAN-ów w sieci. Jeśli port jest zablokowany przez STP, jest zablokowany dla całego ruchu – brak możliwości równoważenia obciążenia (Load Balancing).
  • PVST+ / Rapid-PVST+ (Cisco): przełącznik utrzymuje niezależną instancję drzewa dla każdego VLAN-u z osobna.
    • Możliwość podziału ról: Przełącznik Dystrybucji 1 jest Root Bridge dla VLAN 10, 20, a Przełącznik Dystrybucji 2 jest Root Bridge dla VLAN 30, 40.
    • Oba łącza fizyczne (Uplink A i B) przesyłają ruch jednocześnie!
Ostrzeżenie inżynierskie (wydajność CPU): W architekturze Cisco PVST+ i Rapid-PVST+ każda sieć VLAN utrzymuje całkowicie odrębną instancję protokołu drzewa rozpinającego i generuje własne ramki BPDU wysyłane co 2 sekundy. W dużych sieciach kampusowych z setkami VLAN-ów narzut ten powoduje znaczne obciążenie jednostki CPU przełącznika i wysycenie pasma sterowania, co stanowi bezpośrednią przesłankę do wdrożenia standardu MSTP (IEEE 802.1s).
Rapid-PVST+ (Rapid Per-VLAN Spanning Tree Plus): Własnościowa implementacja protokołu RSTP firmy Cisco, uruchamiająca niezależną, subsekundową instancję szybkiego drzewa rozpinającego dla każdej wirtualnej sieci lokalnej (VLAN) skonfigurowanej na przełączniku.
Obsługa STP w środowiskach wielo-VLAN: Cisco PVST+ i Rapid-PVST+

Protokół Rapid-PVST+ jest domyślnym trybem pracy w większości przełączników Cisco Catalyst. Zapewnia znakomitą elastyczność i prostotę konfiguracji w mniejszych i średnich sieciach kampusowych, gdzie liczba VLAN-ów nie przekracza kilkudziesięciu.

Jednak w rozległych kampusach uniwersyteckich z setkami sieci VLAN narzut na przetwarzanie BPDU przez procesor przełącznika staje się barierą skalowalności. Rozwiązaniem tego problemu jest otwarty standard Multiple Spanning Tree Protocol (MSTP).

Skróty użyte w tym slajdzie:
CST – Common Spanning Tree – jedno wspólne drzewo STP dla całej sieci (IEEE 802.1D).
PVST+ – Per-VLAN Spanning Tree Plus – niezależne drzewo STP dla każdego VLAN-u.
Rapid-PVST+ – szybka wersja PVST+ oparta na algorytmie RSTP 802.1w.
CPU – Central Processing Unit – procesor sterujący przełącznika sieciowego.
Load Balancing – równoważenie obciążenia ruchem na wielu łączach.

26/53
Protokół Multiple Spanning Tree (MSTP, IEEE 802.1s): idea MSTI
Cel slajdu: Przedstawienie założeń protokołu MSTP (IEEE 802.1s), koncepcji mapowania wielu VLAN-ów do nielicznych instancji MSTI oraz optymalizacji wykorzystania CPU.

Równoważenie obciążenia bez przeciążania procesora przełącznika

Standard IEEE 802.1s (MSTP, włączony do IEEE 802.1Q) łączy najlepsze zalety CST oraz PVST+:

  • Mapowanie VLAN-ów do instancji (MSTI): setki wirtualnych sieci grupuje się w zaledwie kilka logicznych instancji drzewa (np. 100 VLAN-ów przypisanych do Instancji 1, a kolejne 100 do Instancji 2).
  • Radykalna oszczędność procesora: zamiast generować setki ramek BPDU, przełącznik wysyła dokładnie jedną ramkę BPDU zawierającą w sobie rekordy (M-Records) dla wszystkich instancji!
  • Regiony MST (MST Regions): grupa przełączników o identycznej nazwie konfiguracji (Name), numerze rewizji (Revision) oraz identycznej tabeli powiązań VLAN-do-Instancji.
  • Wsteczna kompatybilność: pełna interoperacyjność z klasycznym STP i RSTP za pośrednictwem drzewa CIST (Common and Internal Spanning Tree).
Inżynierski standard: MSTP jest otwartym standardem wieloproducentowym (Vendor-Neutral), stanowiącym optymalny wybór w heterogenicznych sieciach kampusowych łączących przełączniki różnych producentów.
Multiple Spanning Tree Protocol (MSTP): Otwarty protokół drzewa rozpinającego zdefiniowany w IEEE 802.1s/802.1Q, umożliwiający przypisanie wielu sieci VLAN do ograniczonej liczby instancji drzewa (MSTI) w celu równoważenia obciążenia przy minimalnym zużyciu zasobów procesora.
Protokół Multiple Spanning Tree (MSTP, IEEE 802.1s): idea MSTI

Podstawową siłą MSTP jest skalowalność. Niezależnie od tego, czy w sieci kampusowej istnieje 10, czy 1000 VLAN-ów, procesor przełącznika jest obciążony kalkulacją zaledwie 2 lub 3 drzew rozpinających.

Wszystkie przełączniki należące do tego samego Regionu MST muszą posiadać rygorystycznie identyczną sumę skrótu (Digest) konfiguracji. Jakakolwiek rozbieżność w przypisaniu choćby jednego VLAN-u do innej instancji powoduje, że przełącznik traktowany jest jako obcy region, co prowadzi do zablokowania portów na granicy regionów.

Skróty użyte w tym slajdzie:
MSTP – Multiple Spanning Tree Protocol – wieloinstancyjny protokół drzewa rozpinającego.
MSTI – Multiple Spanning Tree Instance – konkretna instancja drzewa w regionie MST.
CIST – Common and Internal Spanning Tree – nadrzędne drzewo łączące regiony MST.
VLAN – Virtual Local Area Network – wirtualna sieć lokalna.
M-Record – rekord danych konkretnej instancji MSTI przenoszony w ramce BPDU.

27/53
Równoważenie obciążenia ruchem za pomocą instancji MSTP
Cel slajdu: Przedstawienie praktycznego modelu projektowego podziału ruchu z wykorzystaniem dwóch instancji MSTP (MSTI 1 i MSTI 2) na łączach magistralnych Trunk.

Praktyczny model aktywnego podziału pasma w warstwie 2

Projekt podziału obciążenia na łączach redundantnych z wykorzystaniem dwóch instancji MSTP:

  • Struktura VLAN-ów: w sieci wydzielono VLAN-y parzyste (10, 20, 30...) oraz nieparzyste (11, 21, 31...).
  • Podział na instancje MSTI:
    • Instancja 1 (MSTI 1): przypisane VLAN-y parzyste; Root Bridge skonfigurowany na Przełączniku Dystrybucji 1 (SW-DIST-01).
    • Instancja 2 (MSTI 2): przypisane VLAN-y nieparzyste; Root Bridge skonfigurowany na Przełączniku Dystrybucji 2 (SW-DIST-02).
  • Efekt transmisyjny: na łączu Uplink A ruch dla VLAN-ów parzystych jest aktywny, a dla nieparzystych zablokowany. Na łączu Uplink B sytuacja jest odwrotna – oba łącza pracują równolegle!
Korzyść: Żadne łącze fizyczne nie pozostaje bezczynne. W normalnym stanie sieć wykorzystuje 100% dostępnej przepustowości obu kabli, zachowując przy tym pełną automatyczną ochronę w przypadku awarii jednego z nich.
Równoważenie obciążenia L2 (L2 Load Balancing): Metoda dystrybucji ruchu sieciowego w warstwie 2, w której różne sieci wirtualne VLAN wykorzystują odrębne ścieżki fizyczne jako ścieżki aktywne, eliminując bezczynność zapasowych łączy transmisyjnych.
Równoważenie obciążenia ruchem za pomocą instancji MSTP

W przypadku awarii przełącznika SW-DIST-01 instancja MSTI 1 błyskawicznie przełącza swój port na łączu Uplink B ze stanu blokowania do forwardowania w czasie poniżej sekundy.

W rezultacie na czas naprawy awarii oba strumienie ruchu (VLAN parzyste i nieparzyste) płyną wspólnie przez łącze Uplink B do przełącznika SW-DIST-02. Użytkownicy rejestrują jedynie chwilowy, ułamkowy spadek pasma, nie tracąc łączności z siecią.

Skróty użyte w tym slajdzie:
MSTP – Multiple Spanning Tree Protocol – standard IEEE 802.1s mapujący wiele sieci VLAN na zdefiniowane instancje drzewa MSTI.
MSTI – Multiple Spanning Tree Instance – niezależna instancja drzewa rozpinającego obsługująca określoną grupę sieci VLAN.
CIST – Common and Internal Spanning Tree – nadrzędne drzewo rozpinające zapewniające spójną topologię wewnątrz i na zewnątrz regionów MST.
IST – Internal Spanning Tree – instancja zerowa (MSTI 0) koordynująca topologię wewnątrz pojedynczego regionu MST.

28/53
Ograniczenie STP: blokowanie portów i potrzeba agregacji łączy
Cel slajdu: Przedstawienie inżynierskich ograniczeń rodziny protokołów Spanning Tree (blokowanie pasma, ryzyko przerw konwergencji) i uzasadnienie dążenia do agregacji łączy.

Dlaczego inżynierowie dążą do eliminacji blokowania portów?

Mimo udoskonaleń, rodzina protokołów STP posiada istotne ograniczenia inżynierskie:

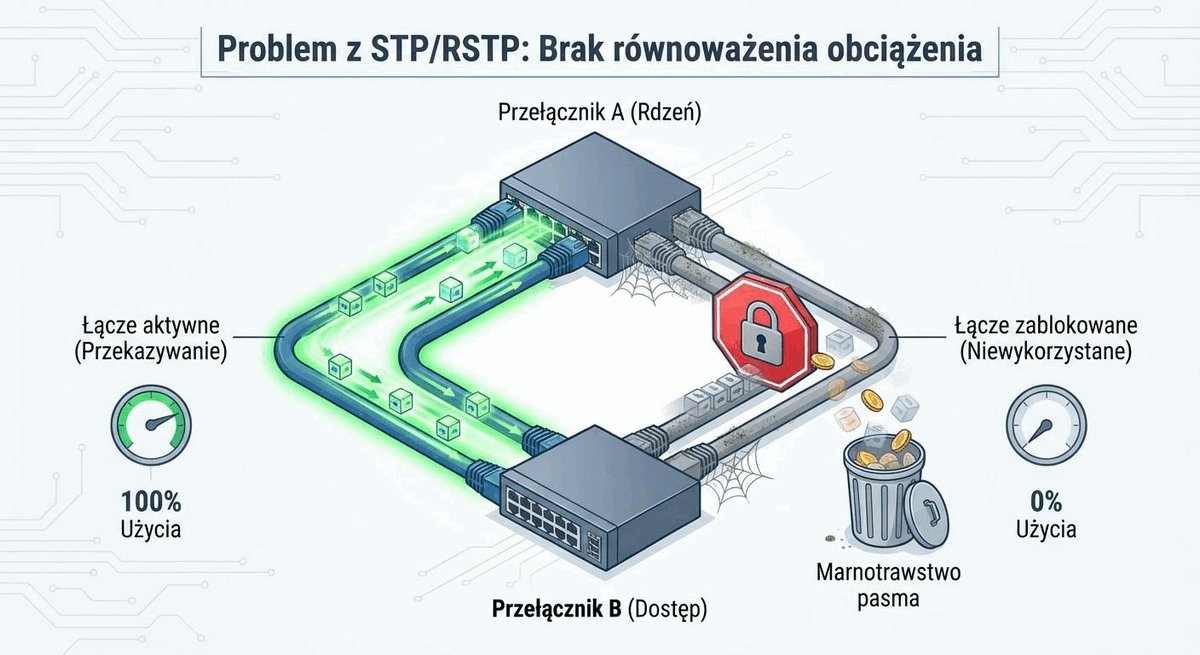
  • Marnowanie zasobów sprzętowych: na poziomie pojedynczego VLAN-u jedno z dwóch drogich łączy optycznych 10G/40G jest sztucznie zablokowane i nie przesyła ruchu.
  • Ryzyko przerw w transmisji: każda zmiana topologii (nawet krótkotrwałe zacięcie portu) wywołuje proces rekonwergencji, grożący gubieniem pakietów.
  • Złożoność diagnostyczna: diagnozowanie problemów w rozległych środowiskach STP z setkami przełączników wymaga wysokich kwalifikacji i niesie ryzyko pętli przy błędnej konfiguracji.
Nowoczesny cel projektowy: Wyeliminować blokowanie portów przez STP na rzecz agregacji łączy (Link Aggregation / LACP), w której wszystkie fizyczne kable są w 100% aktywne, tworząc jedną logiczną magistralę o sumarycznej przepustowości.
Port blokowany przez STP (STP Blocked Port): Fizyczny port przełącznika celowo wprowadzony w stan logicznego braku przekazywania ramek danych użytkownika w celu przerwania pętli transmisyjnej w warstwie 2.
Ograniczenie STP: blokowanie portów i potrzeba agregacji łączy

W klasycznym modelu hierarchicznym z protokołem STP organizacja inwestuje w podwójne łącza światłowodowe 10 Gb/s z każdego punktu dystrybucyjnego, z czego efektywnie korzysta tylko z jednego (10 Gb/s), podczas gdy drugie leży bezczynnie w rezerwie.

Dążenie do pełnej utylizacji zakupionego pasma i eliminacji stanów przejściowych STP doprowadziło do rozwoju technologii agregacji łączy (EtherChannel / LACP) oraz wirtualizacji przełączników (M-LAG / vPC).

Skróty użyte w tym slajdzie:
STP – Spanning Tree Protocol – protokół drzewa rozpinającego.
LACP – Link Aggregation Control Protocol – protokół dynamicznej agregacji łączy.
CAPEX – Capital Expenditures – nakłady inwestycyjne ponoszone na infrastrukturę kablową.
Uplink – łącze transmisyjne do wyższej warstwy sieci.
EtherChannel – technologia grupowania portów fizycznych w jeden port logiczny.

29/53
Agregacja łączy fizycznych: koncepcja Link Aggregation (EtherChannel)
Cel slajdu: Przedstawienie idei agregacji łączy fizycznych w jeden logiczny interfejs Port-Channel, sumowania pasma oraz niewidoczności dla protokołu STP.

Wiele kabli fizycznych jako jeden logiczny interfejs transmisyjny

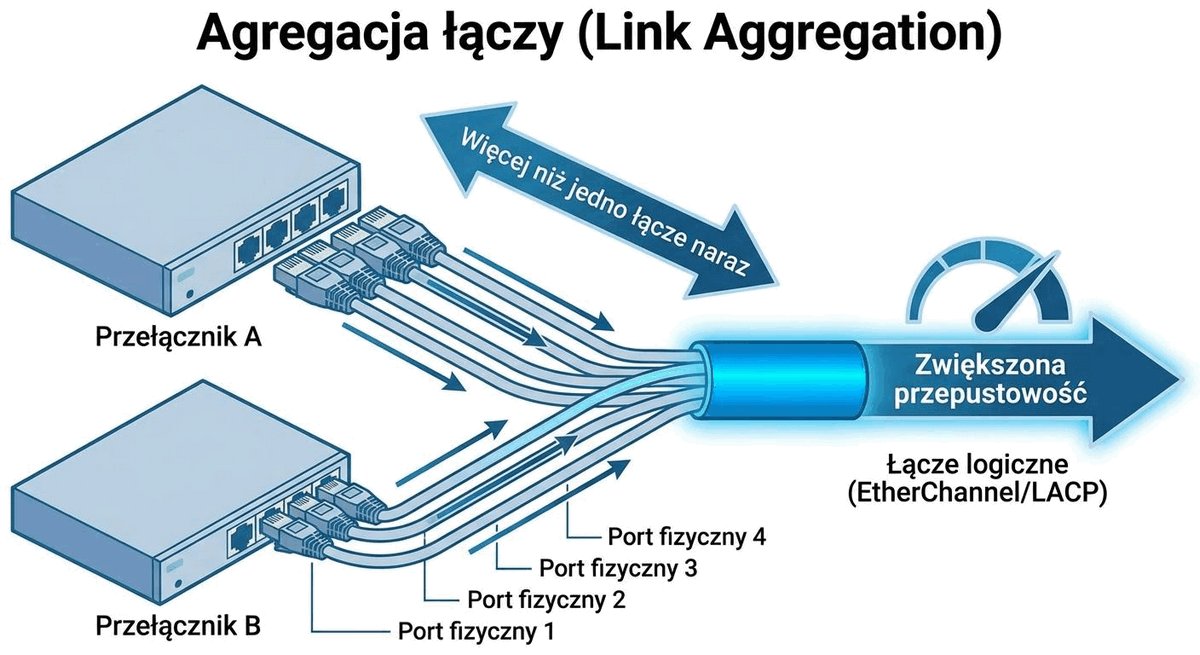
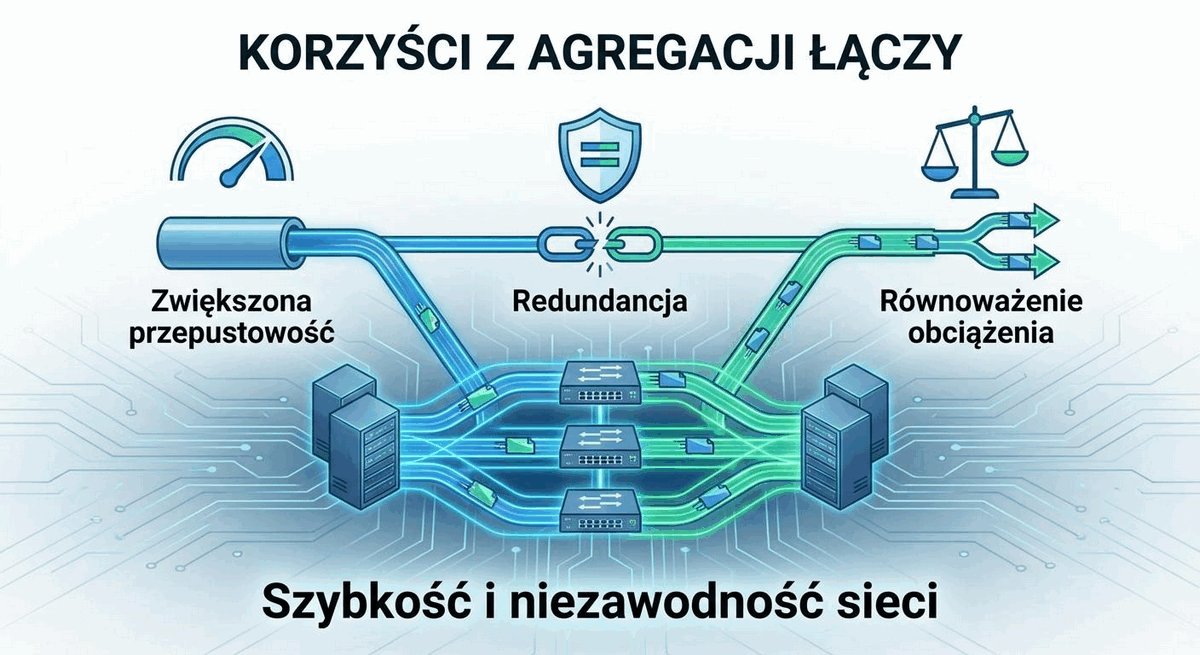
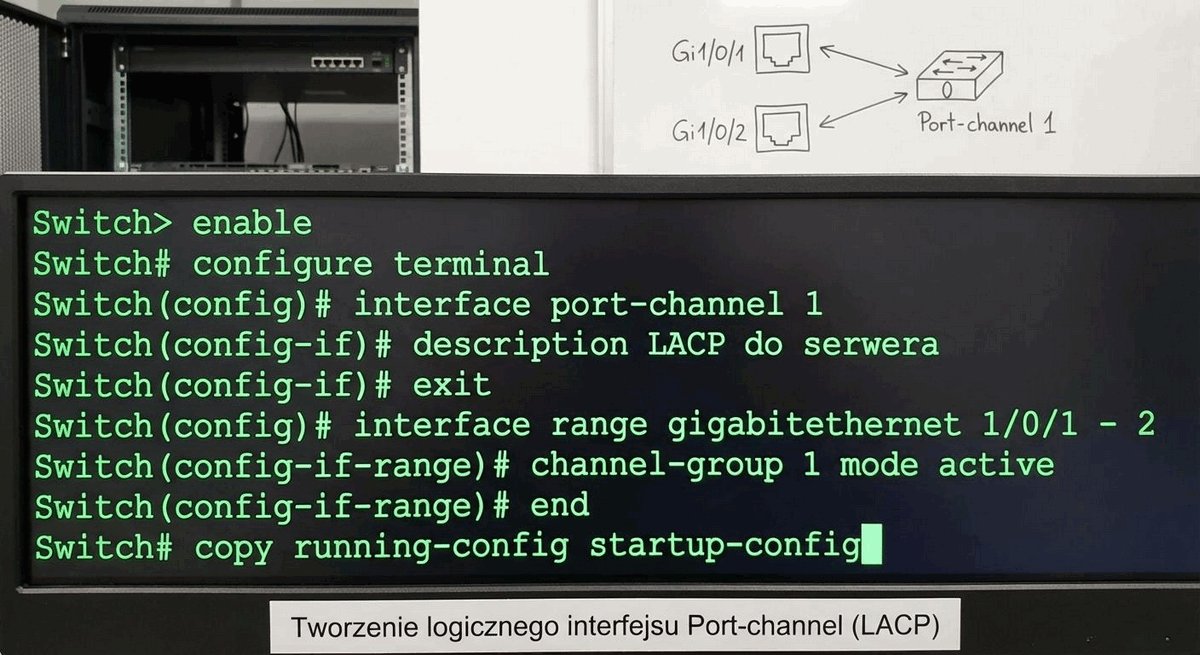
Agregacja łączy (w terminologii Cisco: EtherChannel, ogólnie: Link Aggregation) łączy od 2 do 8 fizycznych portów w jeden kanał logiczny (Port-Channel):

  • Sumowanie pasma transmisyjnego: połączenie czterech łączy 10 Gb/s tworzy jeden logiczny interfejs o przepustowości 40 Gb/s.
  • Błyskawiczna redundancja bez udziału STP: w przypadku fizycznego zerwania jednego z kabli ruch jest natychmiast przepakietowywany na pozostałe sprawne łącza w czasie mikrosekund bez rekonfiguracji drzewa rozpinającego!
  • Przezroczystość dla STP: protokół drzewa rozpinającego widzi całą wiązkę jako dokładnie jeden port logiczny – żadne z łączy wchodzących w skład wiązki nie zostaje zablokowane!
Kluczowa zasada: Wszystkie porty wchodzące w skład wiązki muszą posiadać identyczne parametry fizyczne i logiczne: tę samą prędkość, ten sam tryb duplex, ten sam zestaw dopuszczonych VLAN-ów i tę samą konfigurację tagowania!
Agregacja łączy (Link Aggregation / EtherChannel): Metoda równoległego łączenia wielu fizycznych łączy sieciowych Ethernet pomiędzy dwoma urządzeniami w jeden logiczny interfejs o sumarycznej przepustowości i wbudowanej odporności na awarie pojedynczych kabli.
Agregacja łączy fizycznych: koncepcja Link Aggregation (EtherChannel)

Technologia agregacji łączy rozwiązuje fundamentalny dylemat inżyniera sieciowego: jak zwiększyć przepustowość i niezawodność magistrali bez ryzyka zapętlenia warstwy 2. Protokół STP traktuje interfejs Port-Channel jako pojedyncze łącze punkt-punkt.

Dopóki choć jeden fizyczny kabel w wiązce pozostaje sprawny, interfejs logiczny zachowuje status Up/Up, co całkowicie zapobiega wysyłaniu powiadomień TCN i restartowaniu tablic adresów MAC w całej sieci kampusowej.

Skróty użyte w tym slajdzie:
LAG – Link Aggregation Group – grupa zagregowanych łączy fizycznych.
Port-Channel – logiczny interfejs reprezentujący zagregowaną wiązkę portów.
STP – Spanning Tree Protocol – protokół drzewa rozpinającego.
TCN – Topology Change Notification – powiadomienie o zmianie topologii.
Duplex – tryb dwukierunkowej jednoczesnej transmisji (Full Duplex).

30/53
Standard IEEE 802.1AX / IEEE 802.3ad: protokół LACP
Cel slajdu: Przedstawienie standardu otwartej agregacji łączy LACP (IEEE 802.1AX), struktury ramek LACPDU oraz mechanizmów zabezpieczających przed błędnym połączeniem kabli.

Otwarty standard automatycznej negocjacji agregacji łączy

Standard Standard IEEE 802.1AX-2020: Link Aggregation (dawniej IEEE 802.3ad) definiuje otwarty protokół LACP (Link Aggregation Control Protocol):

  • Wymiana ramek LACPDU: urządzenia wysyłają małe ramki kontrolne LACPDU co 1 s (LACP Fast) lub co 30 s (LACP Slow) na zastrzeżony adres MAC 01:80:C2:00:00:02.
  • Weryfikacja tożsamości partnera: protokół sprawdza, czy wszystkie kable z wiązki rzeczywiście trafiają do tego samego urządzenia docelowego (sprawdzanie System ID i Port Key).
  • Zabezpieczenie przed błędnym okablowaniem: jeśli instalator przypadkowo wegnie jeden kabel z wiązki do niewłaściwego przełącznika, LACP natychmiast odrzuci ten port z agregacji, chroniąc sieć przed pętlą!
Statyczny Trunk (Mode ON) vs LACP: Kategorycznie odradza się stosowanie trybu statycznego (Mode ON bez protokołu negocjacji). Statyczny EtherChannel nie wykrywa pomyłek kablowych ani uszkodzeń transceiverów, co prowadzi do powstawania czarnych dziur transmisyjnych!
Protokół LACP (Link Aggregation Control Protocol): Otwarty protokół zdefiniowany w normie IEEE 802.1AX, służący do automatycznej negocjacji, zestawiania, monitorowania i dynamicznego utrzymywania wieloportowych wiązek agregacyjnych pomiędzy urządzeniami sieciowymi.
Standard IEEE 802.1AX / IEEE 802.3ad: protokół LACP

W trybie statycznym (Mode ON) przełącznik bezwarunkowo wysyła pakiety przez wszystkie przypisane porty, zakładając, że po drugiej stronie kable są wpięte poprawnie. Jeśli po drugiej stronie port nie jest skonfigurowany w agregacji, następuje zalanie sieci lub utrata pakietów.

Protokół LACP eliminuje to ryzyko: port staje się aktywny w wiązce dopiero wtedy, gdy po obu stronach łącza pomyślnie wymienione zostaną ramki LACPDU potwierdzające zgodność parametrów prędkości, duplexu, klucza portu oraz uprawnień.

Skróty użyte w tym slajdzie:
LACP – Link Aggregation Control Protocol – protokół sterowania agregacją łączy.
LACPDU – Link Aggregation Control Protocol Data Unit – ramka kontrolna LACP.
IEEE 802.1AX – międzynarodowa norma standaryzująca agregację łączy LACP.
System ID – identyfikator przełącznika w protokole LACP (priorytet + MAC).
Port Key – parametr określający zdolność portu do współdzielenia wiązki agregacyjnej.

31/53
Tryby negocjacji agregacji: LACP a własnościowy Cisco PAgP
Cel slajdu: Porównanie otwartego protokołu LACP z własnościowym standardem Cisco PAgP oraz analiza trybów negocjacji (Active/Passive vs Desirable/Auto).

Porównanie protokołów zestawiania wiązek agregacyjnych

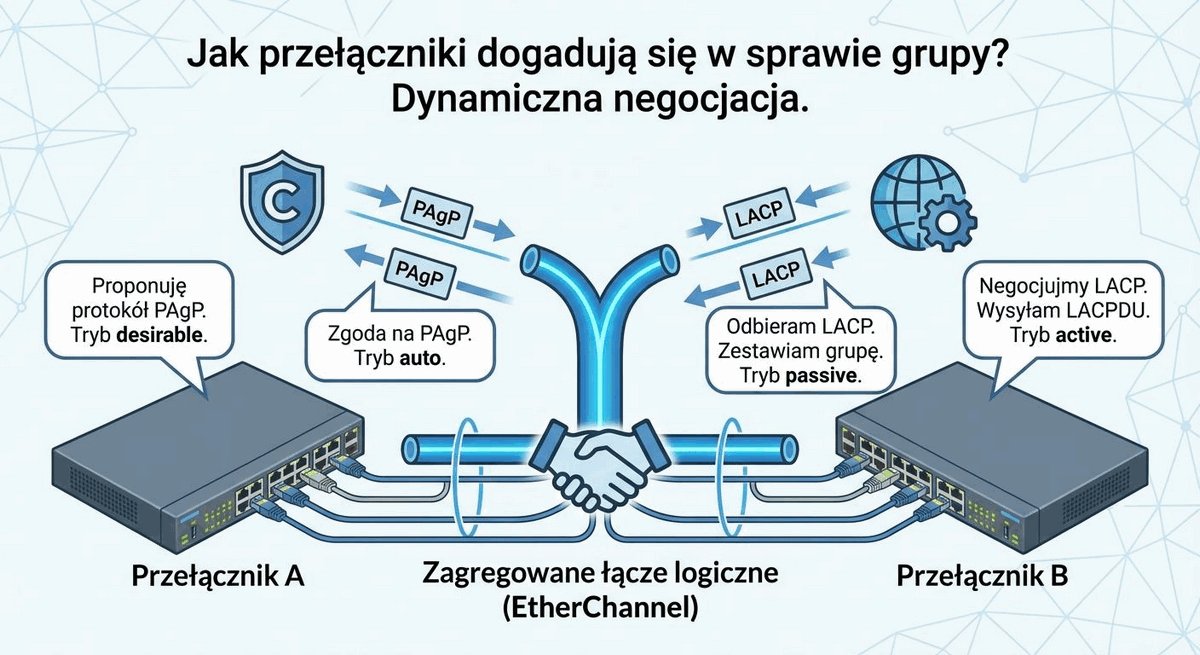
W urządzeniach sieciowych spotyka się dwa protokoły negocjacji agregacji:

CechaLACP (IEEE 802.1AX / 802.3ad)PAgP (Cisco Proprietary)
StandardOtwarty międzynarodowy IEEEWłasnościowy Cisco Systems
Tryb aktywnyActive (aktywnie inicjuje dialog)Desirable (aktywnie inicjuje dialog)
Tryb pasywnyPassive (czeka na inicjację partnera)Auto (czeka na inicjację partnera)
Liczba portówDo 16 (8 aktywnych + 8 standby)Do 8 portów aktywnych
KompatybilnośćDowolny producent, Linux, VMwareWyłącznie przełączniki Cisco
Rekomendacja projektowa: We współczesnych projektach sieci kampusowych należy stosować wyłącznie otwarty standard LACP w trybie channel-group X mode active po obu stronach łącza. Gwarantuje to pełną kompatybilność wieloproducentową.
Port Aggregation Protocol (PAgP): Historyczny, własnościowy protokół firmy Cisco służący do automatycznego zestawiania wiązek EtherChannel, obecnie zastąpiony przez powszechny otwarty standard IEEE 802.1AX (LACP).
Tryby negocjacji agregacji: LACP a własnościowy Cisco PAgP

Zestawienie wiązki dochodzi do skutku, jeśli co najmniej jedna strona łącza znajduje się w trybie aktywnym (Active w LACP lub Desirable w PAgP). Konfiguracja, w której obie strony pracują w trybie pasywnym (Passive-Passive lub Auto-Auto), skutkuje brakiem nawiązania agregacji – obie strony czekają na rozpoczęcie dialogu przez partnera.

Wdrożenie LACP w trybie Active-Active po obu stronach jest najlepszą praktyką inżynierską, minimalizującą czas zestawienia kanału i natychmiast weryfikującą spójność konfiguracji.

Skróty użyte w tym slajdzie:
LACP – Link Aggregation Control Protocol – standard IEEE 802.1AX.
PAgP – Port Aggregation Protocol – własnościowy protokół agregacji Cisco.
Active / Desirable – tryby aktywnego wysyłania zapytań o agregację.
Passive / Auto – tryby pasywnego nasłuchiwania na zapytania agregacyjne.
Standby Port – port zapasowy w LACP uaktywniany po awarii jednego z 8 portów głównych.

32/53
Algorytmy równoważenia obciążenia w agregacji łączy
Cel slajdu: Przedstawienie matematycznych algorytmów haszujących stosowanych w Port-Channel, zapobiegania reorderingowi pakietów oraz doboru kryteriów haszowania.

Dystrybucja pakietów w wiązce EtherChannel na podstawie funkcji skrótu

Dystrybucja ruchu pomiędzy fizyczne kable w wiązce opiera się na algorytmie haszującym:

  • Brak dzielenia pojedynczego pakietu: pakiety nie są dzielone na fragmenty; każda kompletna ramka Ethernet przesyłana jest w całości dokładnie jednym kablem fizycznym!
  • Ochrona przed rozsynchronizowaniem (Out-of-Order Delivery): wszystkie pakiety należące do jednego przepływu (Flow – np. konkretnej sesji TCP) muszą płynąć zawsze tym samym kablem. Zapobiega to docieraniu pakietów do odbiorcy w złej kolejności!
  • Kryteria haszowania (Load-Balance Hash): funkcja matematyczna oblicza skrót (Hash) z wybranych pól nagłówka:
    • Tylko źródłowy/docelowy MAC (src-mac / dst-mac) – nieefektywne w obecności routera!
    • Źródłowy i docelowy adres IP oraz porty L4 (src-dst-mixed-ip-port) – optymalny standard Enterprise!
Kluczowy fakt: Agregacja dwóch łączy 10 Gb/s NIE pozwala na pobranie pojedynczego pliku przez pojedynczą sesję TCP z prędkością 20 Gb/s! Pojedynczy transfer osiągnie maks. 10 Gb/s. Sumaryczne 20 Gb/s uzyskujemy dla wielu równoległych strumieni od różnych użytkowników.
Haszowanie w agregacji łączy (EtherChannel Load-Balancing): Deterministyczny algorytm matematyczny wykonywany sprzętowo przez procesor ASIC przełącznika, przypisujący pakiety do poszczególnych portów fizycznych wiązki na podstawie kombinacji adresów MAC, IP oraz portów TCP/UDP nagłówka.
Algorytmy równoważenia obciążenia w agregacji łączy

Zastosowanie niewłaściwego algorytmu haszowania może doprowadzić do sytuacji, w której jeden kabel w wiązce jest obciążony w 100%, podczas gdy pozostałe są całkowicie bezczynne (zjawisko polaryzacji ruchu). Przykładem jest haszowanie wyłącznie po adresach MAC w łączu z routerem – wszystkie pakiety do Internetu mają ten sam docelowy MAC routera, więc trafiają na ten sam kabel!

Z tego względu norma inżynierska nakazuje stosowanie algorytmów 4-krotnych (L2+L3+L4): port-channel load-balance src-dst-mixed-ip-port, co zapewnia niemal idealnie równomierny rozkład ruchu.

Skróty użyte w tym slajdzie:
Hash – funkcja skrótu przekształcająca pola nagłówka w indeks portu fizycznego.
Flow – pojedynczy przepływ sieciowy zdefiniowany przez 5-krotkę (Src IP, Dst IP, Src Port, Dst Port, Protokół).
TCP – Transmission Control Protocol – protokół sterowania transmisją połączeniową.
UDP – User Datagram Protocol – bezpołączeniowy protokół datagramowy.
ASIC – Application-Specific Integrated Circuit – sprzętowy układ scalony przełącznika.

33/53
Konfiguracja wiązki LACP w systemie Cisco IOS
Cel slajdu: Przedstawienie wzorcowej, bezbłędnej procedury konfiguracji agregacji LACP na przełącznikach dostępowych i dystrybucyjnych oraz weryfikacji CLI.

Wzorcowa implementacja Port-Channel na łączach magistralnych

Prawidłowa procedura konfiguracji dwuportowej magistrali LACP pomiędzy przełącznikami:

Switch-Access(config)# interface range GigabitEthernet 1/0/1 - 2
Switch-Access(config-if-range)# channel-group 1 mode active
Switch-Access(config-if-range)# exit
Switch-Access(config)# interface Port-channel 1
Switch-Access(config-if)# switchport mode trunk
Switch-Access(config-if)# switchport trunk allowed vlan 10,20,30,99
  • Złota zasada inżynierska: wszelkie zmiany konfiguracyjne (VLAN-y, tryb trunk, bezpieczeństwo) wykonuje się wyłącznie na interfejsie logicznym interface Port-channel 1! System samoczynnie i spójnie replikuje je na porty fizyczne.
  • Weryfikacja poprawności stanu LACP: polecenie show etherchannel summary. Flagi portów muszą wskazywać (P) – bundled in port-channel, a status grupy (SU) – Layer 2 / In use.
Komunikat błędu: Flaga (I) lub (D) przy porcie fizycznym oznacza, że port został odrzucony z wiązki z powodu niespójności konfiguracji (np. odmienna prędkość lub różne dopuszczone VLAN-y).
Polecenie show etherchannel summary: Podstawowe inżynierskie polecenie diagnostyczne w systemach sieciowych wyświetlające status logiczny grup agregacyjnych, protokół negocjacji oraz stan zaangażowania poszczególnych portów fizycznych.
Konfiguracja wiązki LACP w systemie Cisco IOS

Częstym błędem początkujących administratorów jest modyfikowanie parametrów pojedynczych portów fizycznych wchodzących w skład aktywnego kanału. Wprowadzenie innego dozwolonego VLAN-u na porcie Gi1/0/1 niż na Gi1/0/2 wywołuje natychmiastowe rozpięcie wiązki przez mechanizm ochrony spójności (Port-Channel Misconfiguration Guard).

Zawsze należy wejść w konfigurację interfejsu interface Port-channel X i tam dokonywać wszelkich modyfikacji parametrów warstwy 2.

Skróty użyte w tym slajdzie:
CLI – Command Line Interface – interfejs linii poleceń systemu sieciowego.
IOS – Internetwork Operating System – system operacyjny przełączników i routerów Cisco.
SU – Switched and In-Use – flaga oznaczająca poprawną pracę kanału L2 w systemie Cisco.
Trunk – łącze magistralne przenoszące ruch wielu sieci VLAN wg standardu IEEE 802.1Q.
LACP – Link Aggregation Control Protocol – protokół sterowania agregacją.

34/53
Przełamywanie ograniczeń LACP: technologie Multi-Chassis EtherChannel
Cel slajdu: Przedstawienie ograniczenia klasycznego LACP do jednego urządzenia fizycznego oraz koncepcji agregacji do dwóch odrębnych przełączników (M-LAG / vPC).

Ograniczenie klasycznego LACP do jednego węzła fizycznego

Klasyczny standard IEEE 802.1AX wymaga, aby wszystkie zagregowane kable kończyły się w jednym fizycznym urządzeniu:

  • Dylemat architektoniczny: jeśli przełącznik dostępu podłączymy wiązką LACP do jednego przełącznika dystrybucyjnego, zyskujemy sumowanie pasma, ale tworzymy pojedynczy punkt awarii (SPOF)! Jeśli podłączymy kable do dwóch odrębnych przełączników, klasyczny LACP nie zadziała, a STP zablokuje jedno z łączy.
  • Rozwiązanie inżynierskie (Multi-Chassis EtherChannel): wirtualizacja dwóch fizycznych przełączników dystrybucyjnych, tak aby z punktu widzenia protokołu LACP były widoczne jako jeden logiczny partner:
    • M-LAG (Multi-Chassis Link Aggregation Group): otwarty termin branżowy.
    • vPC (virtual PortChannel): technologia firmy Cisco stosowana w rodzinie Nexus.
    • StackWise Virtual / VSS: wirtualizacja przełączników kampusowych Catalyst.
Szczyt niezawodności: Multi-Chassis EtherChannel łączy zalety agregacji pasma LACP (100% przepustowości obu łączy) z pełną odpornością na awarię fizyczną całego przełącznika dystrybucyjnego!
Multi-Chassis Link Aggregation (M-LAG / vPC): Technologia wirtualizacji warstwy 2 umożliwiająca urządzeniu końcowemu lub przełącznikowi podrzędnemu zestawienie standardowej wiązki agregacyjnej LACP do dwóch odrębnych, fizycznie niezależnych przełączników nadrzędnych.
Przełamywanie ograniczeń LACP: technologie Multi-Chassis EtherChannel

W technologii M-LAG/vPC dwa niezależne przełączniki dystrybucyjne łączą się ze sobą dedykowanym łączem międzysystemowym (Inter-Switch Link / Peer-Link). Przez to łącze przełączniki synchronizują swoje tablice adresów MAC oraz koordynują komunikację protokołu LACP.

Dla przełącznika dostępowego oba urządzenia dystrybucyjne wyglądają jak jeden przełącznik z jednym wspólnym identyfikatorem LACP System ID, dzięki czemu nie ma żadnych przeszkód w zestawieniu standardowego, stabilnego kanału Port-Channel.

Skróty użyte w tym slajdzie:
M-LAG – Multi-Chassis Link Aggregation Group – wielourządzeniowa agregacja łączy.
vPC – virtual PortChannel – implementacja technologii M-LAG w przełącznikach Cisco Nexus.
SPOF – Single Point of Failure – pojedynczy punkt awarii.
VSS – Virtual Switching System – wirtualizacja krosowa przełączników kasetowych Cisco.
ISL – Inter-Switch Link – łącze synchronizujące stan dwóch przełączników w parze.

35/53
Korzyści z technologii M-LAG / vPC w kampusie
Cel slajdu: Podsumowanie zalet wdrożenia technologii M-LAG/vPC na styku warstwy dostępu i dystrybucji: 100% utylizacji pasma, bezprzerwowa konwergencja i eliminacja STP.

Active-Active Uplinks bez blokowania portów przez protokół STP

Wdrożenie technologii M-LAG/vPC na styku warstwy dostępu i dystrybucji przynosi fundamentalne korzyści:

  • 100% wykorzystanie pasma (Active-Active): oba łącza uplink z każdego przełącznika dostępowego przesyłają pakiety w sposób ciągły – podwojenie pasma dostępnego dla stacji roboczych.
  • Eliminacja blokowania portów przez STP: logiczna topologia staje się strukturą bezpętlową (drzewem punkt-punkt); STP pozostaje aktywny jedynie jako mechanizm zabezpieczający przed pomyłkami.
  • Subsekundowa konwergencja po awarii: awaria jednego przełącznika dystrybucyjnego lub kabla powoduje natychmiastowe przepakietowanie ruchu na drugie łącze przez sprzętowy mechanizm LACP (czas przełączenia < 50 ms).
  • Niezależność płaszczyzn sterowania (w M-LAG/vPC): każdy przełącznik dystrybucyjny posiada własny niezależny procesor i system operacyjny, co umożliwia bezprzerwową aktualizację oprogramowania (ISSU) węzeł po węźle.
Standard nowoczesnego kampusu: Połączenie przełączników dostępowych do dystrybucji za pomocą wiązek M-LAG/vPC jest wiodącym wzorcem projektowym w architekturach kampusowych klasy Enterprise.
Łącza Active-Active (Active-Active Uplinks): Architektura redundantnych połączeń sieciowych, w której wszystkie fizyczne łącza transmisyjne jednocześnie i bez przerwy uczestniczą w przesyłaniu ruchu danych użytkowników, eliminując zjawisko bezczynności łączy zapasowych.
Korzyści z technologii M-LAG / vPC w kampusie

W tradycyjnej sieci z STP i przełącznikami autonomicznymi, w razie awarii przełącznika dystrybucyjnego czas wykrycia problemu i odblokowania portu zapasowego wynosił od kilkuset milisekund do kilkudziesięciu sekund, zrywając aktywne sesje użytkowników.

W architekturze M-LAG przełącznik dostępowy po prostu rejestruje utratę jednego z fizycznych członków wiązki Port-Channel. Protokół LACP w ułamku sekundy aktualizuje maskę dystrybucji haszowania w układzie scalonym ASIC, a ruch natychmiast płynie wyłącznie przez drugie, wciąż aktywne łącze.

Skróty użyte w tym slajdzie:
M-LAG – Multi-Chassis Link Aggregation – technologia agregacji łączy fizycznych terminowanych na dwóch odrębnych przełącznikach.
vPC – Virtual Port Channel – zaimplementowana w platformach Cisco Nexus technologia wirtualizacji łączy agregacyjnych bez blokowania portów przez STP.
SVI – Switch Virtual Interface – logiczny interfejs routingu IP skojarzony z określoną siecią wirtualną VLAN.
SPOF – Single Point of Failure – pojedynczy punkt awarii, którego uszkodzenie paraliżuje działanie całego systemu.

36/53
Redundancja bramy domyślnej: problem stacji końcowej
Cel slajdu: Przedstawienie ograniczeń stosu sieciowego systemów operacyjnych urządzeń końcowych oraz problemu pojedynczej statycznej bramy domyślnej.

Ograniczenia stosu sieciowego systemów operacyjnych

Nawet najlepsza redundancja w warstwie 2 nie chroni przed awarią bramy w warstwie 3:

  • Statyczna brama domyślna: stacja robocza (Windows, Linux, macOS) posiada w konfiguracji IP wpisany dokładnie jeden adres IP bramy domyślnej (Default Gateway).
  • Scenariusz awaryjny: jeśli przełącznik dystrybucyjny pełniący rolę bramy ulegnie fizycznej awarii, stacja robocza traci łączność ze wszystkimi serwerami poza własną podsiecią i z Internetem!
  • Brak inteligencji stacji: komputery PC nie uczestniczą w protokołach routingu dynamicznego (OSPF, BGP) i nie potrafią samoczynnie przełączyć się na zapasowy adres IP drugiego przełącznika.
Konieczność rozwiązania: Potrzebny jest mechanizm warstwy sieciowej, który zaprezentuje dwa niezależne fizyczne przełączniki jako jedną, niezmienną i wirtualną bramę domyślną dla wszystkich hostów w podsieci.
Brama domyślna (Default Gateway): Węzeł sieciowy (router lub przełącznik warstwy 3), do którego stacja robocza wysyła pakiety zaadresowane do dowolnych innych podsieci, gdy adres docelowy znajduje się poza jej lokalną domeną rozgłoszeniową.
Redundancja bramy domyślnej: problem stacji końcowej

Stos protokołów TCP/IP w urządzeniach klienckich został celowo zaprojektowany jako prosty i niewymagający dużej mocy obliczeniowej. System operacyjny klienta sprawdza maskę podsieci: jeśli odbiorca jest w tej samej podsieci, wysyła zapytanie ARP o jego MAC. Jeśli odbiorca jest w innej sieci, wysyła pakiet na adres MAC bramy domyślnej.

Jeśli urządzenie pełniące rolę bramy zamilknie, stacja będzie bezskutecznie ponawiać próby transmisji, dopóki administrator nie zmieni ręcznie konfiguracji lub serwer DHCP nie odnowi dzierżawy.

Skróty użyte w tym slajdzie:
IP – Internet Protocol – podstawowy protokół warstwy sieciowej.
TCP/IP – Transmission Control Protocol / Internet Protocol – rodzina protokołów internetowych.
DHCP – Dynamic Host Configuration Protocol – protokół automatycznej konfiguracji sieci.
ARP – Address Resolution Protocol – protokół mapowania adresów IP na fizyczne MAC.
L3 – Layer 3 – warstwa sieciowa modelu OSI odpowiedzialna za routing.

37/53
Rodzina protokołów FHRP: idea wirtualnego IP i MAC
Cel slajdu: Przedstawienie ogólnej zasady działania protokołów First Hop Redundancy Protocol (FHRP) na podstawie wspólnego wirtualnego adresu IP oraz współdzielonego wirtualnego adresu MAC.

Współdzielona wirtualna brama domyślna dla urządzeń końcowych

Protokoły z rodziny FHRP (First Hop Redundancy Protocol) tworzą abstrakcję wirtualnego routera:

  • Wirtualny adres IP (VIP): stacje robocze otrzymują przez DHCP jako bramę domyślną adres VIP (np. 192.168.10.1), który nie jest przypisany na stałe do żadnego fizycznego portu.
  • Wirtualny adres MAC (VMAC): protokół generuje dedykowany adres sprzętowy wirtualnego routera (np. 0000.0c07.ac01 dla HSRP lub 0000.5e00.0101 dla VRRP).
  • Rola aktywna (Active / Master): jeden z przełączników odpowiada na zapytania ARP o VIP i przetwarza pakiety przesyłane na adres VMAC.
  • Rola zapasowa (Standby / Backup): drugi przełącznik stale nasłuchuje komunikatów keepalive; po zaniku sygnału od lidera przejmuje adres VMAC w czasie poniżej sekundy!
Przezroczystość dla klientów: Dzięki temu, że wirtualny adres MAC nie ulega zmianie podczas przełączenia, stacje robocze nie muszą odświeżać swojej pamięci podręcznej ARP – ruch natychmiast trafia do nowego urządzenia!
First Hop Redundancy Protocol (FHRP): Rodzina protokołów warstwy sieciowej (np. HSRP, VRRP, GLBP) umożliwiająca grupie fizycznych routerów lub przełączników L3 współdzielenie wspólnego adresu IP i MAC, gwarantując ciągłość routingu pierwszej bramy po awarii.
Rodzina protokołów FHRP: idea wirtualnego IP i MAC

Główną zaletą technologii FHRP jest zachowanie wirtualnego adresu MAC po przełączeniu awaryjnym (Failover). Gdyby przełącznik zapasowy przejął tylko adres IP, stacje klienckie nadal wysyłałyby ramki na stary, nieaktywny adres MAC dotychczasowego urządzenia, dopóki nie wygasłby ich lokalny cache ARP (co w systemie Windows trwa od 15 do 45 sekund).

Przejęcie tego samego adresu VMAC w połączeniu z wysłaniem bezwarunkowej ramki Gratuitous ARP (GARP) powoduje natychmiastowe przestawienie tablic przełączania na przełącznikach dostępowych bez wiedzy użytkowników.

Skróty użyte w tym slajdzie:
FHRP – First Hop Redundancy Protocol – rodzina protokołów redundancji pierwszej bramy.
VIP – Virtual IP Address – wirtualny adres IP współdzielony przez grupę bram.
VMAC – Virtual MAC Address – wirtualny adres sprzętowy bramy domyślnej.
GARP – Gratuitous ARP – niezamówiona rozgłoszeniowa odpowiedź ARP aktualizująca tablice MAC w sieci.
Failover – automatyczne przejęcie funkcji przez urządzenie rezerwowe.

38/53
Protokół HSRP (Hot Standby Router Protocol)
Cel slajdu: Przedstawienie mechaniki działania własnościowego protokołu Cisco HSRP (wersje v1 i v2), timerów keepalive oraz procesu wyboru routera Active.

Własnościowy standard redundancji bramy firmy Cisco

Protokół HSRP (IETF RFC 2281: Cisco Hot Standby Router Protocol (HSRP), Cisco Systems) definiuje reguły pracy pary bram:

  • Komunikaty Hello: routery wymieniają pakiety Hello co 3 sekundy (Hold Time = 10 s) na adres multiemisji 224.0.0.2 (v1) lub 224.0.0.102 (v2, port UDP 1985).
  • Wirtualne adresy MAC (VMAC): w HSRPv1 wirtualny adres MAC przyjmuje postać 00:00:0c:07:ac:XX (gdzie XX to szesnastkowy numer grupy od 0 do 255), natomiast w HSRPv2 wirtualny MAC to 00:00:0c:9f:fX:XX (gdzie XXX to numer grupy od 0 do 4095).
  • Kryterium elekcji routera Active: urządzenie o najwyższym priorytecie (zakres 0–255, domyślnie 100). W przypadku równego priorytetu decyduje wyższy skonfigurowany fizyczny adres IP.
  • Stany pracy routera w HSRP: Initial → Learn → Listen → Speak → Standby → Active.
Kluczowy mechanizm Preempt: Domyślnie w HSRP router o wyższym priorytecie NIE przejmie roli Active, jeśli inne urządzenie już pełni tę funkcję! Aby przywrócić rolę lidera po restarcie przełącznika nadrzędnego, wymagane jest jawne włączenie polecenia standby preempt.
Hot Standby Router Protocol (HSRP): Własnościowy protokół odporności pierwszej bramy firmy Cisco, umożliwiający automatyczne przełączenie obsługi ruchu IP stacji roboczych z routera aktywnego (Active) na zapasowy (Standby) po awarii łącza lub węzła.
Protokół HSRP (Hot Standby Router Protocol)

W protokole HSRP tylko router Active odpowiada na zapytania ARP o wirtualny adres IP i zajmuje się forwardowaniem pakietów. Router Standby pozostaje w trybie biernego oczekiwania, odbierając okresowe pakiety Hello.

Jeśli router Standby nie otrzyma pakietu Hello przez czas określony parametrem Hold Time (domyślnie 10 sekund), natychmiast uznaje router Active za martwy, przejmuje rolę Active i wysyła ramkę Gratuitous ARP, aby skierować strumień ruchu z przełączników warstwy dostępu na swoje porty.

Skróty użyte w tym slajdzie:
HSRP – Hot Standby Router Protocol – własnościowy protokół redundancji bramy Cisco.
VIP – Virtual IP Address – wirtualny adres bramy domyślnej.
Hold Time – czas oczekiwania na pakiet Hello przed uznaniem awarii bramy aktywnej.
Preempt – mechanizm wymuszający przejęcie roli aktywnej przez węzeł o wyższym priorytecie.
UDP – User Datagram Protocol – protokół warstwy transportowej (port 1985 dla HSRP).

39/53
Konfiguracja HSRP na przełącznikach dystrybucyjnych
Cel slajdu: Przedstawienie wzorcowej konfiguracji HSRPv2 na interfejsach wirtualnych SVI w systemie Cisco IOS wraz z mechanizmem Preempt.

Implementacja na wirtualnych interfejsach przełącznika SVI w Cisco IOS

Wzorcowa konfiguracja HSRPv2 na parze przełączników warstwy dystrybucji dla sieci VLAN 10:

! Konfiguracja na przełączniku Dist-01 (Brama Główna):
Switch-Dist1(config)# interface Vlan 10
Switch-Dist1(config-if)# ip address 192.168.10.2 255.255.255.0
Switch-Dist1(config-if)# standby version 2
Switch-Dist1(config-if)# standby 10 ip 192.168.10.1
Switch-Dist1(config-if)# standby 10 priority 110
Switch-Dist1(config-if)# standby 10 preempt delay minimum 30

! Konfiguracja na przełączniku Dist-02 (Brama Zapasowa):
Switch-Dist2(config)# interface Vlan 10
Switch-Dist2(config-if)# ip address 192.168.10.3 255.255.255.0
Switch-Dist2(config-if)# standby version 2
Switch-Dist2(config-if)# standby 10 ip 192.168.10.1
Switch-Dist2(config-if)# standby 10 priority 100
Inżynierski parametr Preempt Delay: Opcja standby 10 preempt delay minimum 30 nakazuje przełącznikowi Dist-01 odczekanie 30 sekund po restarcie przed odebraniem roli Active. Pozwala to na pełne przeliczenie tablic routingu OSPF i zapobiega gubieniu pakietów!
Interfejs wirtualny SVI (Switched Virtual Interface): Logiczny interfejs warstwy 3 skojarzony z określoną siecią VLAN na przełączniku wielowarstwowym, pełniący funkcję bramy domyślnej i punktu routingu pomiędzy różnymi podsieciami w kampusie.
Konfiguracja HSRP na przełącznikach dystrybucyjnych

Zastosowanie parametru preempt delay jest krytycznym elementem profesjonalnego projektu sieci. Po restarcie przełącznik podnosi swoje interfejsy fizyczne w ciągu kilkunastu sekund, ale protokoły routingu dynamicznego (OSPF/BGP) potrzebują dodatkowego czasu na zestawienie sąsiedztwa i pobranie pełnej tablicy tras.

Bez opóźnienia preempt router natychmiast przejąłby ruch użytkowników, po czym odrzuciłby go z powodu braku wpisów w tablicy routingu (zjawisko Blackholingu).

Skróty użyte w tym slajdzie:
SVI – Switched Virtual Interface – logiczny interfejs routowalny sieci VLAN.
HSRP – Hot Standby Router Protocol – protokół redundancji bramy.
Preempt Delay – opóźnienie wymuszonego przejęcia roli Active po restarcie urządzenia.
OSPF – Open Shortest Path First – protokół dynamicznego routingu stanu łącza.
Blackholing – ciche odrzucanie pakietów przez węzeł sieciowy z powodu braku tras.

40/53
Otwarty protokół VRRP (RFC 5798): standard branżowy
Cel slajdu: Przedstawienie architektury otwartego międzynarodowego protokołu VRRPv3 wg RFC 5798, różnic terminologicznych oraz obsługi IPv4 i IPv6.

Wieloplatformowa redundancja pierwszej bramy wg standardu IETF

Standard IETF RFC 5798: VRRPv3 for IPv4 and IPv6 definiuje otwarty protokół VRRPv3 (Virtual Router Redundancy Protocol):

  • Równoważna terminologia: router Master (odpowiednik Active w HSRP) oraz routery Backup (odpowiednik Standby).
  • Cykliczne rozgłoszenia: Master wysyła ramki VRRP Advertisement co 1 sekundę (domyślnie) na adres multiemisji 224.0.0.18 (IPv4) lub FF02::12 (IPv6). Czas reakcji na awarię: 3 × 1 s + Skew Time ≈ 3,6 s.
  • Wirtualny adres MAC (VMAC): w otwartym standardzie VRRPv3 wirtualny MAC dla IPv4 to 00:00:5e:00:01:XX (gdzie XX to numer grupy VRID od 1 do 255), a dla IPv6 to 00:00:5e:00:02:XX.
  • Preemption domyślnie włączone: w VRRP mechanizm Preempt jest aktywowany fabrycznie – router o wyższym priorytecie natychmiast przejmuje rolę Mastera!
Zaleta standaryzacji: VRRP jest jedynym protokołem FHRP umożliwiającym zestawienie redundancji bramy pomiędzy urządzeniami różnych producentów (np. para przełączników: Cisco + Juniper lub Aruba + Huawei).
Standard VRRP (Virtual Router Redundancy Protocol): Otwarty międzynarodowy protokół internetowy zdefiniowany przez IETF w dokumencie RFC 5798, służący do automatycznego wyznaczania routera Master odpowiedzialnego za przekazywanie pakietów wysyłanych na współdzielony wirtualny adres IP.
Otwarty protokół VRRP (RFC 5798): standard branżowy

Standard VRRPv3 ujednolicił obsługę protokołów IPv4 oraz IPv6 w ramach jednego mechanizmu protokołowego. Dodatkowo VRRP pozwala na wykorzystanie realnego fizycznego adresu interfejsu jednego z routerów jako wirtualnego adresu IP (wówczas priorytet tego routera jest na stałe ustawiany na 255 i staje się on IP Address Ownerem).

W praktyce inżynierskiej zaleca się jednak wydzielenie osobnego adresu VIP spoza puli adresów fizycznych urządzeń, co zapewnia pełną elastyczność przy wymianie sprzętu.

Skróty użyte w tym slajdzie:
VRRP – Virtual Router Redundancy Protocol – standardowy protokół redundancji routerów (RFC 5798).
VRID – Virtual Router Identifier – identyfikator wirtualnej grupy routerów (1–255).
IETF – Internet Engineering Task Force – organizacja standaryzująca protokoły internetowe.
Master / Backup – role routerów w protokole VRRP.
Skew Time – niewielkie opóźnienie w VRRP zapobiegające jednoczesnemu przejmowaniu roli Mastera.

41/53
Porównanie protokołów: HSRP vs VRRP
Cel slajdu: Szczegółowe zestawienie parametrów technicznych i operacyjnych protokołów HSRPv2 i VRRPv3.

Zestawienie cech technicznych protokołów pierwszej bramy

Porównanie właściwości protokołów redundancji bramy warstwy 3:

CechaHSRPv2 (Cisco Systems)VRRPv3 (IETF RFC 5798)
StandardWłasnościowy CiscoOtwarty międzynarodowy standard
Role routerówActive, Standby, ListenMaster, Backup
Adres multiemisji224.0.0.102 (UDP 1985)224.0.0.18 (IP protokół 112)
Format adresu VMAC0000.0c9f.fXXX00-00-5E-00-01-XX (IPv4)
Domyślne timeryHello: 3 s, Hold: 10 sAdv: 1 s, Master Down: ~3,6 s
Mechanizm PreemptDomyślnie wyłączone (wymaga komendy standby preempt)Domyślnie włączone (router o wyższym priorytecie natychmiast przejmuje rolę Master)
WieloproducentowośćBrak (tylko Cisco)Pełna interoperacyjność
Inżynierski wybór: W jednolitym środowisku Cisco stosuje się najczęściej HSRPv2 ze względu na bogate opcje śledzenia obiektów. W środowiskach mieszanych (Multi-Vendor) bezwzględnym standardem jest VRRPv3.
Interoperacyjność protokołów FHRP: Zdolność do zestawienia stabilnej i w pełni funkcjonalnej relacji redundancji pierwszej bramy pomiędzy urządzeniami sieciowymi pochodzącymi od różnych producentów sprzętu zgodnie ze standardem RFC 5798.
Porównanie protokołów: HSRP vs VRRP

Warto zwrócić uwagę na sposób enkapsulacji pakietów kontrolnych: HSRP wykorzystuje protokół warstwy transportowej UDP na porcie 1985, natomiast VRRP posiada własny numer protokołu IP (protokół 112), co oznacza, że nagłówek VRRP znajduje się bezpośrednio za nagłówkiem IP.

Zarówno HSRPv2, jak i VRRPv3 obsługują subsekundowe timery (milisekundowe), umożliwiając skrócenie czasu detekcji awarii do kilkuset milisekund bez przeciążania procesorów nowoczesnych przełączników.

Skróty użyte w tym slajdzie:
HSRP – Hot Standby Router Protocol – protokół Cisco.
VRRP – Virtual Router Redundancy Protocol – otwarty standard IETF.
Adv – Advertisement – pakiet rozgłoszeniowy routera Master w VRRP.
UDP – User Datagram Protocol – protokół transportowy używany przez HSRP.
Multi-Vendor – środowisko sieciowe zbudowane ze sprzętu wielu różnych producentów.

42/53
Równoważenie obciążenia w FHRP za pomocą wielu grup
Cel slajdu: Przedstawienie metodyki podziału ruchu Active-Active w warstwie 3 poprzez konfigurację wielu grup HSRP/VRRP (Multi-Group FHRP) w powiązaniu z sieciami VLAN.

Ruch Active-Active w warstwie 3 (Multi-Group HSRP / VRRP)

Klasyczny HSRP/VRRP działa w trybie Active-Standby (jeden przełącznik przetwarza ruch, drugi czeka bezczynnie). W celu pełnego wykorzystania obu urządzeń stosuje się model Multi-Group:

  • Podział ról pomiędzy sieciami VLAN:
    • Dla VLAN 10 (Studenci): Przełącznik Dist-01 jest Active (Priorytet 110), a Dist-02 jest Standby (Priorytet 100).
    • Dla VLAN 20 (Pracownicy): Przełącznik Dist-02 jest Active (Priorytet 110), a Dist-01 jest Standby (Priorytet 100).
  • Rozkład obciążenia procesorów: pakiety z VLAN 10 routuje sprzętowo procesor Dist-01, a pakiety z VLAN 20 procesor Dist-02 – oba przełączniki pracują jednocześnie!
  • Korelacja z topologią STP: przełącznik pełniący rolę Active HSRP dla danego VLAN-u musi być jednocześnie mostem głównym (Root Bridge) dla tego samego VLAN-u!
Kardynalna reguła optymalizacji: Rozbieżność pomiędzy Root Bridge STP a Active Routerem HSRP zmusza pakiety do niepotrzebnego krążenia przez łącze międzysystemowe ISL, marnując przepustowość magistrali i zwiększając opóźnienia!
Korelacja STP-FHRP: Inżynierska zasada projektowa nakazująca skonfigurowanie tej samej fizycznej maszyny jako mostu głównego (Root Bridge) w warstwie 2 oraz routera aktywnego (Active Router) w warstwie 3 dla danej wirtualnej sieci lokalnej.

Niezsynchronizowanie konfiguracji STP z FHRP jest jednym z najpowszechniejszych błędów wykonawczych. Jeśli Przełącznik 1 jest Root Bridge dla VLAN 10, stacja robocza przesyła ramkę bezpośrednio do niego. Jeśli jednak routerem Active HSRP dla tego VLAN-u jest Przełącznik 2, Przełącznik 1 musi przesłać ramkę przez łącze ISL do Przełącznika 2 w celu zroutowania.

Powstaje wówczas tzw. „efekt bumerangu”, który niepotrzebnie podwaja zużycie pasma na łączu łączącym przełączniki dystrybucyjne.

Skróty użyte w tym slajdzie:
FHRP – First Hop Redundancy Protocol – protokoły redundancji bramy.
STP – Spanning Tree Protocol – protokół drzewa rozpinającego.
ISL – Inter-Switch Link – łącze tranzytowe pomiędzy przełącznikami dystrybucyjnymi.
VLAN – Virtual Local Area Network – wirtualna sieć lokalna.
Load Balancing – równomierny podział obciążenia ruchem sieciowym.

43/53
Śledzenie łączy nadrzędnych: mechanizm Object Tracking
Cel slajdu: Przedstawienie problemu czarnej dziury transmisyjnej po awarii łącza nadrzędnego (Uplink) oraz rozwiązania za pomocą mechanizmu Object Tracking w HSRP/VRRP.

Automatyczna reakcja bramy na awarię łączy w stronę rdzenia

Co się stanie, gdy przełącznik dystrybucyjny Active utraci połączenie z rdzeniem sieci kampusu?

  • Zjawisko „Czarnej Dziury” (Black Hole): przełącznik nadal sprawnie odbiera pakiety z warstwy dostępu na interfejsie SVI, ale nie ma jak przesłać ich dalej w stronę Internetu – cały ruch użytkowników jest bezpowrotnie gubiony!
  • Rozwiązanie: Mechanizm Object Tracking:
    • Proces FHRP monitoruje stan łącza nadrzędnego (np. interfejsu optycznego w stronę rdzenia lub sesji OSPF).
    • W razie awarii uplink-u przełącznik automatycznie obniża swój priorytet HSRP (np. ze 110 o 20 punktów, do poziomu 90).
    • Router zapasowy Standby (o priorytecie 100) dzięki funkcji Preempt natychmiast przejmuje rolę Active i przejmuje ruch!
Wymóg projektowy: Każda konfiguracja HSRP/VRRP w warstwie dystrybucji musi posiadać skonfigurowany mechanizm śledzenia łączy uplinkowych (np. track 1 interface TenGigabitEthernet 1/1/1 line-protocol).
Object Tracking: Zaawansowany mechanizm monitorowania stanu obiektów sieciowych (stan łącza fizycznego, trasa w tablicy routingu, poziom opóźnień IP SLA), powiązany z procesem FHRP w celu dynamicznej modyfikacji priorytetu bramy.

Bez mechanizmu Object Tracking protokół HSRP jest całkowicie ślepy na to, co dzieje się za plecami przełącznika. Dopóki interfejs VLAN 10 w stronę użytkowników jest podniesiony, przełącznik uważa się za w pełni sprawnego lidera, nawet jeśli wszystkie jego wyjścia do świata zewnętrznego zostały przecięte.

Dopiero powiązanie grupy HSRP z obiektem śledzącym (Tracked Object) gwarantuje spójną, całościową ocenę zdatności węzła do pełnienia funkcji bramy tranzytowej.

Skróty użyte w tym slajdzie:
Object Tracking – mechanizm monitorowania stanu obiektów sieciowych w przełącznikach.
HSRP – Hot Standby Router Protocol – protokół redundancji bramy domyślnej.
Uplink – łącze nadrzędne w stronę warstwy rdzenia kampusu.
SLA – Service Level Agreement – zdefiniowane parametry jakościowe transmisji.
IP SLA – funkcja aktywnego badania parametrów łączy IP przez testowe pakiety syntetyczne.

44/53
Protokół GLBP (Gateway Load Balancing Protocol)
Cel slajdu: Przedstawienie założeń protokołu Cisco GLBP, automatycznego równoważenia obciążenia stacji roboczych w ramach jednej podsieci za pomocą AVG i AVF.

Automatyczne równoważenie obciążenia w ramach jednej podsieci

Protokół GLBP (Gateway Load Balancing Protocol, Cisco) rozwiązuje problem pojedynczej grupy:

  • Jeden wirtualny adres IP, wiele wirtualnych adresów MAC: wszystkie stacje w danym VLAN-ie posiadają wpisany identyczny adres bramy VIP (np. 192.168.1.1).
  • Aktywny koordynator (Active Virtual Gateway – AVG): jeden z routerów odbiera wszystkie zapytania ARP o VIP i odpowiada na nie naprzemiennie, przydzielając różne wirtualne adresy MAC należące do poszczególnych routerów!
  • Aktywni wykonawcy (Active Virtual Forwarders – AVF): do czterech routerów w grupie równolegle przetwarza pakiety przesyłane na ich unikalne adresy VMAC.
  • Algorytmy dystrybucji: Round-Robin (karuzelowy), Host-Dependent (stałe powiązanie klienta) lub Weighted (proporcjonalnie do wydajności przełączników).
Ograniczenie GLBP: GLBP jest rozwiązaniem własnościowym Cisco i nie jest wspierany w nowszych przełącznikach Nexus oraz w architekturach zorientowanych na otwarty routing L3. W nowoczesnych kampusach preferuje się Routed Access lub Anycast Gateway.
Gateway Load Balancing Protocol (GLBP): Własnościowy protokół firmy Cisco automatycznie równoważący obciążenie ruchem pomiędzy grupę do czterech aktywnych bram domyślnych w ramach jednej podsieci IP poprzez dynamiczne różnicowanie odpowiedzi na zapytania ARP.

W protokole GLBP użytkownik nie musi konfigurować wielu grup ani dzielić VLAN-ów, aby wykorzystać oba łącza. Komputer A otrzymuje w odpowiedzi ARP adres MAC Routera 1, a stojący obok Komputer B w tej samej sali otrzymuje adres MAC Routera 2.

Mimo ogromnej elegancji tego rozwiązania, protokół GLBP generuje trudności diagnostyczne (różne stacje w tej samej podsieci korzystają z różnych ścieżek) i z tego względu w nowoczesnych projektach ustępuje miejsca architekturze w całości opartej na routingu warstwy 3.

Skróty użyte w tym slajdzie:
GLBP – Gateway Load Balancing Protocol – protokół równoważenia obciążenia bramy.
AVG – Active Virtual Gateway – główny router koordynujący przydział adresów MAC w GLBP.
AVF – Active Virtual Forwarder – router realizujący faktyczne przekazywanie ruchu w GLBP.
ARP – Address Resolution Protocol – protokół zapytań o adres fizyczny MAC.
VIP – Virtual IP Address – wspólny adres wirtualny bramy domyślnej.

45/53
Podejście Routed Access vs L2 Access w kampusie
Cel slajdu: Porównanie tradycyjnej architektury L2 Access z nowoczesnym podejściem Routed Access (L3 Access) oraz analiza eliminacji pętli L2.

Przeniesienie granicy routingu bezpośrednio do szafy dostępowej

Współczesna inżynieria kampusowa odchodzi od rozciągania warstwy 2 na rzecz routingu na brzegu sieci:

  • Tradycyjny L2 Access: przełączniki dostępowe pracują wyłącznie w warstwie 2; sieci VLAN są rozciągnięte przez łącza Trunk do dystrybucji; wymaga stosowania STP, LACP i FHRP.
  • Nowoczesny Routed Access (L3 Access):
    • Granica routingu L3 zostaje przeniesiona bezpośrednio na przełącznik dostępowy w szafie piętrowej.
    • Łącza do dystrybucji stają się łączami routowanymi (interfejsy no switchport z adresacją /30 lub /31).
    • Sieć VLAN kończy się lokalnie w szafie dostępowej – brak jakichkolwiek pętli w warstwie 2!
  • Zalety Routed Access: całkowita eliminacja protokołów STP i FHRP, konwergencja subsekundowa oparta na protokole OSPF/EIGRP oraz sprzętowy Load Balancing ECMP na łączach uplink!
Architektoniczny przełom: W architekturze Routed Access problem pętli L2 i blokowania portów po prostu przestaje istnieć, ponieważ między dostępem a dystrybucją nie ma żadnych ramek warstwy 2!
Architektura Routed Access (L3 Access): Wzorzec projektowy sieci kampusowej, w którym funkcje routingu warstwy 3 oraz granice podsieci IP zostają przesunięte bezpośrednio na przełączniki warstwy dostępu, eliminując rozciąganie domen L2 przez sieć szkieletową.

Wdrożenie architektury Routed Access stało się możliwe dzięki spadkowi cen przełączników warstwy 3 (Multilayer Switches) z obsługą routingu sprzętowego ASIC na poziomie warstwy dostępu. Tradycyjne wady przełączania L2 – takie jak burze rozgłoszeniowe i powolna konwergencja STP – zostają definitywnie wyeliminowane.

Równoważenie obciążenia realizowane jest przez protokół OSPF za pomocą mechanizmu Equal-Cost Multi-Path (ECMP), co oznacza, że oba łącza optyczne z szafy piętrowej są aktywnie wykorzystywane w 100% z subsekundowym czasem przełączenia.

Skróty użyte w tym slajdzie:
ECMP – Equal-Cost Multi-Path – równoważenie obciążenia na trasach o jednakowym koszcie L3.
L2 Access – tradycyjna warstwa dostępu operująca wyłącznie na ramkach warstwy 2.
L3 Access – warstwa dostępu realizująca routing pakietów warstwy 3 bezpośrednio w szafie.
OSPF – Open Shortest Path First – dynamiczny protokół routingu wewnętrznego stanu łącza.
Trunk – łącze magistralne 802.1Q eliminowane w architekturze Routed Access.

46/53
Szybka detekcja awarii w warstwie 3: protokół BFD
Cel slajdu: Przedstawienie mechanizmu BFD (RFC 5880), subsekundowej detekcji awarii łączy dwukierunkowych oraz integracji z protokołami OSPF i BGP.

Subsekundowa konwergencja routingu wg standardu RFC 5880

Standard IETF RFC 5880: Bidirectional Forwarding Detection (BFD) definiuje protokół BFD:

  • Ograniczenie tradycyjnych protokołów routingu: protokoły OSPF czy BGP wymieniają pakiety Hello co 1–10 sekund; wykrycie awarii pośredniego urządzenia transmisyjnego (np. konwertera mediów) zajmuje od 3 do 40 sekund (Dead Interval)!
  • Zasada działania BFD: ultrakompaktowe ramki kontrolne wysyłane w sprzęcie (Hardware-Offloaded) co 50 milisekund!
  • Czas reakcji: brak 3 kolejnych ramek BFD (150 ms) oznacza natychmiastowe stwierdzenie awarii toru transmisyjnego.
  • Współpraca z protokołami routingu: BFD natychmiast powiadamia proces OSPF lub BGP, wymuszając natychmiastowe usunięcie wadliwej trasy z tablicy FIB bez czekania na wygaśnięcie timerów routingu.
Subsekundowy Failover: Połączenie routingu OSPF z mechanizmem BFD redukuje czas konwergencji sieci kampusowej po awarii kabla do poziomu poniżej 200 milisekund!
Bidirectional Forwarding Detection (BFD): Niskonarzutowy, niezależny od medium i protokołów protokół sieciowy zdefiniowany w RFC 5880, przeznaczony do błyskawicznego wykrywania uszkodzeń ścieżek transmisyjnych pomiędzy sąsiednimi routerami w czasie liczonym w milisekundach.

W łączach optycznych bezpośrednich utrata sygnału świetlnego (Loss of Signal – LoS) powoduje natychmiastowe wyłączenie portu fizycznego. Jeśli jednak pomiędzy przełącznikami znajduje się sieć DWDM, regenerator lub konwerter mediów, awaria wewnątrz toru operatora nie powoduje wyłączenia portu lokalnego (stan portu pozostaje Up/Up).

W takiej sytuacji jedynym sposobem na błyskawiczne wykrycie przerwy w ciągłości transmisji jest aktywna wymiana pakietów BFD na poziomie mikrosekundowym, realizowana bezpośrednio w procesorach sprzętowych kart liniowych.

Skróty użyte w tym slajdzie:
BFD – Bidirectional Forwarding Detection – protokół szybkiej, niskonarzutowej detekcji awarii łączy dwukierunkowych wg RFC 5880.
FHRP – First Hop Redundancy Protocol – rodzina protokołów zapewniających wysoką dostępność domyślnej bramy dla stacji końcowych.
OSPF – Open Shortest Path First – hierarchiczny protokół routingu stanu łącza stosowany w szkieletach sieci kampusowych.
IGP – Interior Gateway Protocol – kategoria protokołów trasowania pakietów wewnątrz pojedynczego systemu autonomicznego (AS).

47/53
Niezawodność infrastruktury zasilania w kampusie
Cel slajdu: Przedstawienie inżynierskich zasad projektowania redundancji zasilania szaf teletechnicznych w architekturze 2N (Tory A i B, agregaty, ATS).

Fizyczny fundament ciągłości działania urządzeń teleinformatycznych

Zasilanie gwarantowane stanowi fizyczny fundament wysokiej dostępności:

  • Architektura zasilania dwutorowego 2N (Tor A + Tor B):
    • Tor A: zasilany z Rozdzielnicy Głównej 1 → UPS A → Listwa PDU A w szafie RACK.
    • Tor B: zasilany z Rozdzielnicy Głównej 2 → Agregat → UPS B → Listwa PDU B w szafie RACK.
  • Podłączenie urządzeń IT: każdy przełącznik rdzeniowy i dystrybucyjny posiada dwa zasilacze (PSU 1 podłączony do PDU A, PSU 2 do PDU B).
  • Przełączniki samoczynnego załączenia rezerwy (ATS / SZR): dla urządzeń posiadających tylko jeden zasilacz (np. niektóre routery brzegowe lub kontrolery IoT) stosuje się montowane w szafie szybkie przełączniki statyczne STS/ATS (czas przełączenia < 10 ms).
Przeglądy baterii: Zasilacz UPS bez sprawnych akumulatorów daje złudne poczucie bezpieczeństwa. Norma wymaga cyklicznych testów pojemnościowych baterii co 6–12 miesięcy oraz ich prewencyjnej wymiany po 3–5 latach eksploatacji.
Architektura zasilania 2N: Wzorzec projektowy elektroenergetyki gwarantowanej, w którym zainstalowano dwa w pełni niezależne tory zasilania od źródeł po listwy odbiorcze w szafach, gdzie każdy tor jest zdolny do samodzielnego zasilenia 100% obciążenia IT.

Wielu administratorów popełnia błąd, podłączając oba kable zasilające z podwójnego zasilacza przełącznika do tej samej listwy zasilającej lub do tego samego obwodu bezpiecznikowego. Zadziałanie pojedynczego wyłącznika nadprądowego wyłącza wówczas całe urządzenie, niwecząc kosztowną redundancję sprzętową.

Dopiero pełne rozdzielenie torów zasilających (Tor A z UPS-1, Tor B z UPS-2 lub z sieci miejskiej z agregatem) gwarantuje, że prace serwisowe przy rozdzielnicach elektrycznych nie wpłyną na ciągłość pracy sieci.

Skróty użyte w tym slajdzie:
2N – pełna redundancja dwutorowa (dwa niezależne kompletne systemy zasilania).
ATS / SZR – Automatic Transfer Switch / Samoczynne Załączenie Rezerwy.
STS – Static Transfer Switch – szybki elektroniczny przełącznik źródeł zasilania.
PDU – Power Distribution Unit – listwa dystrybucji zasilania w szafie RACK.
UPS – Uninterruptible Power Supply – zasilacz bezprzerwowy.

48/53
Bezprzerwowa aktualizacja oprogramowania: mechanizmy ISSU
Cel slajdu: Przedstawienie procedur bezprzerwowej aktualizacji oprogramowania (ISSU) w przełącznikach kampusowych bez konieczności planowania okien serwisowych i przestojów.

Konserwacja urządzeń aktywnych bez przestoju sieci

Wysoka dostępność musi być zachowana również podczas planowych prac serwisowych:

  • Wyzwanie tradycyjnych aktualizacji: wgranie nowej wersji systemu operacyjnego (firmware) wymagało restartu przełącznika i przestoju sieci na 10–20 minut, wymuszając nocne okna serwisowe.
  • Mechanizm ISSU (In-Service Software Upgrade):
    • Na przełącznikach kasetowych z dwoma procesorami (Dual Supervisor): w pierwszej kolejności aktualizowany i restartowany jest Supervisor zapasowy (Standby).
    • Po podniesieniu nowego systemu następuje stanowe przełączenie kontroli (SSO); nowy Supervisor przejmuje zarządzanie, a procesy routingu kontynuują pracę w technologii NSF!
    • Następnie aktualizowany jest drugi Supervisor oraz oprogramowanie kart liniowych – przełącznik ani na sekundę nie przerywa przekazywania ruchu!
  • ISSU w klastrach M-LAG/vPC: aktualizacja naprzemienna węzeł po węźle; cały ruch automatycznie przejmuje drugi przełącznik w parze.
Korzyść biznesowa: Wdrożenie technologii ISSU eliminuje konieczność organizowania nocnych okien serwisowych i pozwala na bieżące instalowanie poprawek bezpieczeństwa w godzinach pracy organizacji.
In-Service Software Upgrade (ISSU): Zaawansowana funkcja oprogramowania przełączników sieciowych umożliwiająca aktualizację systemu operacyjnego urządzenia lub klastra w trakcie jego normalnej pracy bez zakłócania ruchu w płaszczyźnie danych.

Procedura ISSU wymaga ścisłej koordynacji pomiędzy wersjami oprogramowania (zob. Cisco Catalyst 9600 High Availability and ISSU Configuration Guide). Producenci publikują tzw. macierze zgodności ISSU (ISSU Compatibility Matrix), określające, pomiędzy którymi wersjami systemu możliwa jest migracja bezprzerwowa.

W przypadku konieczności wykonania skoku o kilka wydań systemowych (np. aktualizacja o trzy wersje główne w górę), migrację należy przeprowadzić wieloetapowo, aby zachować zgodność struktur pamięci dzielonej pomiędzy starym a nowym procesorem sterującym.

Skróty użyte w tym slajdzie:
ISSU – In-Service Software Upgrade – bezprzerwowa aktualizacja oprogramowania.
SSO – Stateful Switchover – stanowe przełączenie procesorów w czasie rzeczywistym.
NSF – Non-Stop Forwarding – bezprzerwowe przekazywanie pakietów podczas restartu procesów routingu.
M-LAG – Multi-Chassis Link Aggregation Group – klaster agregacyjny dwóch przełączników.
Firmware – wbudowane oprogramowanie układowe urządzeń sieciowych.

49/53
Wymiarowanie przepustowości łączy zapasowych i nadsubskrypcja
Cel slajdu: Przedstawienie zasad inżynierskiego wymiarowania przepustowości magistrali kampusowych w scenariuszu awaryjnym (Failover) oraz kontroli współczynnika nadsubskrypcji.

Zachowanie sieci w scenariuszu awaryjnym (Failover Capacity Planning)

Inżynier projektant musi przeanalizować bilans pasma po wystąpieniu awarii:

  • Ruch w stanie normalnym: ruch z 10 przełączników dostępowych jest równomiernie rozłożony: 50% płynie do Dystrybucji 1, a 50% do Dystrybucji 2. Każde łącze jest obciążone w 40–50%.
  • Scenariusz awarii (Failover): w przypadku usterki Przełącznika Dystrybucji 1, 100% całego ruchu zostaje skierowane na Przełącznik Dystrybucji 2!
  • Współczynnik nadsubskrypcji w warunkach awaryjnych: jeśli łącza zapasowe były zaprojektowane „na styk”, po przełączeniu awaryjnym nastąpi ich natychmiastowe wysycenie do 100%, zrzucanie pakietów (Packet Drop) i degradacja usług.
  • Zasada N+1 dla pasma: suma pasma w normalnym stanie pracy węzła nie powinna przekraczać 50% pojemności pojedynczego toru zapasowego, gwarantując bezproblemowe przejęcie całego ruchu!
Inżynierski bufor: Sieć kampusowa wysokiej dostępności musi być przewymiarowana pasmowo w taki sposób, aby pojedyncza ocalała ścieżka była w stanie obsłużyć pełen szczytowy ruch bez utraty pakietów i wzrostu opóźnień (Jitter/Delay).
Pojemność awaryjna (Failover Capacity): Zdolność rezerwowych łączy transmisyjnych i urządzeń sieciowych do przejęcia i bezstratnego obsłużenia całego sumarycznego wolumenu ruchu generowanego przez użytkowników po awarii głównego toru transmisyjnego.

Częstym błędem projektowym jest wymiarowanie sieci na poziomie 80% utylizacji łączy w stanie normalnym. W momencie wystąpienia awarii jednego z przełączników dystrybucyjnych cały ruch trafia na drugie urządzenie, co wywołuje natychmiastowe przeciążenie (160% pojemności).

W rezultacie, mimo że protokoły HA zadziałały poprawnie i przełączyły ruch, użytkownicy tracą dostęp do usług z powodu masowego odrzucania ramek w przepełnionych kolejkach wyjściowych przełącznika.

Skróty użyte w tym slajdzie:
Failover – samoczynne przełączenie ruchu na tory rezerwowe po awarii.
Packet Drop – odrzucanie pakietów przez przełącznik w wyniku przepełnienia buforów portu.
Jitter – zmienność opóźnienia pakietów w czasie transmisji, krytyczna dla głosu i wideo.
N+1 – model redundancji z jednym zapasowym elementem dla grupy N komponentów.
QoS – Quality of Service – mechanizmy gwarancji jakości i priorytetyzacji ruchu.

50/53
Podsumowanie strategii projektowania wysokiej dostępności
Cel slajdu: Syntetyczne podsumowanie najważniejszych wytycznych projektowych w zakresie budowy bezawaryjnych i samonaprawiających się sieci kampusowych.

Kluczowe zasady inżynierskie odporności infrastruktury kampusowej

Podsumowanie najważniejszych wytycznych projektowych dotyczących wysokiej dostępności:

  • Eliminacja SPOF na każdym poziomie: brak pojedynczych punktów awarii w zasilaniu, trasach kablowych, szafach, przełącznikach i łączach operatorów.
  • Ochrona warstwy 2: stosowanie nowoczesnego protokołu RSTP lub MSTP wraz z obowiązkowymi mechanizmami ochronnymi na portach (BPDU Guard, Root Guard).
  • Agregacja łączy i M-LAG: dążenie do eliminacji blokowania portów na rzecz aktywnych wiązek LACP i technologii Multi-Chassis (Active-Active Uplinks).
  • Redundancja bramy domyślnej: wdrożenie protokołów FHRP (HSRPv2 lub otwartego VRRPv3) z synchronizacją parametrów STP oraz mechanizmem Object Tracking.
  • Ewolucja w stronę Routed Access: przenoszenie granicy routingu do warstwy dostępu w celu definitywnej eliminacji pętli L2 i skrócenia czasu konwergencji.
  • Planowanie pojemności: zachowanie 50% rezerwy pasma na łączach magistralnych pod kątem bezstratnego przejęcia ruchu po awarii (Failover).
Architektura samonaprawiająca się (Self-Healing Network): Zintegrowana koncepcja projektowa sieci teleinformatycznej, w której połączone mechanizmy redundancji sprzętowej, logicznej i protokołowej automatycznie wykrywają, izolują i omijają wszelkie awarie komponentów w czasie subsekundowym bez udziału człowieka.
Podsumowanie strategii projektowania wysokiej dostępności

Projektowanie wysokiej dostępności wymaga dyscypliny inżynierskiej i całościowego spojrzenia na infrastrukturę. Każdy dodany element redundancji musi być świadomie kontrolowany przez odpowiednie protokoły – w przeciwnym razie zapasowe kable staną się źródłem niszczących pętli transmisyjnych.

W kolejnej części cyklu połączymy mechanizmy wysokiej dostępności z zagadnieniami logicznej segmentacji sieci kampusowej na wirtualne sieci lokalne (VLAN) oraz zaawansowanymi technikami routingu między-VLAN-owego.

Skróty użyte w tym slajdzie:
HA – High Availability – wysoka dostępność systemów.
SPOF – Single Point of Failure – pojedynczy punkt awarii.
RSTP / MSTP – szybkie i wieloinstancyjne protokoły drzewa rozpinającego.
M-LAG – Multi-Chassis Link Aggregation Group – wielourządzeniowa agregacja łączy.
VRRP / HSRP – protokoły redundancji pierwszej bramy w warstwie 3.

51/53
Pytania i odpowiedzi
Cel slajdu: Sesja dyskusyjna podsumowująca zagadnienia niezawodności, optymalizacji timerów konwergencji oraz rozwiązywania problemów w warstwie 2 i 3.

Sesja dyskusyjna Q&A dotycząca wysokiej dostępności

Zapraszam do dyskusji na temat wysokiej dostępności i redundancji w kampusie:

  • Dobór timerów protokołów: kiedy warto skracać domyślne czasy w protokołach RSTP i VRRP do wartości milisekundowych, a kiedy grozi to fałszywymi alarmami?
  • M-LAG vs Routed Access: kryteria inżynierskiego wyboru pomiędzy rozciąganiem L2 z M-LAG a wdrożeniem czystego routingu L3 w szafie dostępowej.
  • Rozwiązywanie problemów (Troubleshooting): metodyka diagnozowania sporadycznych pętli rozgłoszeniowych i oscylacji tablic MAC w rozległych kampusach.
  • Koszty a wymagania SLA: jak uzasadnić inwestycję w redundancję 2N przed zarządem organizacji.
Praktyka inżynierska: Najlepszym poligonem doświadczalnym dla mechanizmów wysokiej dostępności są kontrolowane testy awaryjne przeprowadzane na etapie odbiorów technicznych – poprzez fizyczne wyciąganie kabli i zasilaczy pod pełnym obciążeniem sieci.
Testy awaryjne (Failover Testing): Procedura weryfikacji odbiorowej instalacji polegająca na celowym i kontrolowanym wywoływaniu awarii fizycznych komponentów (odłączanie zasilaczy, przecinanie łączy optycznych) w celu zmierzenia rzeczywistego czasu konwergencji i stabilności usług.
Pytania i odpowiedzi

W trakcie audytów i odbiorów technicznych nowo wybudowanej sieci kampusowej inżynier nie może polegać jedynie na deklaracjach wykonawcy. Konieczne jest przeprowadzenie rygorystycznych testów zrywających z wykorzystaniem generatora ruchu sieciowego i analizatora pakietów.

Zarejestrowanie liczby utraconych pakietów podczas symulowanej awarii przełącznika rdzeniowego pozwala na dokładne wyliczenie czasu przestoju w milisekundach i zweryfikowanie zgodności z zapisami umowy SLA.

Skróty użyte w tym slajdzie:
SLA – Service Level Agreement – gwarantowany w umowie poziom dostępności.
Q&A – Questions and Answers – sesja pytań i odpowiedzi.
Troubleshooting – systematyczne diagnozowanie i usuwanie usterek w sieci.
M-LAG – Multi-Chassis Link Aggregation Group – agregacja wielowęzłowa.
RSTP – Rapid Spanning Tree Protocol – szybkie drzewo rozpinające.

52/53
Zapowiedź kolejnej części
Cel slajdu: Wprowadzenie do tematyki Części 4 cyklu wykładów: segmentacji sieci kampusowej na wirtualne sieci LAN (VLAN), trunkingu oraz routingu między-VLAN-owego.

Część 4: Segmentacja sieci, wirtualizacja i routing w kampusie

Podczas następnego spotkania przeanalizujemy logiczną strukturę sieci kampusowej:

  • Koncepcja i implementacja wirtualnych sieci lokalnych (VLAN): izolacja domen rozgłoszeniowych i grup użytkowników wg normy IEEE 802.1Q.
  • Trunking magistralny: mechanizm tagowania ramek, pojęcie Native VLAN oraz najlepsze praktyki bezpieczeństwa portów magistralnych.
  • Routing między sieciami VLAN (Inter-VLAN Routing): od historycznego Router-on-a-Stick do przełączania wielowarstwowego z wykorzystaniem interfejsów SVI.
  • Wirtualizacja routingu (VRF-Lite): tworzenie wielu niezależnych wirtualnych tablic routingu na jednym fizycznym przełączniku rdzeniowym.
  • Inżynieria jakości usług (QoS): klasyfikacja i kolejkowanie ruchu (DiffServ, DSCP, CoS, LLQ) w celu ochrony transmisji krytycznych.
Segmentacja sieci (Network Segmentation): Podział fizycznej sieci teleinformatycznej na mniejsze, logicznie odseparowane strefy bezpieczeństwa i domeny rozgłoszeniowe (np. za pomocą sieci VLAN i instancji VRF) w celu podniesienia wydajności i ochrony zasobów.
Zapowiedź kolejnej części

Sama wysoka dostępność i redundancja to za mało, aby sieć kampusowa była bezpieczna i wydajna. Umieszczenie wszystkich stacji roboczych, serwerów, telefonów VoIP i kamer monitoringu w jednej płaskiej podsieci warstwy 2 doprowadziłoby do gigantycznego marnotrawstwa pasma i stworzyło krytyczne luki bezpieczeństwa.

W Części 4 dowiemy się, jak za pomocą sieci VLAN, tagowania 802.1Q oraz zaawansowanych mechanizmów routingu i polityk QoS stworzyć uporządkowaną, bezpieczną i skalowalną architekturę logiczną.

Skróty użyte w tym slajdzie:
VLAN – Virtual Local Area Network – wirtualna sieć lokalna (IEEE 802.1Q).
SVI – Switched Virtual Interface – interfejs wirtualny przełącznika warstwy 3.
VRF – Virtual Routing and Forwarding – wirtualizacja tablic routingu w routerze.
QoS – Quality of Service – inżynieria jakości usług i priorytetyzacja ruchu.
DSCP – Differentiated Services Code Point – 6-bitowe pole priorytetu w nagłówku IP.

53/53
Dziękuję za uwagę
Cel slajdu: Podsumowanie wykładu poświęconego wysokiej dostępności oraz zaproszenie do praktycznych ćwiczeń laboratoryjnych w środowiskach symulacyjnych.

Podsumowanie części 3 i zalecenia do ćwiczeń laboratoryjnych

Dziękuję za udział w części poświęconej projektowaniu wysokiej dostępności i redundancji w sieciach kampusowych.

Zachęcam do samodzielnego przećwiczenia omówionych scenariuszy konfiguracyjnych w środowiskach symulacyjnych i laboratoryjnych:

  • Konfiguracja protokołu RSTP oraz mechanizmów PortFast i BPDU Guard na przełącznikach dostępowych.
  • Zestawianie dynamicznych wiązek LACP (Mode Active) oraz weryfikacja algorytmów haszowania portów.
  • Wdrożenie pary przełączników dystrybucyjnych z protokołami HSRPv2 i VRRPv3 z mechanizmem Preempt i śledzeniem łączy Object Tracking.
  • Obserwacja czasów przełączenia ruchu transmisyjnego (sub-second failover) podczas symulowanych awarii łączy.
Wskazówka laboratoryjna: Podczas testowania przełączania awaryjnego warto uruchomić ciągłe wysyłanie pakietów ICMP (polecenie ping -t) z krótkim interwałem, aby precyzyjnie policzyć liczbę zgubionych pakietów podczas przełączenia łączy.
Walidacja laboratoryjna architektury HA: Proces praktycznej weryfikacji poprawności konfiguracji protokołów wysokiej dostępności w kontrolowanym środowisku testowym przed ich wdrożeniem na działającej sieci produkcyjnej.
Dziękuję za uwagę

Praktyczne przećwiczenie konfiguracji protokołów LACP, RSTP oraz HSRP w środowiskach symulacyjnych (np. GNS3, EVE-NG lub Cisco Packet Tracer) pozwala na naoczne zaobserwowanie różnic w czasach konwergencji poszczególnych technologii.

Zrozumienie interakcji pomiędzy protokołami warstwy 2 (drzewo rozpinające, wiązki agregacyjne) a protokołami warstwy 3 (redundancja bramy domyślnej, protokoły routingu dynamicznego) stanowi fundament wiedzy każdego inżyniera projektanta sieci teleinformatycznych.

Skróty użyte w tym slajdzie:
HA – High Availability – wysoka dostępność systemów.
RSTP – Rapid Spanning Tree Protocol – szybkie drzewo rozpinające.
LACP – Link Aggregation Control Protocol – dynamiczna agregacja łączy.
HSRP – Hot Standby Router Protocol – protokół redundancji bramy Cisco.
ICMP – Internet Control Message Protocol – protokół komunikatów diagnostycznych (ping).

Podgląd